Aleph Alpha publie Kolibri, modèle à poids ouverts : MoE de 78,1 milliards de paramètres, 3,46 milliards activés par token
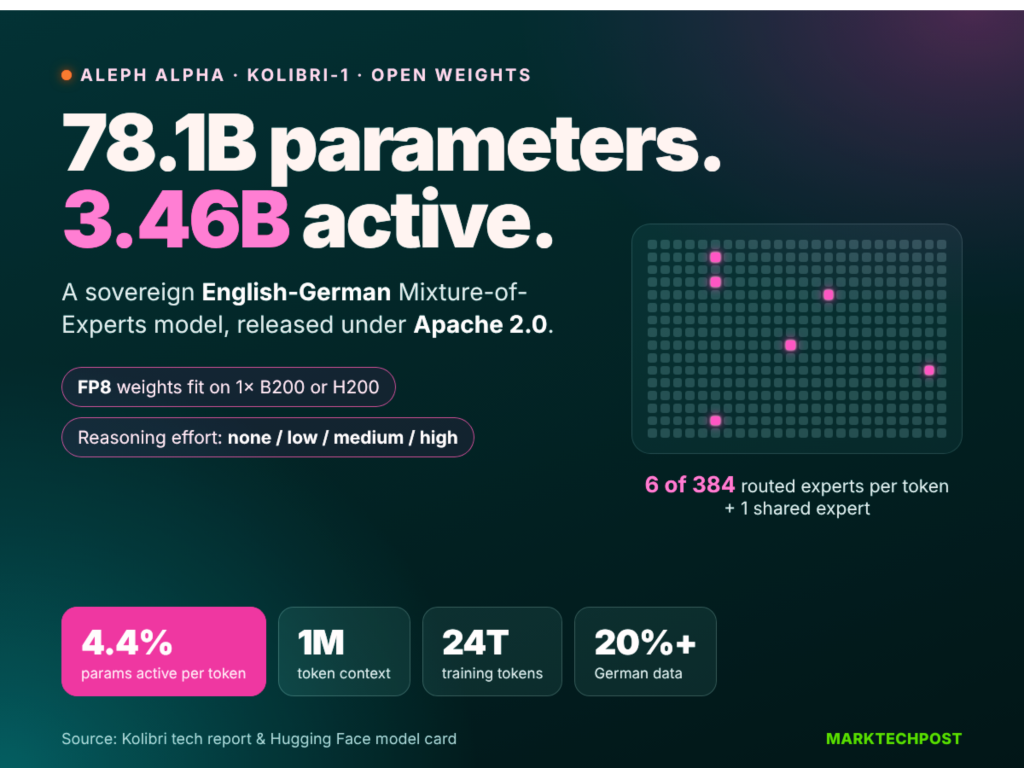
Selon un article de MarkTechPost du 4 octobre 2026, Aleph Alpha a publié Kolibri-1, un modèle MoE bilingue anglais-allemand à poids ouverts, avec 78,1 milliards de paramètres au total et seulement 3,46 milliards activés par token, prenant en charge un contexte allant jusqu'à 1 048 576 tokens et quatre niveaux d'intensité de raisonnement, publié sous licence Apache 2.0 sur Hugging Face, avec un point de contrôle FP8 d'environ 78 Go, déployable avec vLLM sur un seul B200 ou H200.
Ce qui change
Selon un article de MarkTechPost du 4 octobre 2026, l'équipe allemande Aleph Alpha a publié le modèle à poids ouverts Kolibri (Kolibri-1), présenté comme un modèle de langage à mélange d'experts (MoE) bilingue anglais-allemand, destiné à des déploiements souverains dans des secteurs réglementés comme l'administration publique, l'industrie et l'aérospatiale. L'article indique un total de 78,1 milliards de paramètres, avec seulement 3,46 milliards activés par token (environ 4,4 %) : chaque couche MoE utilise un routeur sigmoïde pour sélectionner les 6 meilleurs experts parmi 384 experts routés, plus 1 expert partagé, l'équilibrage de charge reposant sur Exact Quantile Balancing et Load-Error Injection. Le modèle empile 50 blocs Transformer, de largeur 2560, avec une attention par requêtes groupées de 48 têtes de requête et 4 têtes KV ; un bloc sur cinq est une attention complète sans encodage positionnel, les 40 autres blocs utilisant une attention à fenêtre glissante couvrant les 512 tokens précédents avec RoPE, de sorte que seules 10 couches de cache KV croissent avec le contexte. La limite de contexte rapportée est de 1 048 576 tokens, et l'intensité de raisonnement peut être réglée par requête sur aucun, faible, moyen ou élevé. Concernant l'entraînement, l'article rapporte un pré-entraînement sur 768 NVIDIA B200 couvrant 20T tokens, un entraînement intermédiaire de 3,44T tokens (longueur de séquence 65 536), une phase de contexte long de 201B tokens (longueur de séquence 262 144), avec plus de 2T tokens allemands supplémentaires ; le post-entraînement combine un ajustement supervisé et un apprentissage par renforcement sur plus de 1,2 million de tâches internes. La licence est Apache 2.0, les poids sont publiés sur Hugging Face ; le point de contrôle FP8 d'environ 78 Go peut être servi sur un seul B200, B300 ou H200, ou deux H100 SXM5, via vLLM avec un parseur d'inférence dédié et un parseur d'appel d'outils. Les comparaisons de benchmarks rapportées indiquent un score global de 75,5 en anglais et de 70,8 en allemand, et un score BFCL v4 de 61,4, inférieur au Qwen3.5 comparé. Ces paramètres, benchmarks et détails de déploiement proviennent du rapport original et du rapport technique cité, et n'ont pas encore été reproduits indépendamment.
Conséquences pour les développeurs
Du point de vue d'un développeur, l'intérêt de cette information se concentre sur trois points. Le premier est la combinaison licence et auto-hébergement : l'article indique que les poids sont publiés sous licence Apache 2.0, ce qui offre un espace d'autorisation plus clair que la pratique courante des « poids ouverts avec restrictions d'usage commercial », mais les conditions de licence doivent être vérifiées dans la carte du modèle Hugging Face et le texte original de la licence du dépôt, sans déduire des droits à partir du seul compte rendu ; il faut aussi noter que la disponibilité des poids ne signifie pas que les données d'entraînement, le tokenizer ou le paquet d'inférence sont soumis à la même licence. Le deuxième est la structure de coûts liée à la parcimonie : 78,1 milliards de paramètres au total et 3,46 milliards activés signifient que l'occupation de la mémoire est calculée sur les paramètres totaux et le coût de calcul sur les paramètres activés ; l'article indique qu'un point de contrôle FP8 d'environ 78 Go peut tourner sur un seul B200/H200, ce qui constitue un point de départ viable pour l'auto-hébergement pour les équipes disposant déjà d'un nœud mono-carte à grande mémoire, mais le débit et la charge simultanée réels dépendent de la bande passante mémoire, de la précision du cache KV et de la taille des lots, et doivent être testés. Le troisième est l'attention hybride et le contexte d'un million de tokens : les couches à fenêtre glissante maintiennent un cache KV fixe, seules 10 couches croissant avec le contexte ; l'équipe affirme que pour une puissance de calcul égale, la longueur de séquence prise en charge est quatre fois supérieure à celle d'une solution à attention complète. Si cela se vérifie, l'économie de contexte pour les documents longs et le RAG industriel serait nettement meilleure que celle de modèles denses de taille comparable ; mais il s'agit d'une déclaration du fournisseur, et il faut valider le contexte effectif sur sa propre distribution de documents plutôt que de se fier au seul chiffre de limite. En outre, la vocation bilingue anglais-allemand et le tokenizer optimisé pour l'allemand (l'article indique 4,90 octets par token en allemand, soit environ 11,2 % de tokens en moins que le tokenizer comparé) montrent que son domaine d'excellence est l'allemand ; une activité principalement en chinois ne devrait pas en déduire des capacités en chinois, l'article ne fournissant aucune évaluation dans cette langue. Il faut préciser que, lors de cette vérification du catalogue, la version Kolibri-1 n'apparaît pas dans le catalogue de modèles en direct de KimiSeek ; la disponibilité des poids et du service d'inférence mentionnée renvoie donc à la publication côté Aleph Alpha et Hugging Face, et non à une mise en ligne sur notre site.
Intégration et évaluation
Les éléments suivants sont des recommandations et analyses conditionnelles, non des faits établis. Recommandation 1 : décider d'abord selon les prérequis de licence et de conformité, puis selon les performances. Le choix concret consiste à vérifier le fichier LICENSE du dépôt Hugging Face, les restrictions d'usage dans la carte du modèle, ainsi que la licence du paquet d'inférence aleph-alpha-inference lui-même, avant de décider de l'intégrer comme dépendance de production. Lorsque la charge de travail implique le traitement local de données réglementées et que l'équipe dispose d'un nœud mono-carte de niveau B200/H200, l'auto-hébergement est plus intéressant que l'appel à une API externe ; si ce prérequis n'est pas rempli (par exemple, uniquement des cartes grand public ou plusieurs cartes à mémoire moyenne), il faut renoncer selon un critère quantifiable : le seuil de passage est le chargement réussi du point de contrôle FP8 sur le matériel cible avec une sortie stable ; un échec de chargement ou un besoin d'extension mémoire hors budget élimine le passage à l'étape suivante. Recommandation 2 : avant de changer ou d'introduire le modèle, réaliser une évaluation comparative avec les modèles existants sur son propre corpus allemand ou mixte anglais-allemand. Les variables clés à considérer sont le niveau d'intensité de raisonnement (aucun/faible/moyen/élevé) et la précision du cache KV, car ils modifient directement le coût et la latence par requête ; pour des tâches d'extraction de documents longs avec une tolérance élevée à la latence, augmenter l'intensité de raisonnement peut apporter un gain de qualité, tandis que pour des questions-réponses courtes à forte charge simultanée, une faible intensité avec des lots plus longs est plus économique. Le critère d'évaluation doit être mesurable : sur un ensemble fixe de 200 à 500 questions-réponses sur des documents longs en allemand, comparer la précision et la latence de bout en bout pour mille tokens à chaque niveau, et n'adopter un niveau plus élevé que si le gain de précision dépasse l'augmentation de latence et de coût. Recommandation 3 : la capacité de contexte long doit être validée en termes de « fenêtre effective » et non de limite maximale. Le choix concret consiste à démarrer avec le contexte par défaut de 262 144, puis à élargir progressivement via max-model-len et en surchargeant max_position_embeddings ; le prérequis est que la tâche nécessite réellement des dépendances continues sur plus d'un million de tokens ; si les résultats de recherche font déjà moins de cent mille tokens, augmenter la limite ne fera qu'accroître le coût du cache KV. Le critère quantifiable est de mesurer le rappel d'informations clés sur un gradient de longueur (par exemple 32k, 128k, 512k) ; si une baisse nette apparaît à une certaine longueur, utiliser comme limite effective les longueurs inférieures à ce seuil. Recommandation 4 : les appels d'outils et les scénarios d'agent doivent être testés en charge séparément. L'article indique un score BFCL v4 inférieur au modèle Qwen comparé, tandis que la moyenne agentique est proche de celle des concurrents, ce qui suggère que les écarts peuvent être importants selon les sous-tâches d'agent ; le choix concret est de conserver le modèle existant comme chaîne principale pour les appels d'outils et d'utiliser Kolibri pour la recherche et la génération en allemand, ou l'inverse. Le prérequis est que l'équipe dispose déjà d'un ensemble de tests de régression pour les appels d'outils ; le critère quantifiable est le taux de réussite des appels et l'exactitude des paramètres sur son propre schéma d'outils ; s'ils sont nettement inférieurs au modèle actuel, ne pas migrer la chaîne principale.
Limites et points à confirmer
Premièrement, il faut le préciser clairement : lors de cette vérification du catalogue, Kolibri-1 n'apparaît pas dans le catalogue de modèles en direct de KimiSeek ; les poids, le paquet d'inférence et le mode de déploiement décrits ici renvoient à la publication d'Aleph Alpha et de Hugging Face, et ne signifient pas que notre site propose ce modèle ; toute mention de disponibilité d'API dans l'article ne concerne que le côté fournisseur et ne doit pas être interprétée comme un service de notre site. Deuxièmement, tous les chiffres d'architecture, d'entraînement, de benchmarks et de déploiement de cet article proviennent de l'article de MarkTechPost du 4 octobre 2026 et du rapport technique et de la carte du modèle cités, sans reproduction indépendante ; les comparaisons de benchmarks utilisent une configuration d'évaluation interne du fournisseur, dont la comparabilité entre modèles est limitée et ne doit pas servir de seule base de choix. Troisièmement, l'article ne fournit pas de détails de validation indépendante pour le chinois, le code ou les scénarios à contexte long ; les capacités dans des langues autres que l'anglais et l'allemand sont inconnues ; l'affirmation d'une « longueur de séquence quatre fois supérieure à puissance de calcul égale » est une déclaration de l'équipe et doit être vérifiée par soi-même. Quatrièmement, Apache 2.0 est une déclaration de licence pour les poids publiés ; son champ d'application précis (poids, tokenizer, paquet d'inférence, données d'entraînement) doit être vérifié point par point dans la licence originale et la carte du modèle, et l'on ne peut pas déduire de « poids ouverts » l'étendue des autorisations pour tous les composants. Cinquièmement, la possibilité d'exécution sur une seule carte et l'utilisation en production sont deux choses différentes ; la charge simultanée de pointe, la marge de mémoire et l'impact des niveaux d'intensité de raisonnement sur le coût doivent être mesurés sur le matériel cible. Sixièmement, les prix, limites et paramètres d'échantillonnage recommandés dans l'article sont des informations au moment de la publication et peuvent évoluer avec les versions ultérieures ; il convient de se référer au contenu le plus récent des pages du fournisseur et de Hugging Face.