Baidu dévoile Apollo World : quand le modèle du monde devient l’examinateur de la conduite autonome, que doivent mesurer les développeurs
Le 3 novembre, à Shenzhen, lors de l’AI Day consacré à Apollo, Baidu a dévoilé pour la première fois Apollo World, un modèle du monde, et présenté un cadre « 2+3 » fondé sur la causalité, l’interactivité et la précision physique, la persistance et le temps réel ; il serait déjà utilisé pour les tests de déploiement mondial d’Apollo Go, le service de robotaxi de Baidu. Cet article distingue faits rapportés et inférences, avec des jugements conditionnels sur la base de simulation, les critères d’acceptation et le budget temps réel.
Ce qui change
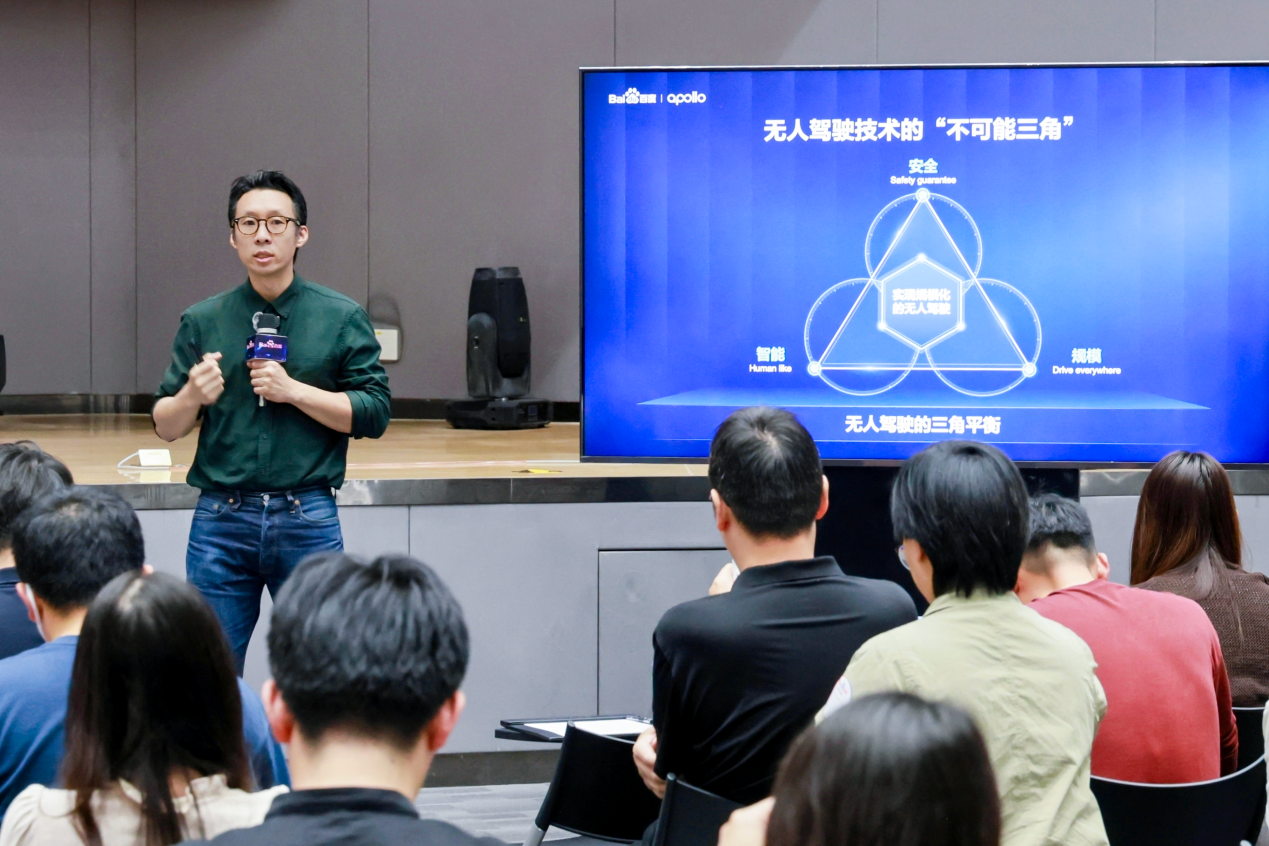
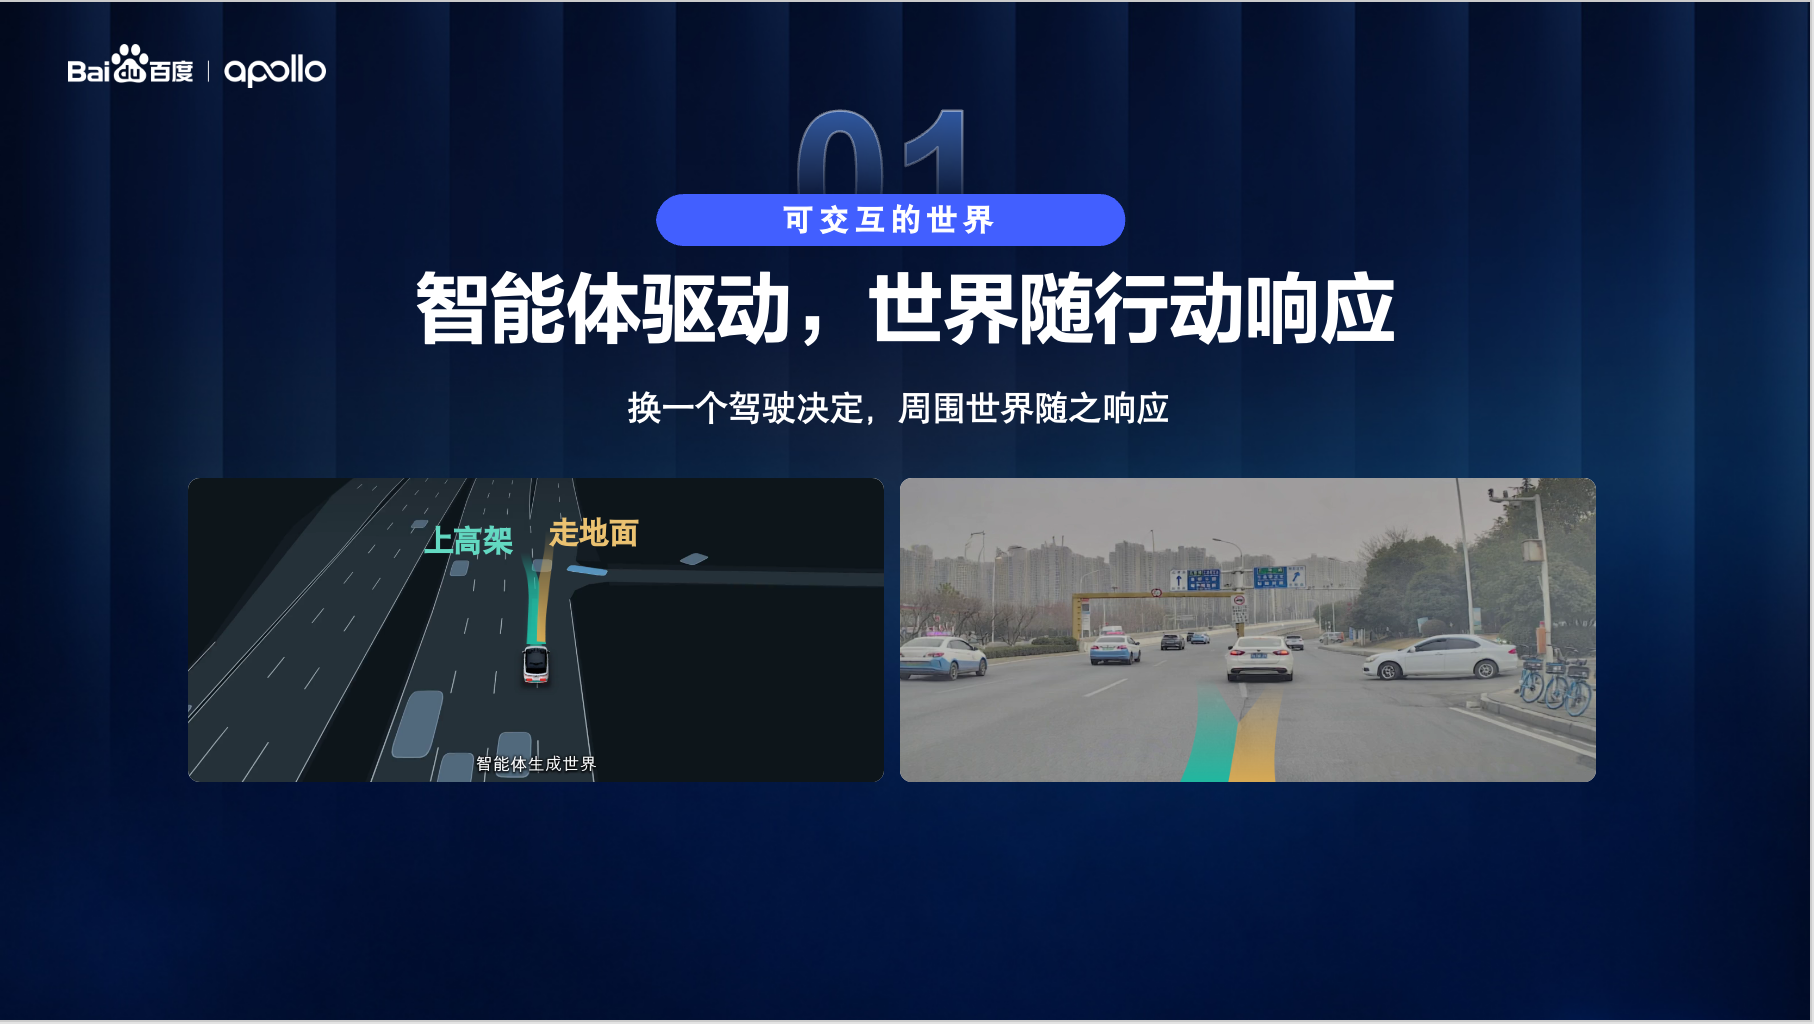
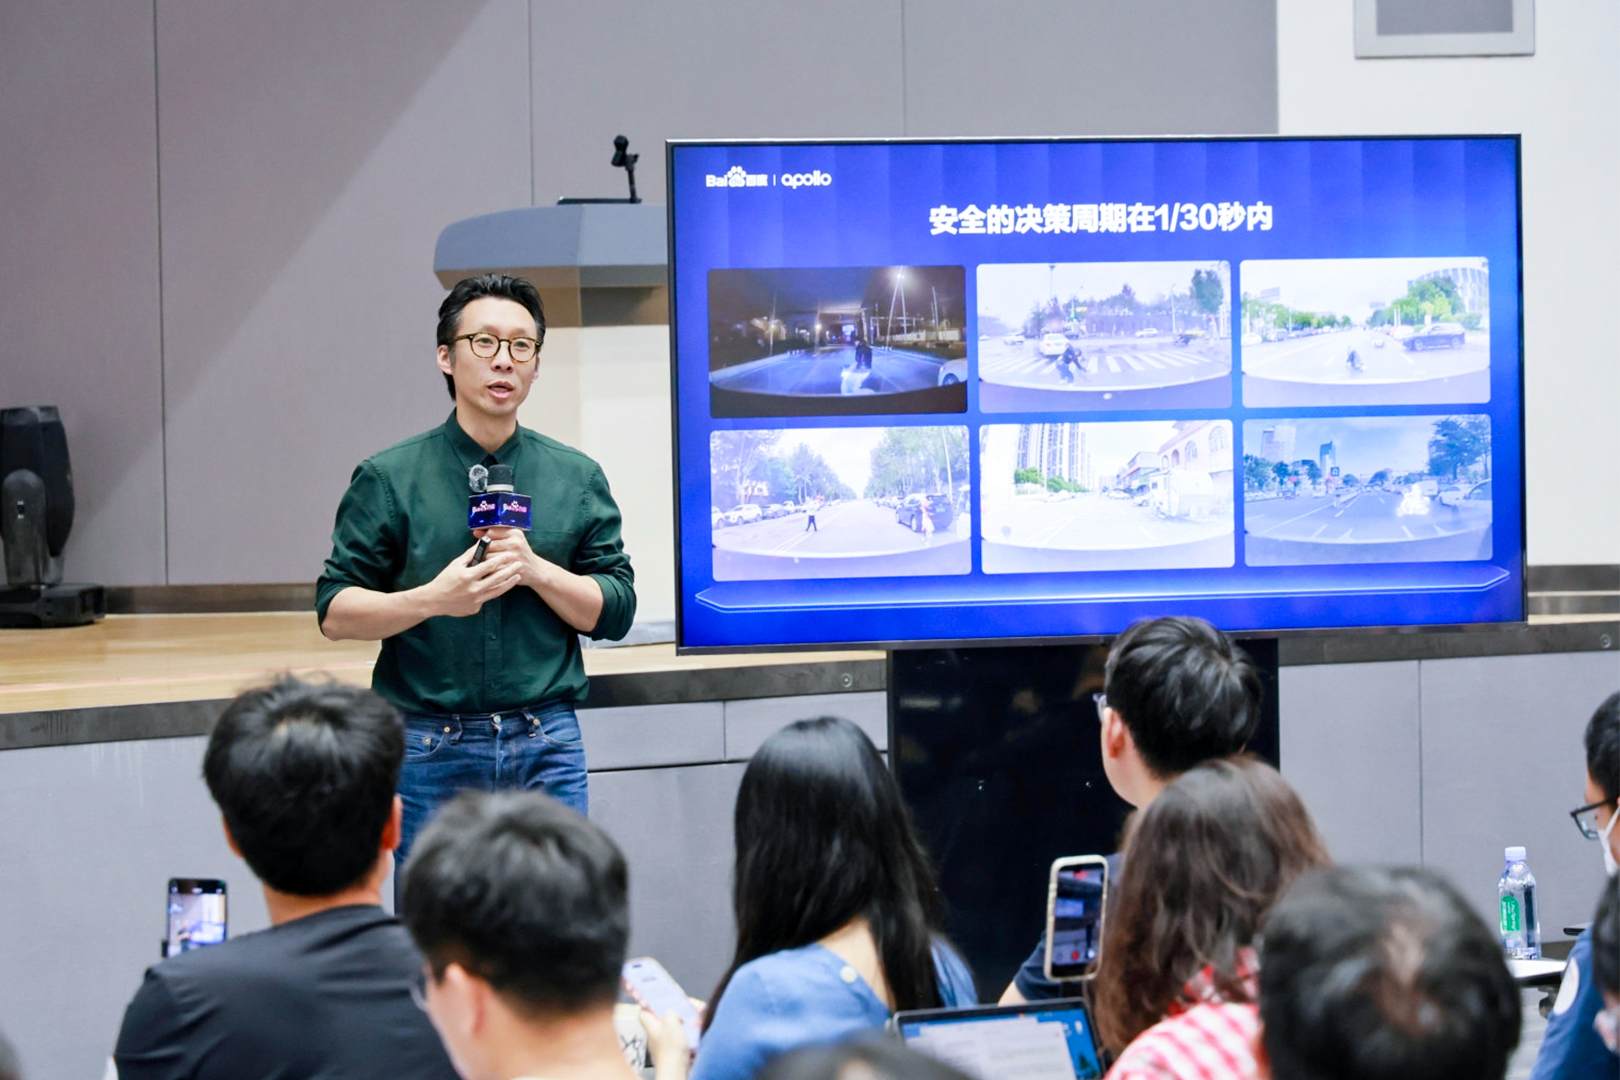
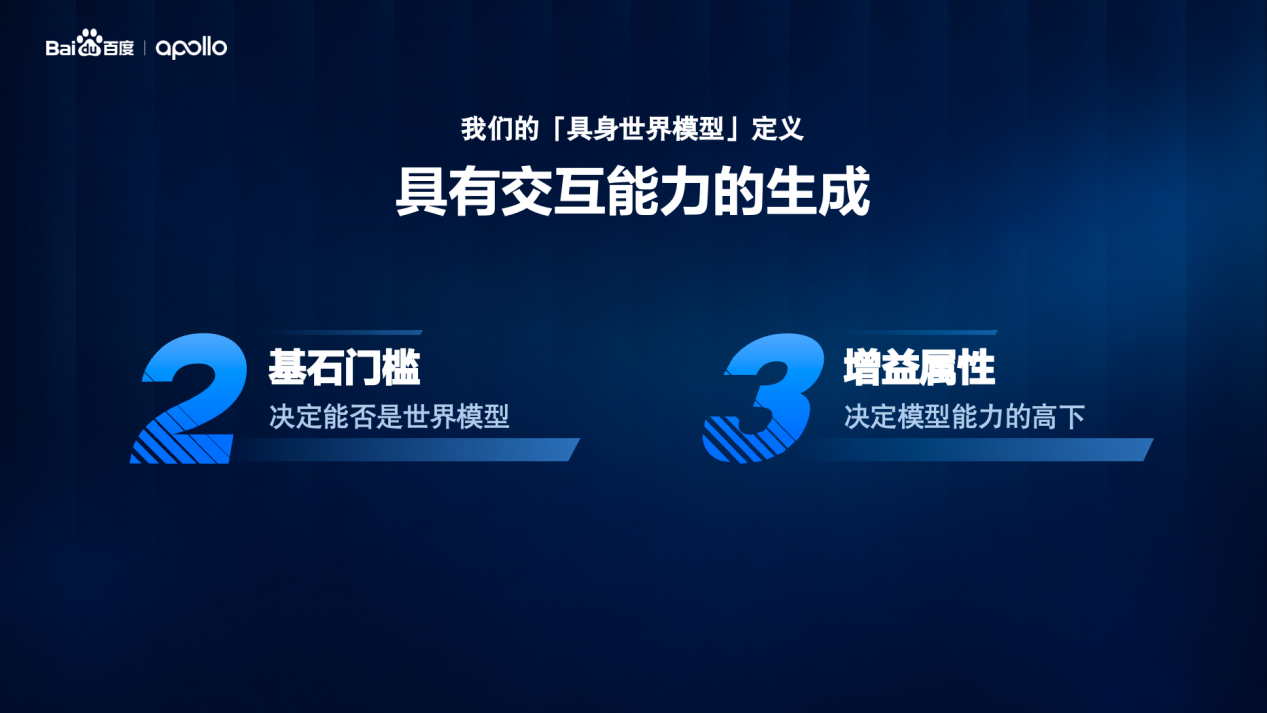
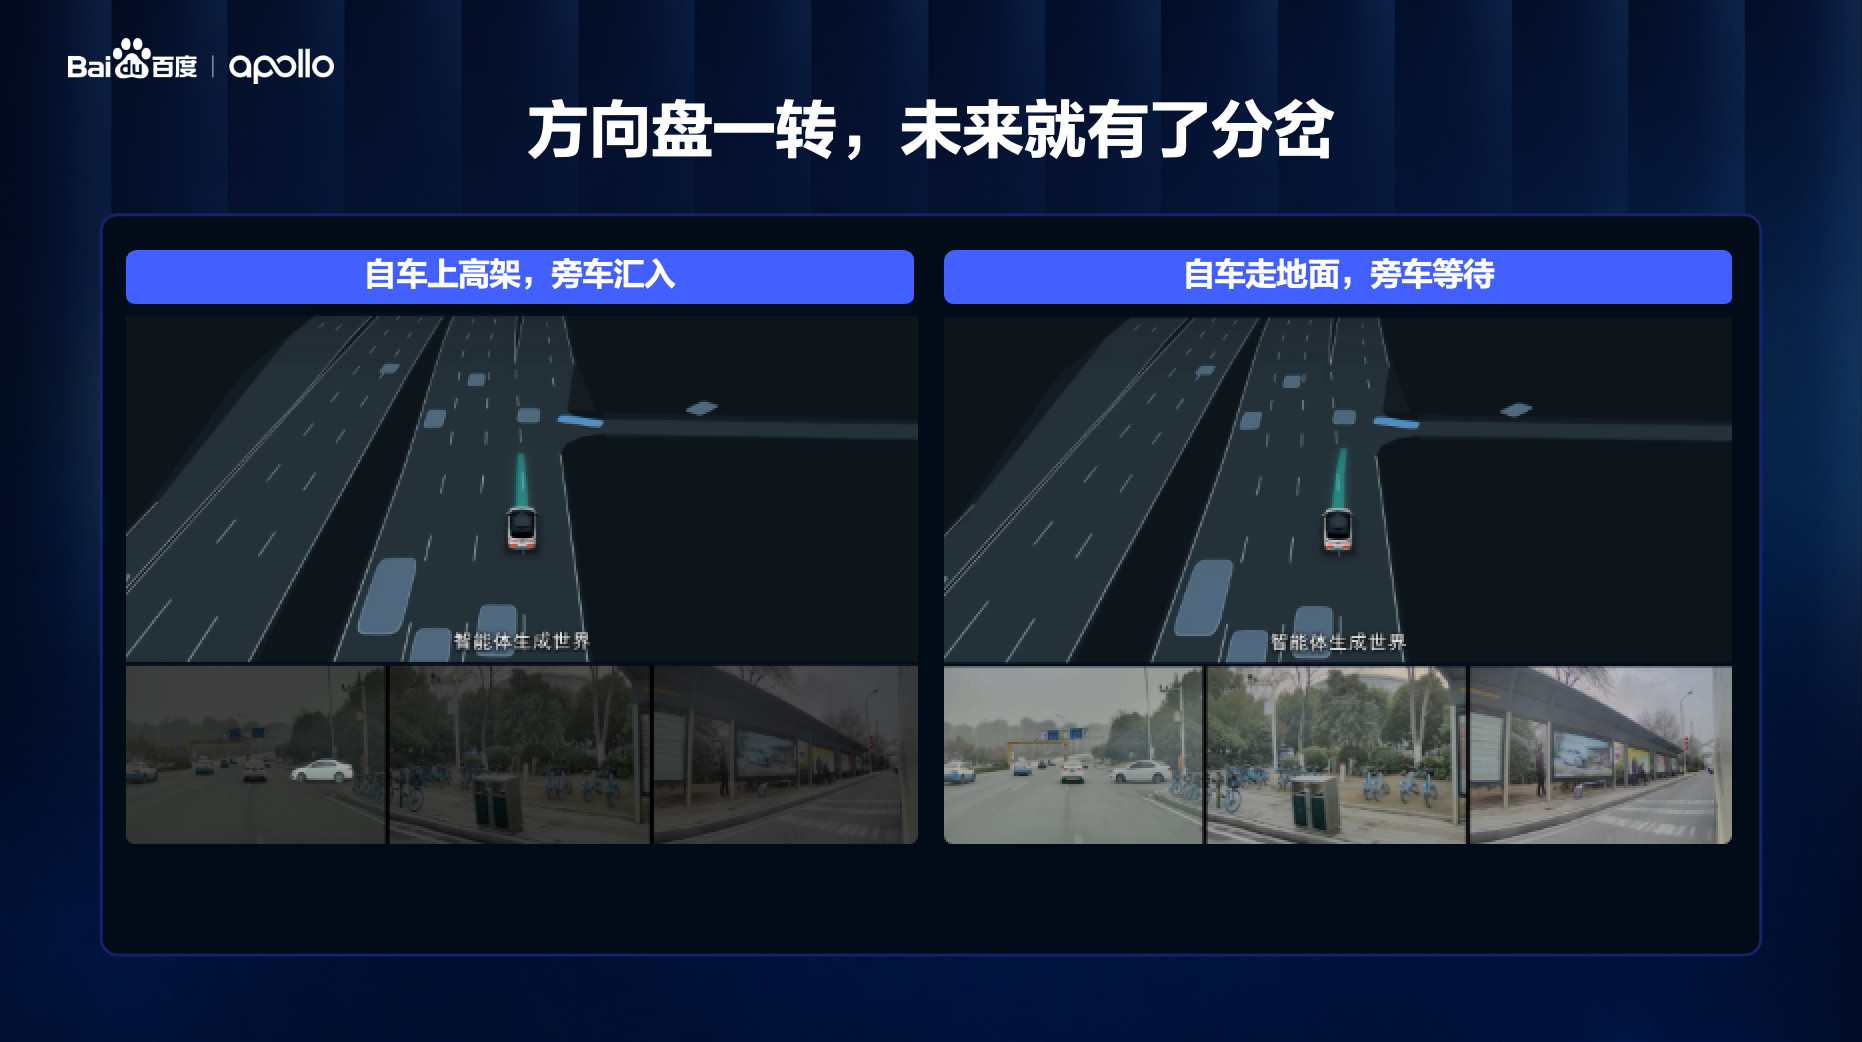
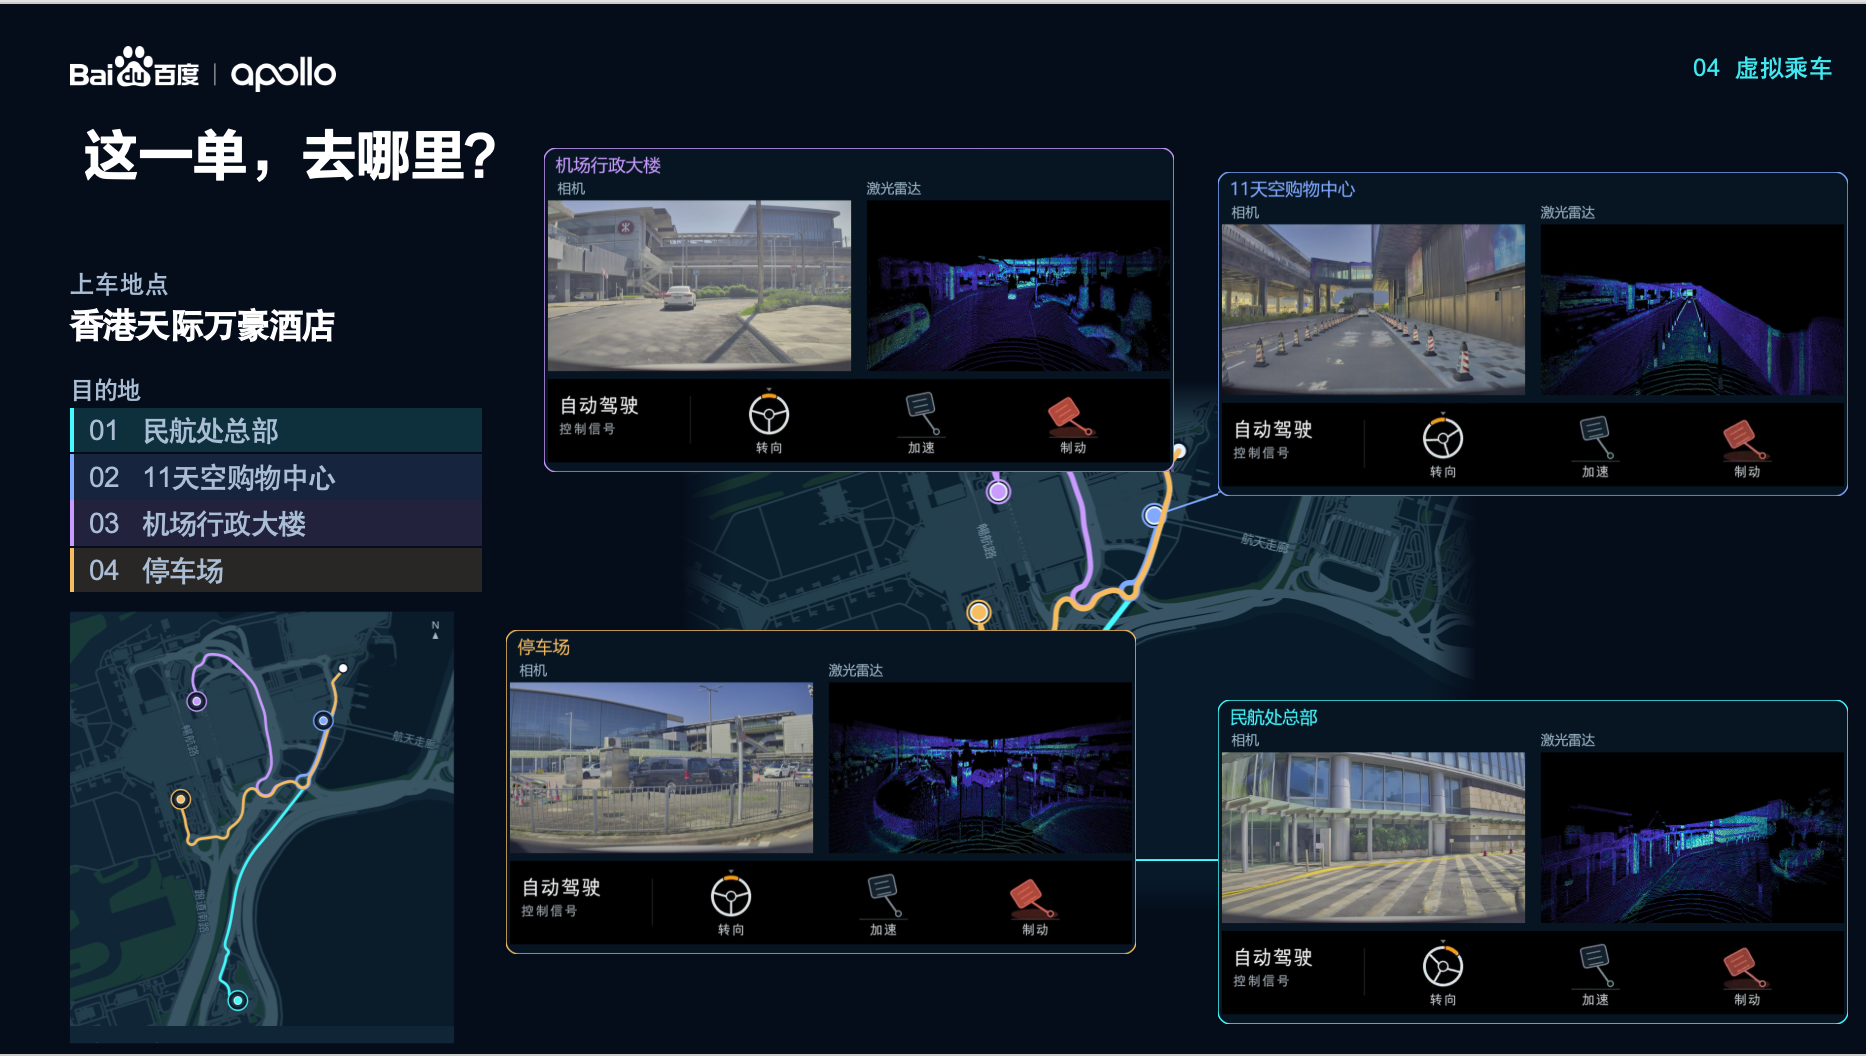
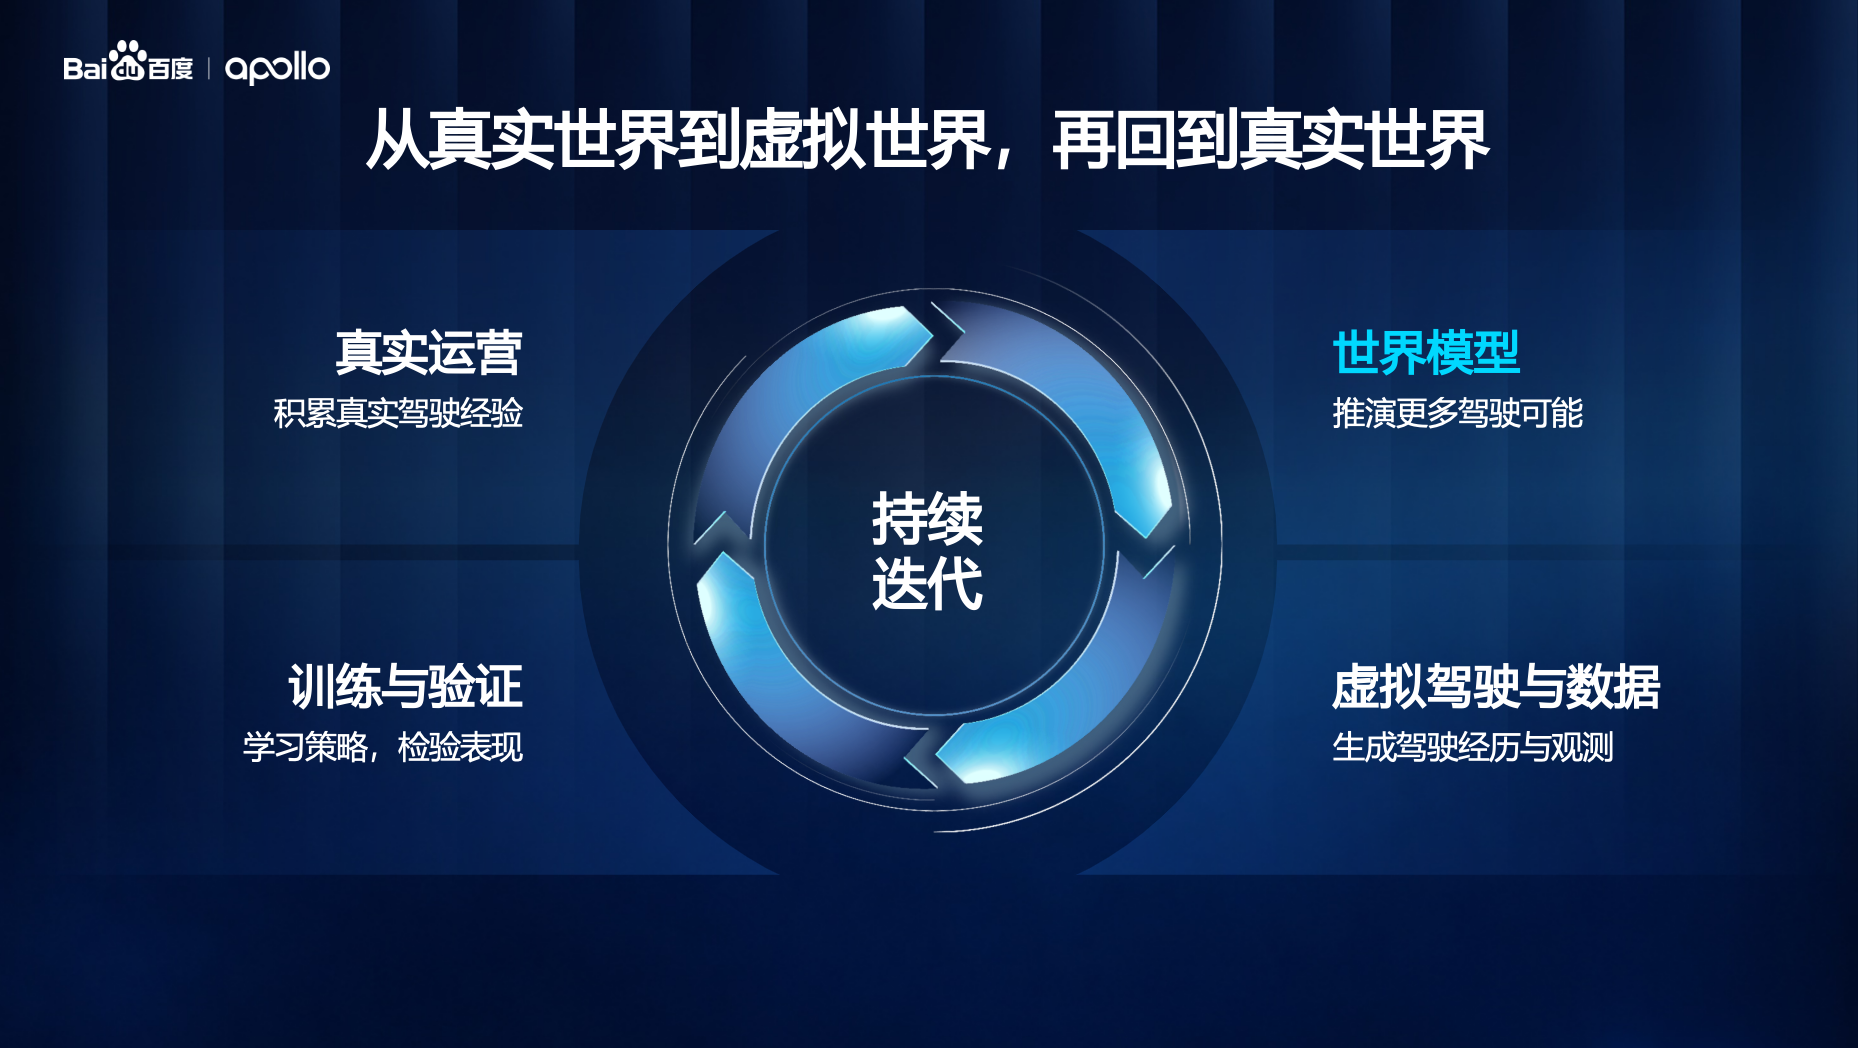
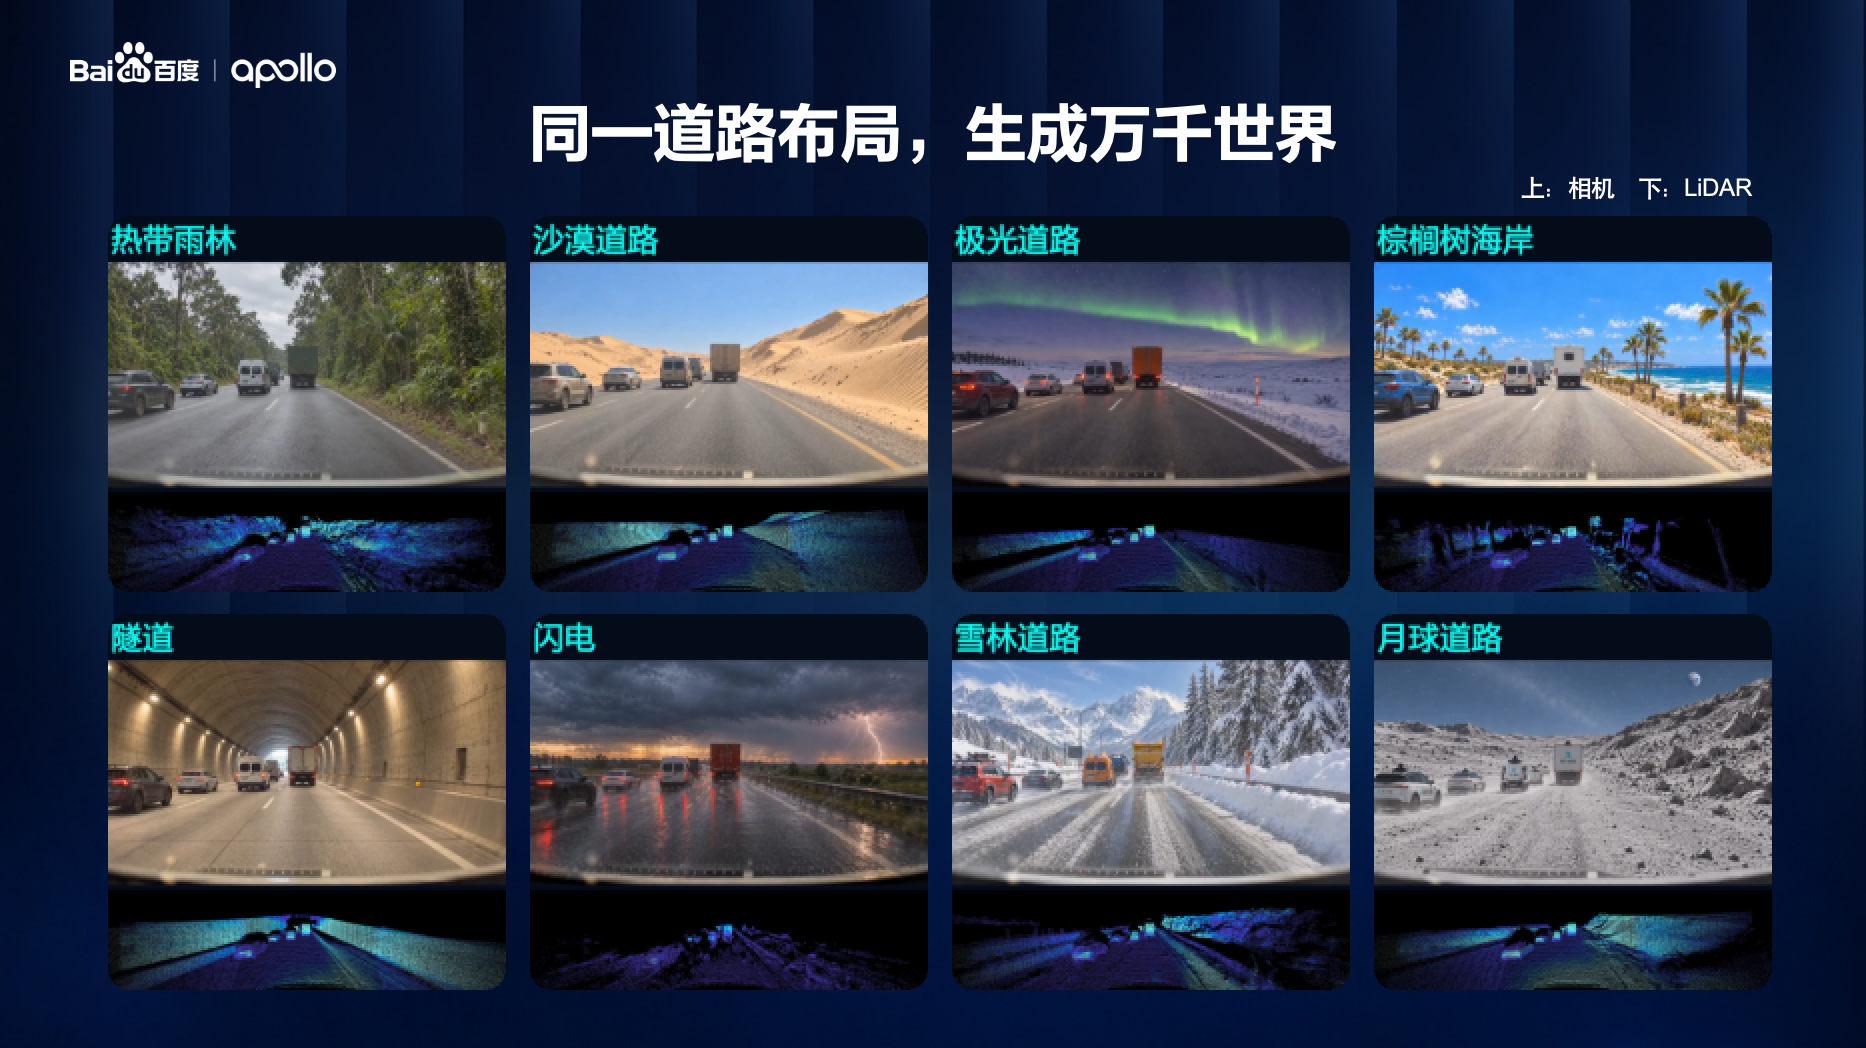
Selon InfoQ Chine, le 3 novembre, lors de l’AI Day · Apollo organisé à Shenzhen, Baidu a dévoilé pour la première fois Apollo World, un modèle du monde destiné à l’IA physique, et proposé un cadre d’évaluation « 2+3 » pour les modèles du monde. Le « 2 » correspond à deux seuils de base : la causalité, qui exige que le modèle respecte le caractère unidirectionnel du temps et déduise l’instant suivant à partir de l’état actuel, au lieu de reconstituer le passé à partir d’images assemblées ; l’interactivité, qui exige que des actions injectées de l’extérieur puissent modifier l’état futur du monde. Le « 3 » correspond à trois indicateurs avancés : la précision physique, la persistance sur longue durée (dérive ou non des objets et des détails), et le temps réel, c’est-à-dire un temps d’inférence qui n’augmente pas lorsque la complexité de la scène croît. Wang Liang, architecte en chef d’IDG chez Baidu, a déclaré qu’un modèle du monde ne devait pas être seulement un « peintre » générant des vidéos, mais un « examinateur » chargé de valider la sécurité de la conduite autonome ; le reportage indique que le cycle de décision de sécurité sur route ouverte doit être limité à 1/30 de seconde. Yang Ze, responsable d’Apollo World, a expliqué que, dans la ville virtuelle, les véhicules et les piétons sont modélisés comme des agents dotés de capacités de décision et d’interaction, capables de générer en temps réel des observations multimodales (caméra, lidar, etc.) directement exploitables par la perception embarquée, et de prendre en charge une boucle complète de trajet, de la prise de commande au transport du passager puis à la dépose, entre n’importe quel point de départ et d’arrivée, plutôt qu’une simulation de scènes isolées. Le reportage indique que ce modèle a déjà été utilisé pour les tests et la validation du déploiement mondial d’Apollo Go, le service de robotaxi de Baidu, et que sa pile technologique peut aussi être étendue à des scènes d’IA physique comme la robotique.
Conséquences pour les développeurs
Pour la plupart des développeurs, la partie exploitable de cette annonce n’est pas « un modèle appelable de plus », mais le fait qu’elle transforme la question du modèle du monde, d’un problème d’apparence visuelle en un problème d’ingénierie mesurable. Le reportage précise qu’Apollo World sert à l’entraînement et à la validation de la conduite autonome de bout en bout de Baidu lui-même, sans fournir d’interface publique ni de poids ; à court terme, cela ne modifiera donc la liste de choix d’API de personne. Mais les critères proposés vont se diffuser dans la simulation et l’évaluation : si « la complexité augmente sans que le temps d’inférence croisse » est retenu comme indicateur contraignant, l’entrée d’un modèle du monde dans une simulation en boucle fermée aura un seuil d’admission explicite ; si « les participants au trafic sont des agents qui réagissent » est accepté, l’évaluation fondée sur le rejeu de journaux révélera des angles morts de couverture. Pour les équipes qui travaillent sur l’intelligence incarnée, la simulation de conduite autonome ou les pipelines de données synthétiques, cette décomposition peut être reprise directement comme grille de revue interne. À l’inverse, les indicateurs étant proposés par la partie évaluée, ils penchent naturellement vers ses points forts ; la précision physique et la persistance sont précisément les plus difficiles à quantifier, et une copie naïve risque de produire une liste d’acceptation « complète en apparence, mais incapable de mesurer une différence réelle ».
Intégration et évaluation
Je suggère de faire correspondre chacune des trois catégories de changements mentionnées dans le reportage à une décision, en écrivant à l’avance les critères. Premièrement, les participants interactifs : le reportage indique que les autres usagers de la route ont des capacités de décision et d’interaction. Il s’agit de décider si la base de simulation doit passer du rejeu de journaux à des agents interactifs. Condition : que le mode de défaillance visé dépende lui-même du jeu (virage non protégé, insertion, cédez-le-passage) et qu’une base de référence par rejeu existe pour comparaison. Critère : exécuter les deux modes sur le même lot de scènes, comparer le nombre de collisions et de quasi-accidents aux cent kilomètres, ainsi que la proportion d’arrêts prolongés ou de tentatives répétées du véhicule ego ; le passage au mode interactif ne se justifie que si celui-ci révèle nettement plus de défaillances et que leur orientation concorde avec les reprises enregistrées sur véhicule réel. Deuxièmement, la boucle complète de trajet : le reportage insiste sur une tâche continue à travers plusieurs tronçons, plutôt que sur des scènes isolées. Il s’agit de décider si le critère d’acceptation passe du taux de réussite par scène au taux d’achèvement de trajets continus. Condition : que le système soit de bout en bout et que l’erreur s’accumule avec le temps. Critère : compter le taux d’achèvement et le nombre de reprises par trajets virtuels de plusieurs dizaines à une centaine de kilomètres, et segmenter par tronçon pour faire des régressions afin de localiser le point où l’erreur commence à s’accumuler ; si le score par scène progresse alors que le taux d’achèvement des trajets continus ne bouge pas, l’indicateur n’a pas capté le vrai problème. Troisièmement, le budget temps réel : le reportage classe comme indicateur le fait que « la croissance de la complexité n’affecte pas le temps d’inférence ». Il s’agit de décider si le modèle du monde entre dans la boucle fermée ou sert seulement à l’augmentation hors ligne des données. Condition : simulation en boucle fermée et matériel dans la boucle. Critère : mesurer la latence p99 par pas lorsque le nombre d’agents et de modalités de capteurs augmente ; dès que le budget du cycle de décision est dépassé, il faut limiter la complexité de la scène ou revenir hors ligne, sinon les conclusions de la boucle fermée ne sont pas fiables. Par ailleurs, le reportage isole la dérive sur longue durée ; je suggère de fixer une durée maximale par rollout, d’observer l’identité et la cohérence géométrique des mêmes participants en prenant les heures simulées comme axe, et de réinitialiser au-delà du seuil. Tout ce qui précède est une recommandation conditionnelle fondée sur le reportage, et non la méthode divulguée par Baidu.
Limites et points à confirmer
Apollo World ne figure pas actuellement dans le catalogue de modèles de KimiSeek, et le reportage ne mentionne ni API publique, ni poids ouverts, ni aucune clause de licence ; il s’agit d’une installation interne d’entraînement et de validation de Baidu, et toute disponibilité future d’une interface externe, ses conditions et sa facturation dépendront de Baidu. Le reportage ne donne aucun résultat quantitatif sur la fidélité, la latence ou la dérive du modèle du monde ; les mentions « cent mille kilomètres par jour » et « équivalent à environ trois ans de tests continus d’un véhicule d’essai réel » sont présentées comme des analyses d’analystes du secteur, et non comme des mesures réelles de Baidu : ce sont des analogies, pas des mesures. La conversion du kilométrage virtuel en sécurité réelle n’est étayée que par un récit de boucle fermée du côté de l’entreprise, sans données indépendantes de validation sim-to-real. Le cadre dit « 2+3 » est défini par son promoteur, ce qui expose une grille d’acceptation à un risque de biais ; la précision physique et la persistance manquent de seuils opérationnels. Les affirmations « plus d’un million de kilomètres d’exploitation entièrement sans conducteur de bout en bout » et « seul en Chine à faire fonctionner à l’échelle une L4 fondée sur une technologie de bout en bout » sont des déclarations de l’entreprise, sans vérification tierce. L’extension à la robotique et à d’autres scènes est décrite comme une pile technologique « extensible », et non comme une capacité déjà démontrée. La prévision de taille de marché de l’IA physique citée dans l’article provient d’un institut de recherche tiers et n’a pas de lien direct avec les capacités du modèle.
Illustrations de l’article original