Cantina publie apex-flash-1, un modèle à poids ouverts pour la recherche de vulnérabilités, affiné à partir de GLM-5.3-Flash : 40 tâches résolues sur 60
Selon un article de MarkTechPost du 4 octobre 2026, Cantina Security, avec Yeta Labs, a publié le modèle à poids ouverts apex-flash-1, affiné par GRPO sur GLM-5.3-Flash, distribué sous licence MIT sur Hugging Face, avec 40 tâches de vulnérabilité résolues sur 60 selon l'auto-évaluation et environ 640 Go de mémoire GPU requise pour les poids BF16.
Ce qui change
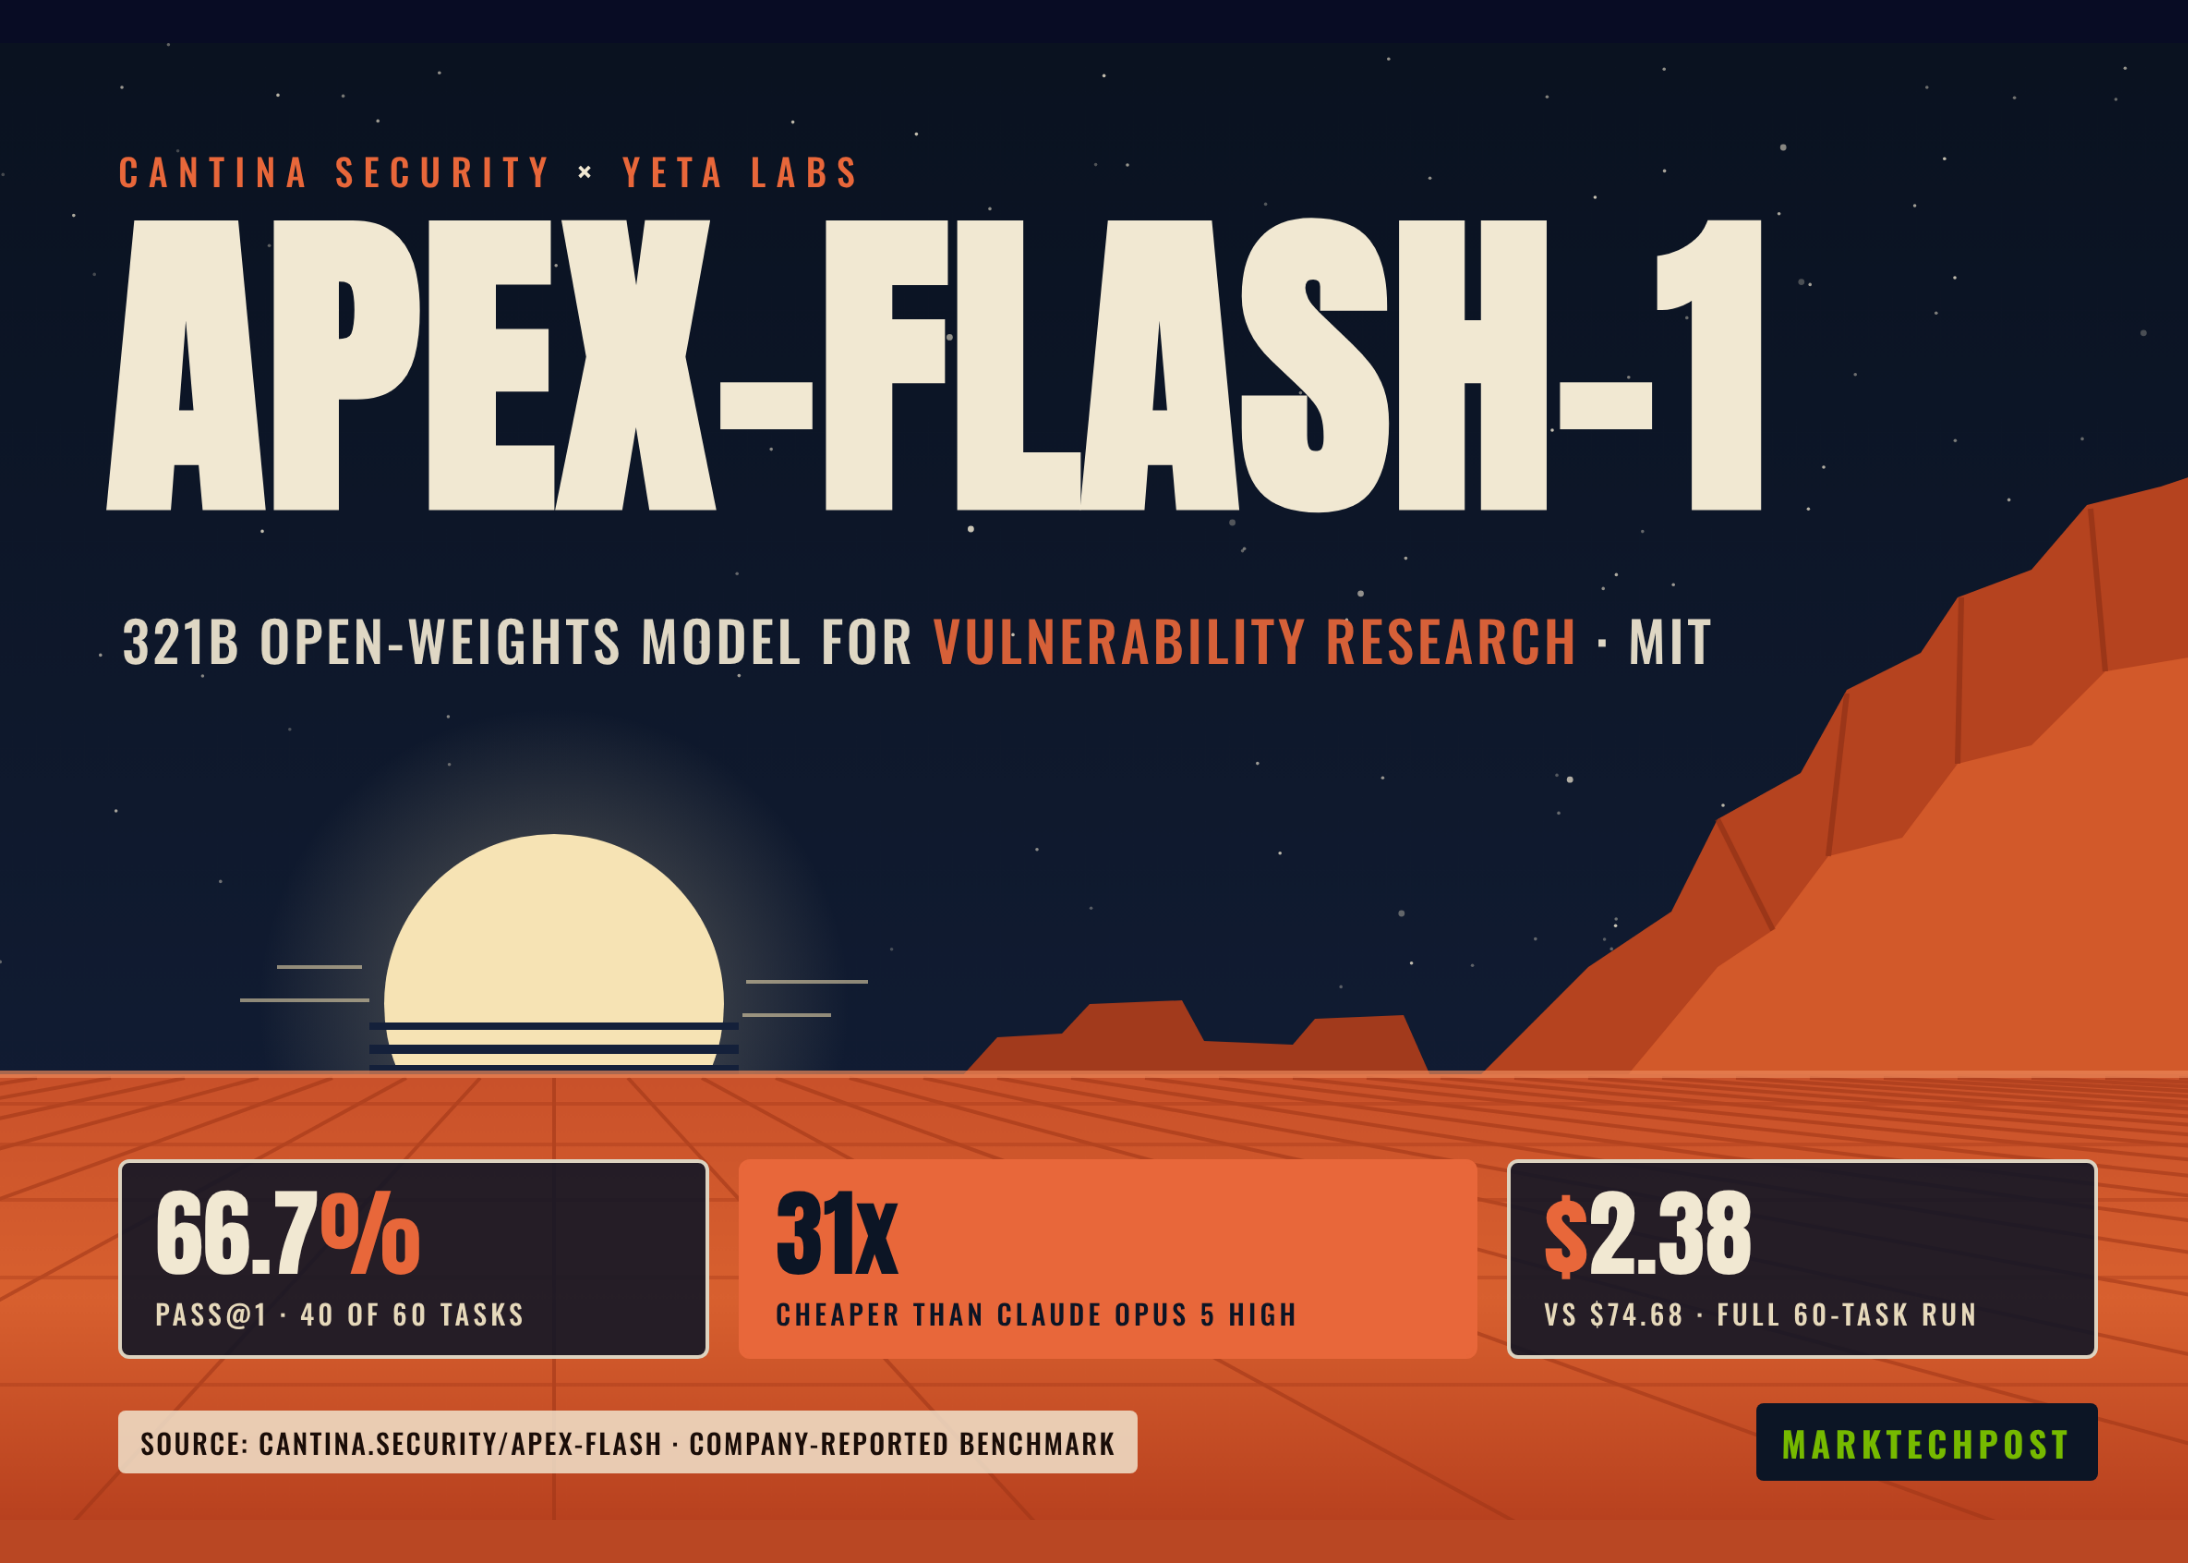
Selon un article de MarkTechPost du 4 octobre 2026, Cantina Security, avec Yeta Labs, a publié apex-flash-1. Ce modèle résulte d'un affinage par apprentissage par renforcement de GLM-5.3-Flash de Z.ai (MoE, environ 320 milliards de paramètres au total, 18 milliards activés), et ses poids sont publiés sur Hugging Face sous licence MIT. L'article indique un total de 321,3 milliards de paramètres, un entraînement utilisant GRPO, un LoRA de rang 256 et un entraînement sélectif de tous les paramètres ; les données proviennent de 150 tâches dérivées de 50 cas réels de vulnérabilité, chaque cas comportant trois variantes : boîte blanche guidée, boîte blanche ciblée et boîte noire ciblée. Parmi les types de cas, les défauts d'autorisation, d'identité et de portée des privilèges représentent 72 %, les problèmes de comptabilité et de précision numérique 18 %, le reste étant des contrôles temporels, des règles métier et des cas de SSRF. L'article cite la fiche du modèle indiquant que les rollouts s'exécutent dans le harnais d'agent Codex. Pour l'évaluation, Cantina a sélectionné 60 tâches parmi 20 cas de validation, avec une exécution par modèle : apex-flash-1 en a résolu 40/60 (66,7 % pass@1, environ 2,38 dollars), le modèle de base GLM-5.3-Flash 36/60 (60,0 %, environ 4,56 dollars) et Claude Opus 5 High 43/60 (71,7 %, environ 74,68 dollars). L'article mentionne aussi une variante expérimentale apex-flash-1-abliterated, dont le comportement de refus a été modifié et qui n'a pas été évaluée séparément. Cantina le positionne comme un modèle de travail orchestré par un modèle plus grand, destiné aux scénarios de défense en déploiement local contrôlé. Il convient de préciser que ces benchmarks et coûts sont des données internes auto-déclarées par l'éditeur.
Conséquences pour les développeurs
L'impact pour les développeurs se divise en trois niveaux. Le premier concerne la licence et les limites d'usage : l'article indique que les poids sont publiés sous licence MIT, ce qui est différent de la simple « disponibilité au téléchargement des poids » — MIT est une clause de licence, avec une voie relativement claire pour l'usage commercial et la redistribution, mais il faut se référer au LICENSE et au NOTICE du dépôt officiel ; l'article ne détaille pas s'il existe une politique d'usage séparée. Le deuxième concerne la structure des coûts de déploiement : l'article indique qu'environ 640 Go de mémoire GPU sont nécessaires pour les poids BF16, ce qui n'est pas un ordre de grandeur tenable sur une seule carte ; l'auto-hébergement exige des nœuds multi-GPU ou un portage quantifié ; l'article mentionne qu'un portage 4 bits existe déjà dans la communauté, mais sans évaluation de qualité ; l'effet de la quantification sur les tâches d'exploitation de vulnérabilités est une inconnue, à vérifier soi-même. Le troisième concerne l'adéquation aux tâches : 72 % des données d'entraînement sont concentrées sur les défauts d'autorisation, d'identité et de portée des privilèges ; les performances sur ces tâches ne peuvent pas être extrapolées aux vulnérabilités de sécurité mémoire, de concurrence, de cryptographie ou de chaîne d'approvisionnement. L'évaluation doit être stratifiée par catégorie de défaut plutôt que de se limiter au pass@1 global. En outre, l'article positionne ce modèle comme un « modèle de travail » orchestré par un modèle plus grand, ce qui suggère que son mode d'intégration prévu est un maillon d'exécution dans un harnais d'agent ; le degré d'alignement des interfaces et des protocoles d'appel d'outils affectera directement son utilisabilité. Concernant l'état actuel du catalogue : apex-flash-1 n'a pas de correspondance exacte dans le catalogue en temps réel de KimiSeek ; pour appeler son modèle de base GLM-5.3-Flash, une entrée du même nom existe dans le catalogue, mais ces informations de catalogue ne font qu'indiquer la disponibilité actuelle et ne peuvent servir de preuve pour les benchmarks, prix ou poids mentionnés dans l'article.
Intégration et évaluation
Ce qui suit relève de recommandations et d'analyses conditionnelles, non de faits rapportés dans l'article. Recommandation 1 : commencer par une comparaison sur petit échantillon par catégorie de défaut avant de décider d'investir dans l'auto-hébergement. Le changement concret rapporté est que 72 % des données d'entraînement se concentrent sur les défauts d'autorisation, d'identité et de portée des privilèges ; la décision correspondante est de choisir apex-flash-1 ou le modèle de base GLM-5.3-Flash, sous réserve que les tâches cibles relèvent de ces catégories ; le critère d'évaluation mesurable est de comparer la différence de pass@1 sur 20 à 30 tâches d'autorisation de votre propre jeu de validation ; si l'amélioration est inférieure à environ 5 points de pourcentage, cela ne justifie pas le coût opérationnel supplémentaire d'un déploiement multi-GPU. Recommandation 2 : fixer un seuil de taux de réussite des appels d'outils pour l'intégration d'agent. L'article indique que les rollouts s'exécutent dans le harnais d'agent Codex et liste comme capacités cibles la lecture de code, l'appel d'outils, le développement et la validation d'exploits ; la décision correspondante est de l'utiliser comme exécutant plutôt que comme planificateur dans l'agent, sous réserve que le schéma des outils de votre harnais soit proche de son environnement d'entraînement ; le critère d'évaluation mesurable est de compter le taux de conformité de format et le taux d'achèvement de bout en bout sur 50 appels d'outils réels ; si le taux de conformité de format est inférieur à environ 95 %, ajoutez d'abord une couche de vérification des sorties avant l'intégration. Recommandation 3 (conditionnelle) : faut-il choisir un portage communautaire 4 bits en cas de mémoire GPU insuffisante. L'article mentionne un portage 4 bits existant mais sans données de qualité ; la décision correspondante est d'arbitrer entre attendre une quantification officielle et adopter le portage communautaire, sous réserve que vos tâches soient plus sensibles à la précision numérique ou au débit ; le critère d'évaluation mesurable est d'exécuter le même ensemble de 60 tâches avant et après quantification et de comparer l'ampleur de la baisse du nombre de résolutions ; si la baisse dépasse 3 à 5 tâches, le portage ne convient pas pour remplacer directement le BF16 dans la validation automatisée de vulnérabilités.
Limites et points à confirmer
Toutes les données de benchmark (66,7 % pass@1, 40/60, environ 2,38 dollars, etc.) sont des résultats internes auto-déclarés par Cantina ; l'échantillon provient de 20 cas de validation, soit 60 tâches au total, une taille réduite dont la distribution des types de tâches n'est pas entièrement publiée, et aucun tiers ne les a reproduits. L'article ne divulgue pas les règles de notation de l'évaluation, la possibilité de plusieurs tentatives ni le critère de « résolution » ; la signification de pass@1 peut varier selon l'implémentation. La variante apex-flash-1-abliterated n'a pas été évaluée séparément et l'impact de la modification de son comportement de refus sur la sécurité est totalement inconnu. Concernant les besoins matériels, le corps de l'article indique environ 640 Go, le tableau comparatif environ 642 Go et le tableau des paramètres 328 Go pour le BF16 : ces chiffres divergent ; lors du choix, il faut se fier à la taille réelle des fichiers de poids du dépôt officiel ; le portage communautaire 4 bits n'a pas de données de qualité. Pour la vérification du catalogue de cette édition, la version apex-flash-1 n'apparaît pas actuellement dans le catalogue en temps réel de KimiSeek ; toute disponibilité d'API ou coût d'appel mentionné dans cet article renvoie à l'éditeur ou à un fournisseur tiers et ne signifie pas qu'il est directement appelable sur cette plateforme ; son modèle de base GLM-5.3-Flash possède une entrée du même nom dans le catalogue, mais ces informations de catalogue ne reflètent que la disponibilité actuelle et ne constituent pas une preuve des benchmarks ou prix rapportés. La date de l'article est le 4 octobre 2026 ; les comparaisons de coûts et conclusions qu'il contient sont datées et ne doivent pas être considérées comme l'état actuel ; pour les informations tarifaires, se référer à la page de tarification officielle.