Deep Principle publie Hydrogen-1.0 : un modèle scientifique de 753B aux poids publiés, servi sur 8 GPU via SGLang
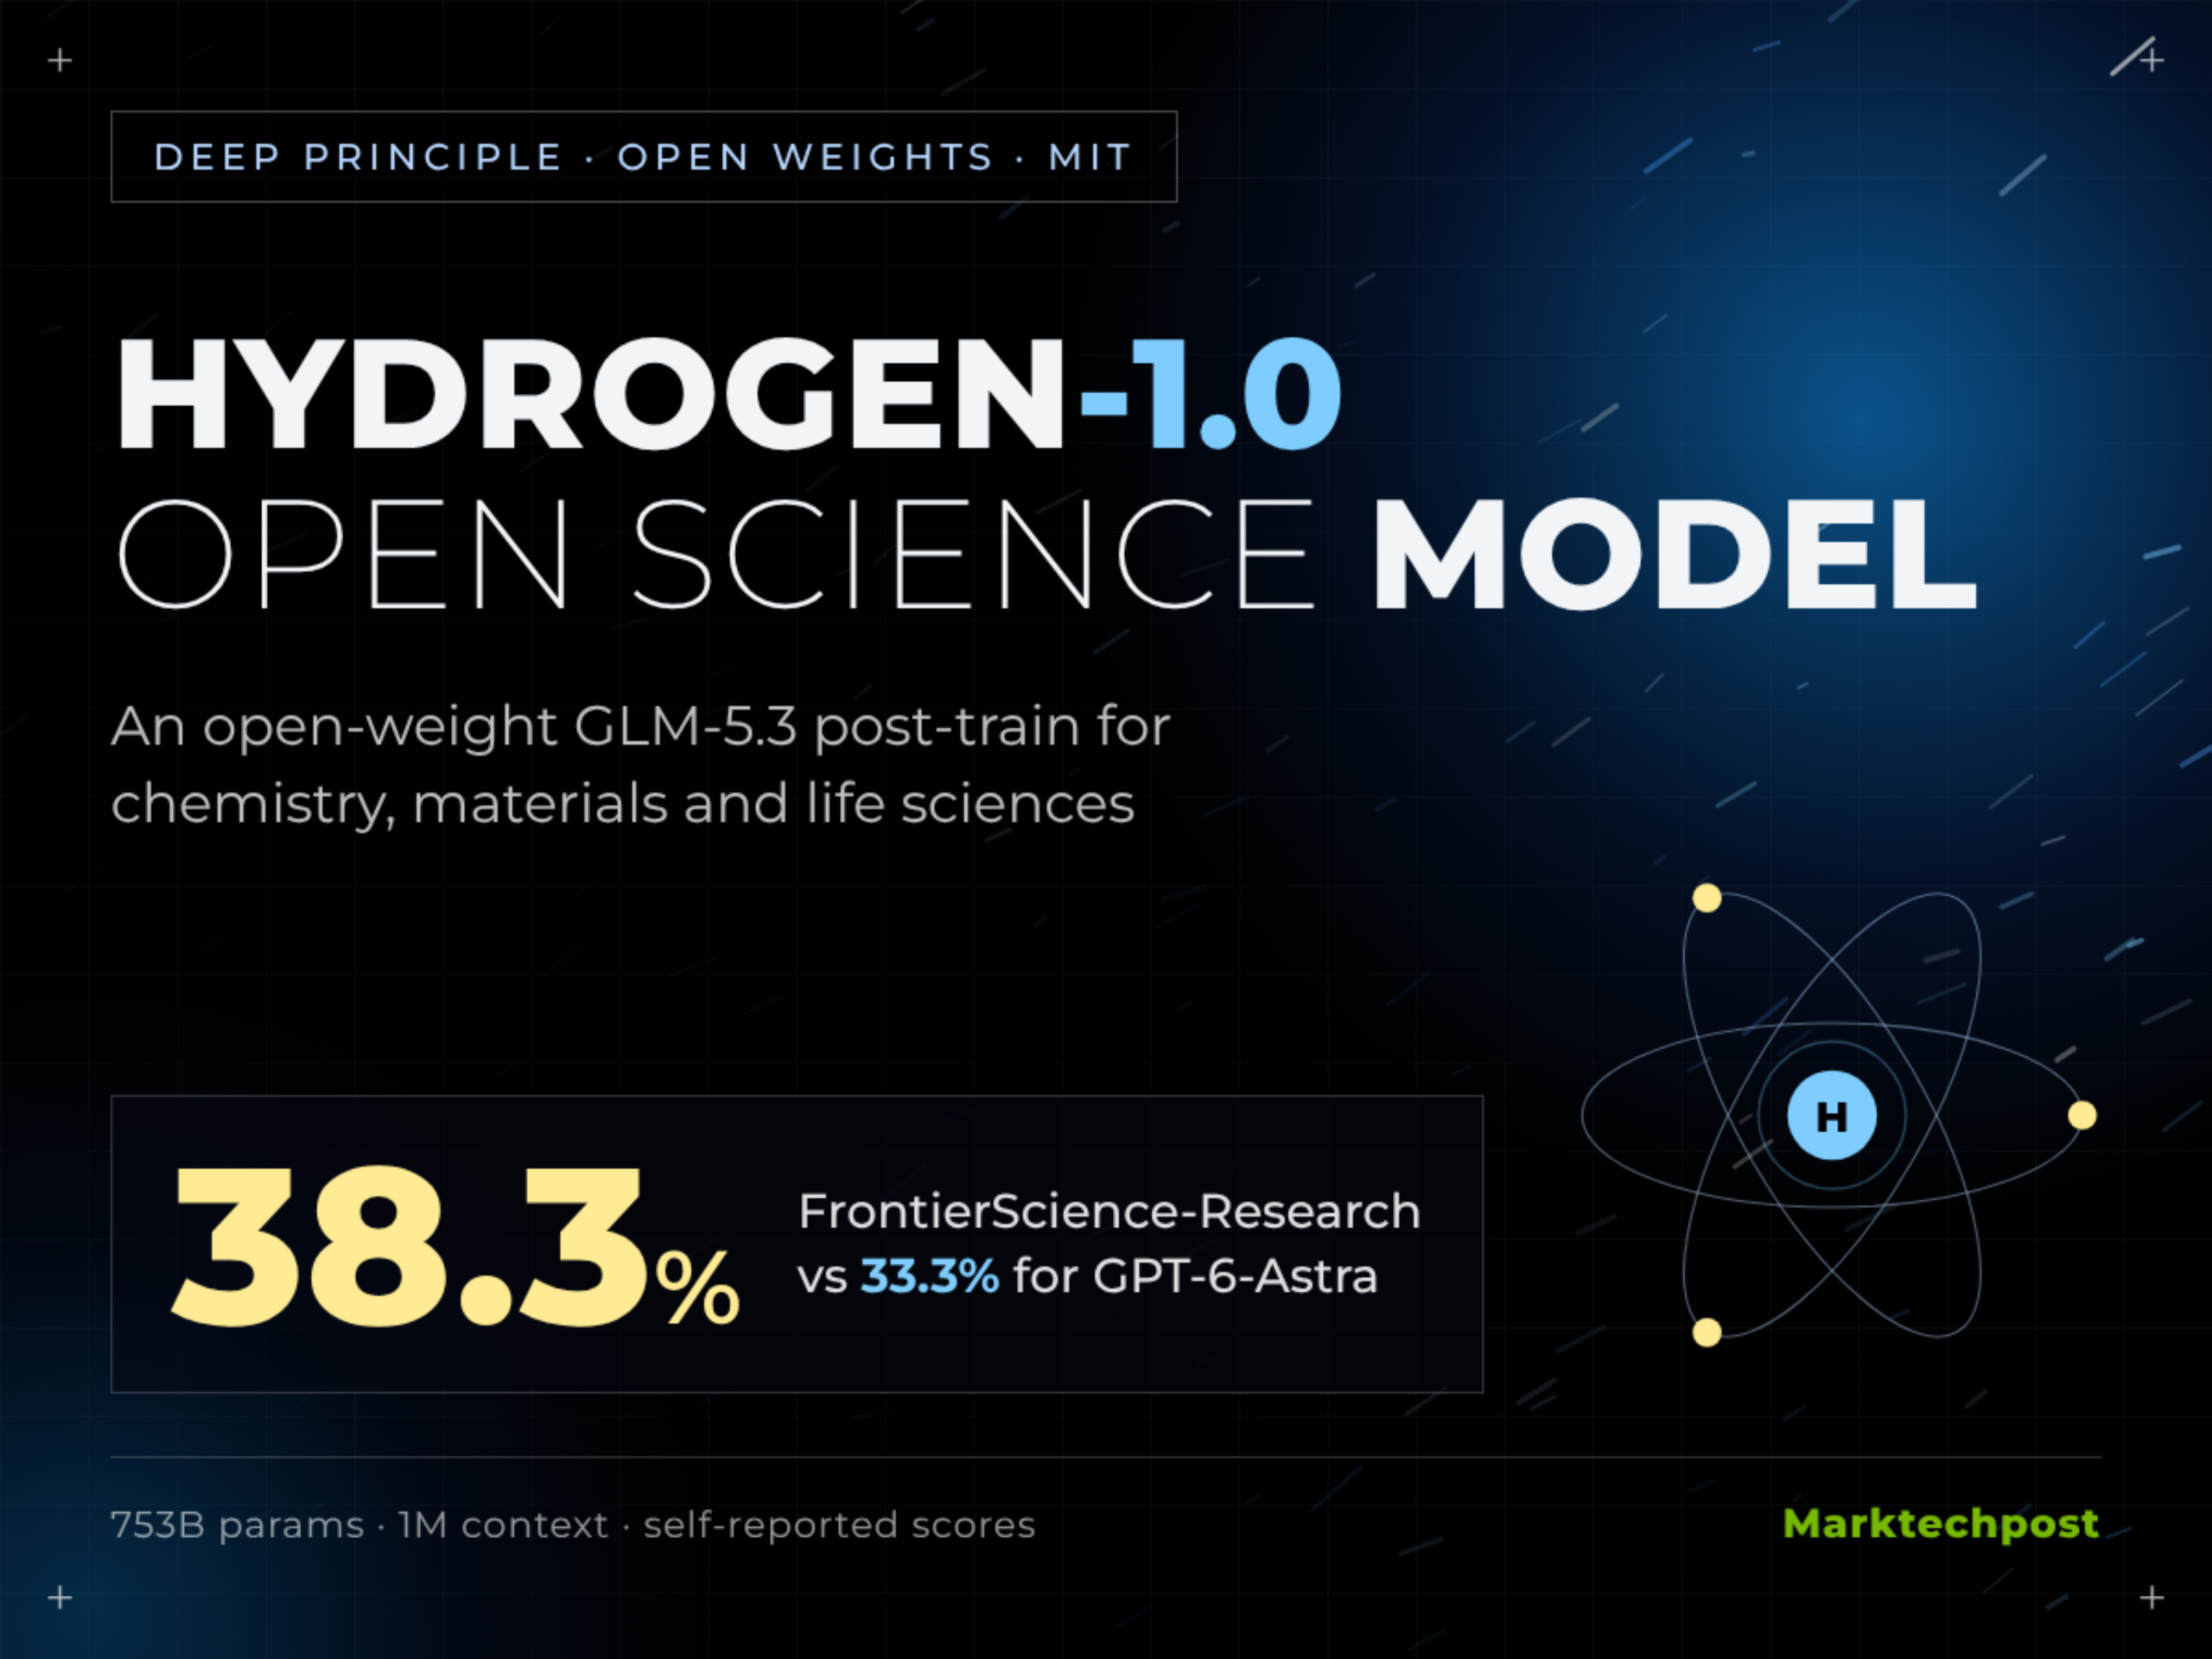
Selon MarkTechPost, le 2 novembre 2026, la société hangzhouaise Deep Principle a publié Hydrogen-1.0, un modèle post-entraîné à partir de GLM-5.3, avec 753B de paramètres totaux, un contexte de 1M et des poids qui seraient diffusés sous licence MIT. Son auto-évaluation sur FrontierScience-Research atteint 38,3 %, contre 33,3 % pour GPT-6-Astra, mais il accuse un retard de 3,33 points sur l'élucidation structurale par NMR.
Ce qui change
Selon MarkTechPost, le 2 novembre 2026, Deep Principle, société basée à Hangzhou et spécialisée dans l'IA pour les matériaux, a publié Hydrogen-1.0. Les poids ont été téléversés sur Hugging Face et ModelScope, et l'article indique une diffusion sous licence MIT. La fiche du modèle le présente comme un dérivé de GLM-5.3 de Z.ai, destiné à la formulation de problèmes, la planification d'expériences, l'analyse de résultats et la découverte ouverte. L'équipe affirme vouloir offrir une alternative reproductible et auditable aux modèles scientifiques propriétaires jusque-là fermés. Côté spécifications, l'article rapporte 753B de paramètres totaux, environ 40B activés dans une architecture MoE (taille d'activation héritée du socle GLM-5.3), un contexte de 1M de tokens, une sortie maximale de 128K et une modalité texte uniquement. L'entraînement combine ajustement supervisé et apprentissage par renforcement, avec des données issues de quatre catégories : connaissances en chimie, matériaux et sciences de la vie ; retours de tâches fournis par les scientifiques de Deep Principle ; cahiers de laboratoire électroniques couvrant tout le cycle, collectés via Mira ; et séquences de sélection et de retour incluant des tentatives échouées. L'infrastructure repose sur Megatron et SGLang, sur NVIDIA CUDA et AMD ROCm ; les points de contrôle d'entraînement sont convertis par un adaptateur de disposition en poids d'inférence BF16 et FP8 à blocs 128×128. L'article précise que le jeu de données complet et la recette d'entraînement ne sont pas publics. Tous les benchmarks sont des auto-évaluations de Deep Principle. Sur FrontierScience-Research, Hydrogen-1.0 obtient 38,3 %, contre 33,3 % pour GPT-6-Astra selon l'article. Les 93,0 % sur GPQA-Diamond proviennent d'un fil de publications du fondateur ; l'affirmation selon laquelle le modèle serait meilleur que GLM-5.3 et à peu près au niveau de Kimi-K3 est celle du blog, alors que le tableau comparatif de l'article marque ces scores comme non divulgués et attribue les 96,0 % de GPT-6-Astra à un rapport d'OpenAI. L'évaluation interne sur tâches de recherche prend GPT-6-Astra en mode de réflexion maximal comme référence : Hydrogen-1.0 avance de 5,13 points en calcul scientifique et de 4,76 points en prédiction de réactions directes, mais recule de 3,33 points sur l'élucidation structurale par NMR. Dans une tâche de conception de complexes de métaux de transition, le modèle cherche à augmenter le gap HOMO-LUMO sur cinq tours ; au cinquième tour, la moyenne du meilleur historique atteint 4,318 eV, contre 3,689 eV pour GPT-6-Astra et 3,353 eV pour Kimi-K3 selon l'article. Sur 117 questions de planification expérimentale, Hydrogen-1.0 dépasse Kimi-K3, GPT-6-Astra et Opus-5.5 étant exclus de cette comparaison car ils ont refusé plus de la moitié des requêtes. Quatre démonstrations sont présentées : construire un mélange de polyéthylène en Python et lancer GROMACS, détecter une erreur de topologie, la corriger puis analyser la trajectoire corrigée de 40 ns ; étendre une voie réactionnelle Ireland-Claisen à 27 structures à partir de 30 réactions plausibles ; classer 7 produits candidats de monoformylation du 2-bromonaphtalène à partir d'un spectre 1H NMR ; rédiger un protocole JSON pour une étude de couplage de Suzuki sur 12 flacons. Le laboratoire virtuel a également bloqué, avant exécution, une aspiration effectuée sans changement d'embout. Pour le déploiement, l'équipe a testé un service BF16 avec SGLang sur 8 GPU et un parallélisme tensoriel de 8. Elle propose aussi une version NVFP4 pour NVIDIA B200/B300 et une version MXFP4 pour AMD Instinct MI350X/MI355X ; le serveur expose une interface compatible OpenAI avec un réglage reasoning_effort. L'article ne donne ni prix d'API ni service hébergé pour Hydrogen-1.0.
Conséquences pour les développeurs
Le premier obstacle pour les développeurs est la machine, pas l'intégration. Avec 753B de paramètres totaux et environ 40B activés, l'auto-hébergement relève d'un projet d'ingénierie à huit GPU, et la seule configuration validée dans l'article est BF16 avec un parallélisme tensoriel de 8. Pour réduire le nombre de cartes, il faut compter sur les points de contrôle NVFP4 ou MXFP4, qui ciblent respectivement Blackwell (B200/B300) et MI350X/MI355X ; pour les équipes équipées de H100/H200 ou MI300, l'article ne donne aucune voie correspondante. Il s'agit donc plutôt d'une option d'auto-hébergement pour ceux qui ont les ressources que d'un simple conteneur à lancer, en particulier avec un contexte de 1M : le temps de prefill et l'occupation mémoire doivent être mesurés séparément sur des requêtes longues, sans extrapoler depuis le débit obtenu sur des prompts courts. La forme de l'interface réduit le coût de migration. Le serveur SGLang expose une API compatible OpenAI, à laquelle les clients existants et la plupart des couches d'orchestration de prompts peuvent se connecter directement. reasoning_effort transforme le budget de réflexion en paramètre de requête, mais l'article ne précise ni sa plage de valeurs, ni sa valeur par défaut, ni sa correspondance avec les tokens de sortie. Il faut donc vérifier ces points sur votre propre passerelle, faute de quoi la latence en production dérivera selon le niveau par défaut. Sur la licence, il faut distinguer deux choses. L'article indique que les poids diffusés utilisent MIT, ce qui est plus large qu'une simple ouverture des poids ; mais le tableau comparatif du même article associe au socle GLM-5.3 une autre licence, propre à GLM-5.3. Savoir si un modèle post-entraîné à partir d'un socle sous licence personnalisée peut être redistribué sous MIT par la partie qui l'a dérivé exige de lire directement le texte de la licence et la fiche du modèle, sans l'inférer du fait que les poids sont téléchargeables. Le jeu de données et la recette d'entraînement ne sont pas publics : la reproductibilité et l'auditabilité revendiquées ne couvrent pour l'instant que la couche des poids, pas les cahiers de laboratoire ni les traces de découverte. Le profil de capacités présente une asymétrie. L'article reconnaît lui-même un retard de 3,33 points face à GPT-6-Astra sur l'élucidation structurale par NMR, dans une comparaison interne sur tâches de recherche ; il présente par ailleurs une démonstration où le modèle classe 7 produits candidats de monoformylation à partir d'un spectre 1H NMR. Ce sont des tâches différentes : la première est une faiblesse signalée, la seconde seulement une démonstration. Savoir si votre activité se heurte à cette faiblesse dépend de la part des tâches d'élucidation dans vos requêtes ; le nombre de démonstrations dans un dossier ne remplace pas cette mesure. Un détail méthodologique mérite attention. Dans l'évaluation de planification expérimentale, deux concurrents ont été écartés parce qu'ils refusaient plus de la moitié des requêtes : la comparaison ne porte donc que sur les demandes que le modèle acceptait de traiter. Si vos prompts de production sont ambigus ou contiennent des informations sensibles, le taux de refus doit figurer dans le tableau d'évaluation à côté de l'exactitude ; sinon, vous risquez de choisir un modèle plus disposé à répondre, et non un modèle plus exact.
Intégration et évaluation
Ce qui suit est une analyse conditionnelle fondée sur l'article, pas des faits vérifiés. Décision 1 : choisir BF16 ou FP4. L'article indique trois chemins d'inférence pour le même modèle : BF16 testé sur 8 GPU avec un parallélisme tensoriel de 8, NVFP4 pour B200/B300 et MXFP4 pour MI350X/MI355X. Il ne faut pas choisir FP4 au motif que le nouveau format serait plus rapide : il faut le traiter comme un substitut à valider. La première condition de déclenchement est la génération d'accélérateur : seules les machines correspondantes disposent d'un point de contrôle FP4, les autres revenant à BF16 ; la seconde est la marge de mémoire disponible pour BF16. Le critère mesurable consiste à prendre un lot de requêtes maison, par exemple un lot de classement de produits spectraux et un lot de prédiction de réactions directes, à exécuter BF16 puis FP4, et à comparer le taux d'accord top-1 et la latence de sortie par requête. Si la baisse d'accord dépasse votre seuil métier et que BF16 tient, restez en BF16. Décision 2 : remplacement global ou routage par tâche. Le changement rapporté est que Hydrogen-1.0 a reçu un post-entraînement scientifique au-dessus de GLM-5.3, tandis que l'article présente le socle GLM-5.3 comme orienté programmation et agents. Il faut router selon le type de requête plutôt que remplacer un modèle par un autre : chimie, matériaux, sciences de la vie, raisonnement et planification expérimentale vers Hydrogen-1.0 ; codage général et orchestration d'outils sur le socle ou un autre modèle. La condition est un volume de requêtes suffisant pour distinguer les deux flux, faute de quoi le routage n'ajoute que de la charge d'exploitation. Le critère est de conserver un jeu de validation par catégorie de tâche, de suivre le taux de réussite et le coût réel par tâche réussie, et de ne séparer les flux que si le gain sur les tâches scientifiques couvre le coût d'un déploiement supplémentaire. Décision 3 : valeur par défaut de reasoning_effort. L'article confirme que le serveur expose ce réglage et précise que la comparaison avec GPT-6-Astra a été menée en mode de réflexion maximal. Il ne faut pas recopier le réglage du concurrent : balayez vous-même la courbe. La condition est de pouvoir journaliser les tokens de sortie et la latence de bout en bout de chaque requête. Le critère est la courbe de l'exactitude en fonction des tokens de sortie : prenez comme valeur par défaut le point où le gain marginal s'aplatit nettement, et réservez un niveau plus bas aux interfaces en ligne sensibles à la latence. Les étapes d'évaluation peuvent suivre les forces et faiblesses déclarées dans l'article. Reproduisez d'abord sur vos données la faiblesse annoncée, l'élucidation structurale par NMR, pour voir si les types d'erreur vont dans la direction rapportée. Reproduisez ensuite les points forts revendiqués, par exemple l'optimisation itérative qui cherche un gap plus grand, pour voir si la convergence au cinquième tour approche la tendance numérique donnée. Mesurez enfin le taux de refus et le taux de respect du format, car deux concurrents ont justement été écartés sur le taux de refus.
Limites et points à confirmer
Hydrogen-1.0 ne figure pas dans le catalogue de modèles de KimiSeek : le site ne le liste pas et ne propose pas de point d'accès. Les adresses de téléchargement des poids et l'interface compatible OpenAI mentionnées dans l'article renvoient à un déploiement auto-hébergé côté éditeur ; toute disponibilité hébergée, tout prix et toute limite de débit doivent être vérifiés auprès de Deep Principle ou de l'hébergeur effectif. GLM-5.3, présent dans le catalogue du site, est son socle : ce n'est pas le même modèle. Les benchmarks de l'article sont des auto-évaluations de Deep Principle. La reproduction par des tiers de FrontierScience-Research et des évaluations internes n'est pas mentionnée. Les 33,3 % de GPT-6-Astra sont un chiffre relayé depuis Deep Principle ; les 93,0 % de GPQA-Diamond proviennent d'un fil de publications du fondateur ; l'affirmation selon laquelle le modèle serait meilleur que GLM-5.3 et à peu près au niveau de Kimi-K3 n'est pas étayée par les valeurs correspondantes du tableau de l'article. Le jeu de données et la recette d'entraînement ne sont pas publics. Selon l'article, la licence MIT s'applique aux poids publiés ; le socle utilise une autre licence dans le tableau comparatif, et la redistribution des poids dérivés sous MIT doit être vérifiée directement dans le fichier de licence. Les quatre démonstrations montrent seulement que le flux peut fonctionner, pas une validation de l'exactitude ou de la sécurité. L'article ne donne ni prix d'API ni service hébergé ; si un hébergeur apparaît, consultez sa page tarifaire pour les prix et les quotas.