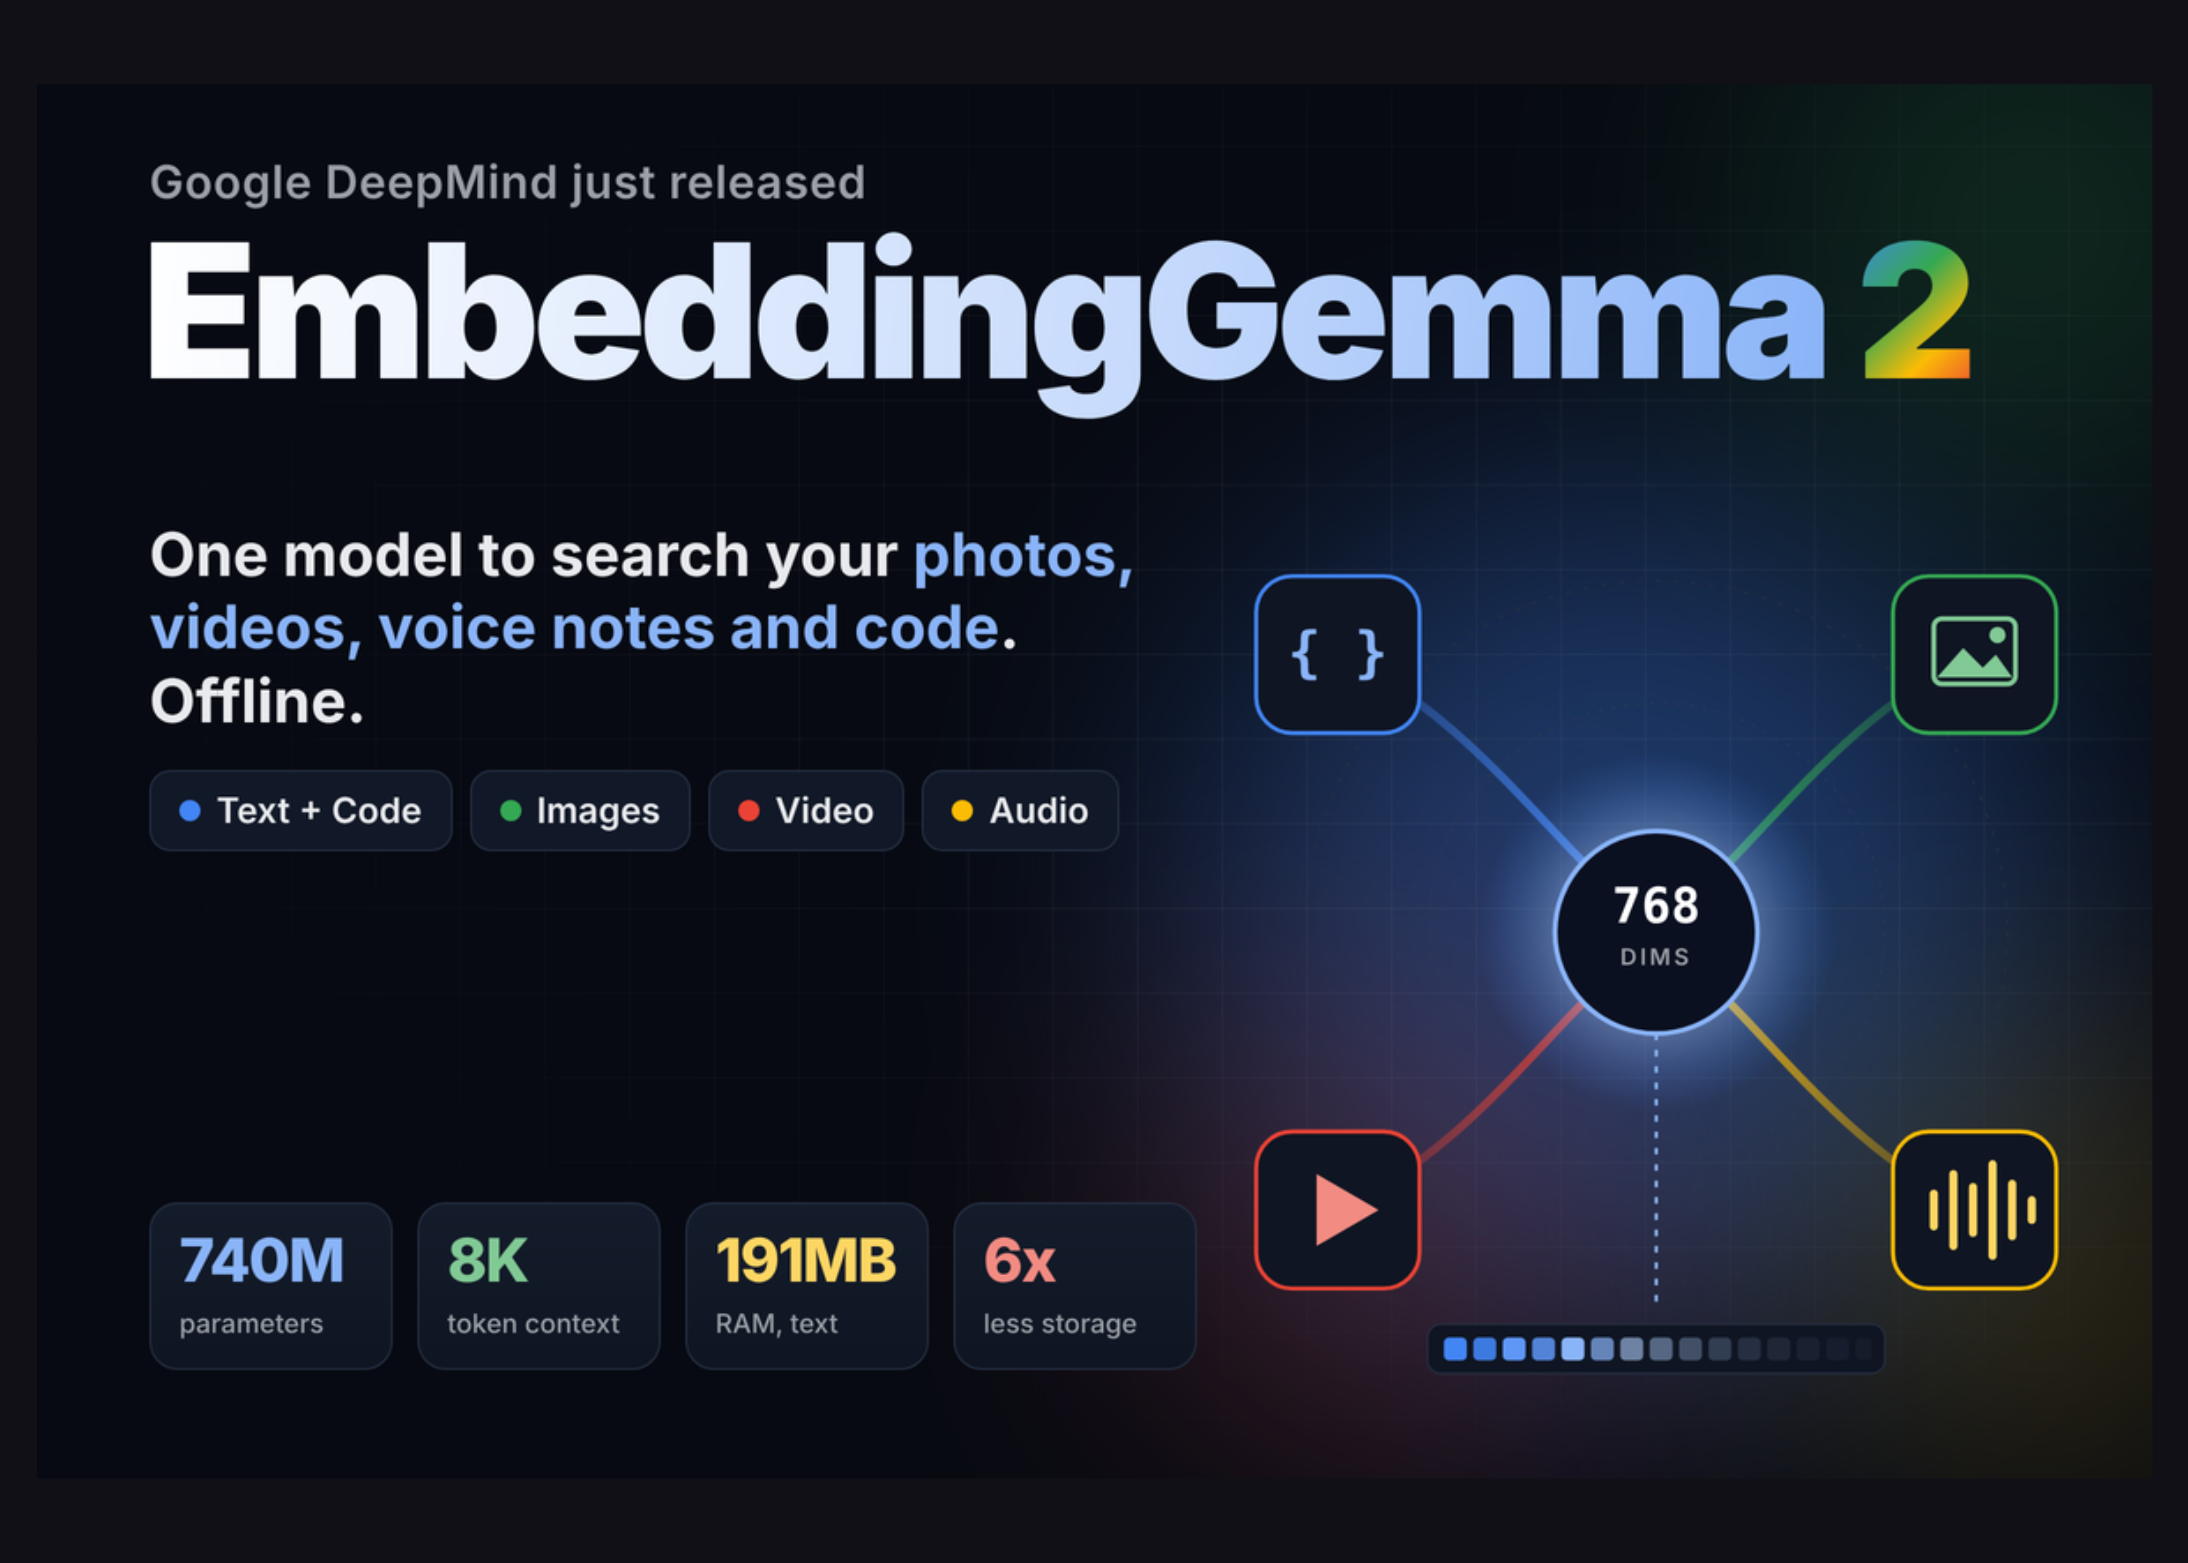
EmbeddingGemma 2 en poids ouverts : 740 M de paramètres partageant un espace 768D, le code et l'audio comme nouvelles variables
Selon MarkTechPost, le 6 octobre 2026, Google DeepMind a publié EmbeddingGemma 2, un modèle d'embedding multimodal à poids ouverts de 740 millions de paramètres, avec un contexte de 8K et sous licence Apache 2.0, qui projette texte, code, images, vidéo et audio dans un même espace de 768 dimensions. Le backbone texte de 270 millions de paramètres peut être chargé seul.
Ce qui change
Selon MarkTechPost, le 6 octobre 2026, Google DeepMind a publié EmbeddingGemma 2, un modèle d'embedding multimodal à poids ouverts fondé sur l'architecture Gemma 4 et sous licence Apache 2.0. Il projette différentes modalités dans un même espace vectoriel de 768 dimensions au moyen d'encodeurs modulaires : backbone texte et code d'environ 270 millions de paramètres (130 millions pour le transformer plus 140 millions pour l'embedder), encodeur visuel optionnel de 170 millions de paramètres, encodeur audio optionnel de 300 millions, soit environ 740 millions au total, que les développeurs peuvent charger en partie seulement selon leurs besoins. La fenêtre de contexte est de 8192 tokens, quatre fois celle de la première génération selon l'article, de quoi contenir environ 29 images, 58 images vidéo ou 5,5 minutes d'audio. D'après la fiche du modèle, MTEB Code v1 passe de 68,76 à 78,68, MTEB multilingual v2 de 61,15 à 61,36, avec de nouveaux indicateurs comme MIEB lite image 64,64, MMEB v2 total 59,01 et MAEB audio 49,39. Les poids seraient disponibles sur Hugging Face et Kaggle, avec des modes d'exécution Ollama, llama.cpp GGUF, LiteRT, sentence-transformers v6.1.0+, vLLM, SGLang, MLX, LM Studio et MediaPipe ; le stockage vectoriel est pris en charge par Qdrant et le fine-tuning par Unsloth ; MRL permet de tronquer les vecteurs à 512, 256 ou 128 dimensions.
Conséquences pour les développeurs
Pour les développeurs, le changement clé de cette publication n'est pas le nombre de paramètres, mais la couverture du code et de l'audio dans un même espace vectoriel, avec la possibilité de ne charger que le backbone texte. Cela modifie directement trois types d'arbitrages. D'abord, la couche de recherche d'un RAG multimodal nécessitait souvent deux modèles d'embedding, deux index et une logique de normalisation des scores ; l'article affirme que les vecteurs de requête produits par la configuration texte seul peuvent correspondre aux vecteurs de documents produits par le modèle complet. Si cela se reproduit, on pourrait indexer d'abord avec le backbone de 270 millions de paramètres, puis ajouter les encodeurs visuel ou audio sans reconstruire la base. Ensuite, la progression sur les benchmarks de recherche de code (environ 9,92 points, soit environ 14 % selon l'article) place le modèle parmi les candidats pour la recherche sémantique dans les dépôts de code, mais il s'agit de chiffres de la fiche du fournisseur, qui ne garantissent pas les performances sur un dépôt propre. Enfin, il se distingue de Qwen3-VL-Embedding-2B d'Alibaba par des compromis différents : ce dernier aurait rapporté 73,2 points sur son propre test MMEB v2, avec environ 2,7 fois plus de paramètres et sans prise en charge de l'audio, tandis qu'EmbeddingGemma 2 met l'accent sur un contexte de 8K, la mémoire embarquée et la prise en charge audio. Il faut noter que des poids ouverts ne signifient pas une licence open source sans contraintes : Apache 2.0 est une licence permissive, mais l'origine des données d'entraînement et les exigences de conformité en aval doivent être vérifiées. Par ailleurs, le catalogue actuel de KimiSeek ne contient aucune entrée nommée EmbeddingGemma 2 : cette version n'est pas disponible sur KimiSeek pour l'instant ; la disponibilité mentionnée renvoie à des canaux externes comme Hugging Face, Kaggle ou Ollama, et une éventuelle offre API devrait être vérifiée sur la page de son fournisseur.
Intégration et évaluation
Ce qui suit relève de recommandations et d'analyses conditionnelles, non de faits rapportés. Recommandation 1 : déterminer d'abord si la recherche intermodale est nécessaire. Si vous ne traitez que du texte chinois et du code et utilisez déjà un modèle d'embedding texte éprouvé, considérez EmbeddingGemma 2 comme un candidat A/B plutôt qu'un remplacement immédiat ; menez d'abord une expérience de rappel sur vos propres requêtes et documents, en évaluant avec Recall@10 et nDCG@10 plutôt qu'en vous fiant aux seuls scores MTEB. Si votre charge de travail inclut réellement des documents mêlant texte et images ou la recherche dans des notes vocales, il vaut la peine de vérifier en priorité l'hypothèse d'espace vectoriel partagé : construisez l'index avec le backbone texte de 270 millions de paramètres, puis encodez les mêmes documents texte-image avec le modèle complet et mesurez la cohérence de similarité entre configurations ; si le classement de pertinence dérive nettement, il faudra des index séparés par configuration. Recommandation 2 : arbitrer entre dimensions et stockage. Selon l'article, à 256 dimensions MTEB multilingual ne baisse que de 61,36 à 60,41, tandis qu'à 128 dimensions MMEB tombe à 45,65, la recommandation officielle réservant 128 dimensions au texte seul. Si votre goulot d'étranglement est le coût de stockage du vector store et que le cas est purement textuel, testez d'abord 256 dimensions ; s'il s'agit de recherche d'images ou de vidéos, conservez 768 dimensions et comparez l'écart de rappel entre 256 et 768 sur vos données, en fixant un seuil de perte de rappel acceptable avant de décider. Recommandation 3 : risque de verrouillage de la pile de déploiement. Les piles d'exécution sont nombreuses ; choisissez selon votre cible serveur ou embarquée, et consignez dans la configuration les dimensions vectorielles, les modèles de prompt (noms SearchQuery et Document cités dans l'article) et la quantification, puis exécutez un jeu de régression fixe avant et après quantification pour comparer le rappel. Évaluez impérativement avec vos données d'entreprise plutôt qu'avec des classements publics, car la qualité multilingue est globalement stable selon l'article, les gains se concentrant sur le code et les nouvelles modalités.
Limites et points à confirmer
Les chiffres de benchmark, d'occupation mémoire et de latence proviennent de la fiche du modèle Google ou des déclarations de l'équipe de recherche : ce sont des rapports de fournisseur, non reproduits par un tiers indépendant ; les 191 Mo et 567 Mo embarqués correspondent à la mémoire active après quantification sur un appareil précis (Pixel 11 Pro) et ne peuvent être extrapolés directement à d'autres matériels. L'article ne détaille pas la composition des données d'entraînement ni la répartition des langues, et les performances réelles en chinois doivent être vérifiées. Dans la comparaison entre modèles, les 73,2 points de Qwen3-VL-Embedding-2B relèvent de son propre rapport sur MMEB v2 ; les comparaisons partielles et les scores issus de classements différents ne sont pas directement comparables. De plus, cette version EmbeddingGemma 2 n'apparaît pas dans le catalogue de modèles de KimiSeek ; cet article ne la considère donc pas comme disponible sur KimiSeek ; la mise en ligne des poids, le téléchargement via Ollama et les divers supports d'exécution mentionnés renvoient à des publications de fournisseurs ou de communautés sur des canaux externes, dont la disponibilité et les éventuels tarifs futurs doivent être vérifiés sur les pages officielles des plateformes concernées. L'article évoque une prise en charge ML Kit pour Android prévue dans quelques semaines : c'est un projet, non un fait acquis, et il ne faut pas planifier sur cette base.
Illustrations de l’article original