GLM 5.3 arrive sur Amazon Bedrock : MoE 753B via API hébergée, cache de prompt explicite et inférence interrégions au cœur de l'intégration
Selon le blog officiel d'AWS du 5 octobre 2026, GLM 5.3 de Z.ai est disponible sur Amazon Bedrock pour les clients entreprises éligibles, appelable via les API Responses/Chat Completions compatibles OpenAI et Invoke/Converse de Bedrock, prend en charge le cache de prompt implicite et explicite ainsi que des configurations d'inférence interrégions US et Global, et fournit un chemin pour l'appeler avec l'agent open source de test d'intrusion Strix.
Ce qui change
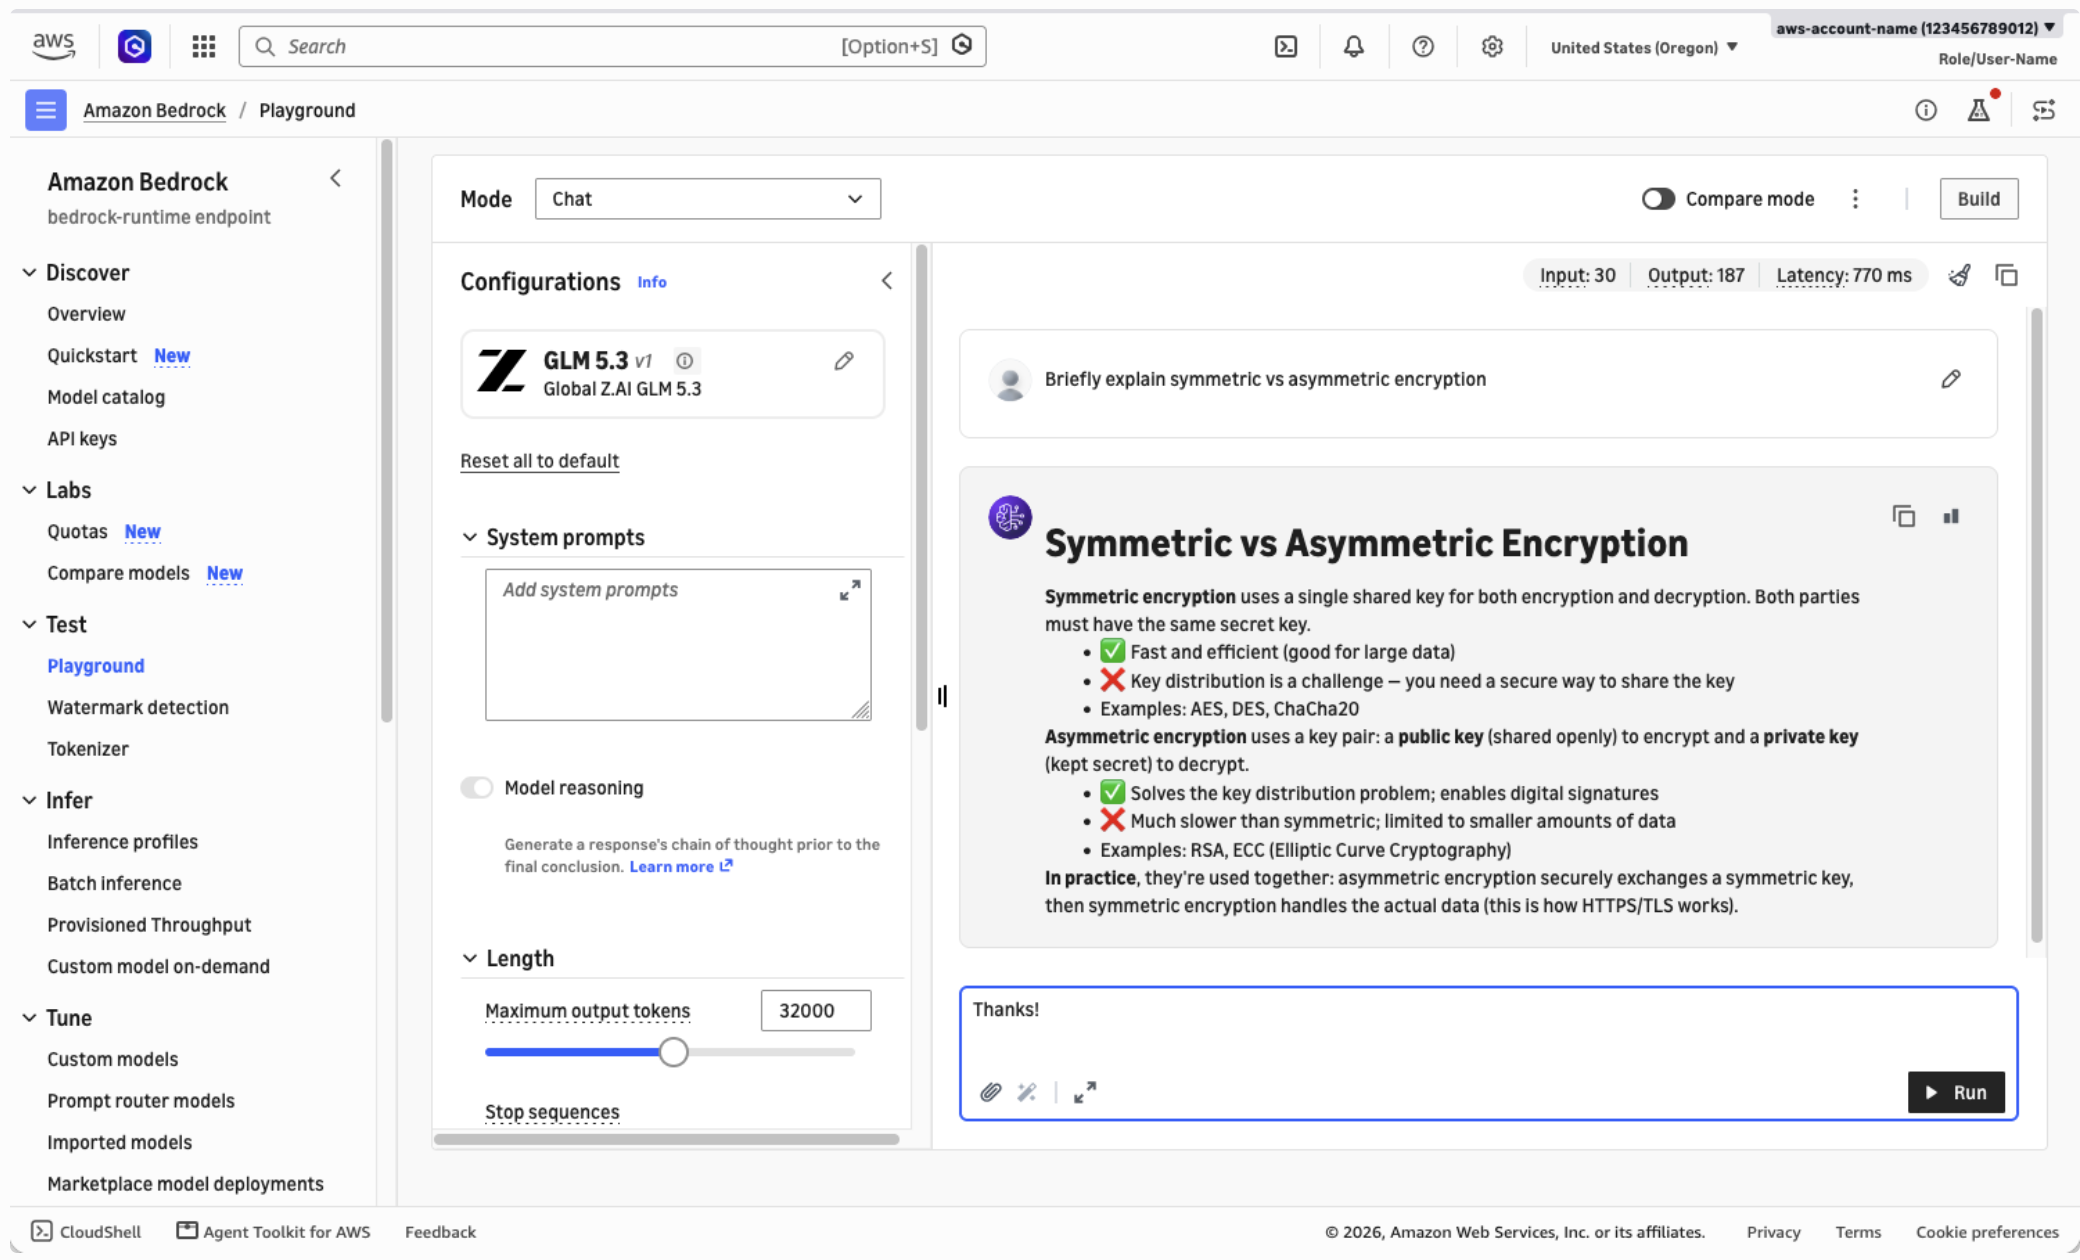
Selon le blog officiel d'AWS du 5 octobre 2026, GLM 5.3 de Z.ai (Zhipu AI) est disponible sur Amazon Bedrock pour les clients entreprises éligibles. Selon l'article, d'après les informations publiées sur Hugging Face Hub, GLM 5.3 est un modèle à mélange d'experts (MoE) de 753 milliards de paramètres, optimisé pour le codage et les tâches d'agents à cycle long ; Z.ai rapporte des performances marquées sur les tâches de sécurité, avec un score de 84,5 sur le benchmark CyberGym au moment de la publication. Par rapport à GLM 5 arrivé sur Bedrock plus tôt cette année, l'article liste trois changements : Z.ai déclare des performances compétitives sur des benchmarks de codage tels que DeepSWE, Terminal Bench 3.0 et FrontierSWE, ainsi qu'une amélioration de 50 % par rapport à GLM 5.2 sur un benchmark de codage interne, sans comparaison directe avec GLM 5, car les benchmarks eux-mêmes ont été mis à jour depuis GLM 5.1 ; les capacités de sécurité sont décrites comme « émergentes » ; l'intégration Bedrock est plus complète. Côté accès, le modèle peut être appelé via le point de terminaison bedrock-runtime avec les API Responses et Chat Completions compatibles OpenAI, et prend également en charge Invoke et Converse de Bedrock ; AWS recommande de privilégier l'API compatible OpenAI pour les nouvelles applications, et d'utiliser des identifiants à court terme plutôt qu'une clé API de longue durée. Le modèle est proposé via deux profils d'inférence interrégions, us.zai.glm-5.3 et global.zai.glm-5.3, avec trois niveaux de service : Flex, Priority et Standard.
Conséquences pour les développeurs
Pour les développeurs qui évaluent les voies d'hébergement de modèles chinois, le changement réel ici ne réside pas dans un « modèle plus puissant », mais dans l'ajout de surfaces d'appel et de moyens de maîtrise des coûts. Premièrement, Bedrock propose à la fois une interface compatible OpenAI et les Invoke/Converse natifs, ce qui signifie que le code existant basé sur le SDK OpenAI se limite à des modifications de base_url, de mode d'authentification (utiliser aws-bedrock-token-generator pour échanger des identifiants AWS CLI contre un jeton à court terme) et d'identifiant de modèle, plutôt qu'une réécriture de la couche d'appel ; pour les équipes disposant déjà de plusieurs adaptateurs compatibles OpenAI, le coût de migration porte surtout sur les identifiants et le routage, pas sur la logique métier. Deuxièmement, le cache de prompt explicite est qualifié de « recommandé » par AWS : pour les charges d'agents qui renvoient à chaque tour un prompt système, des définitions d'outils ou des fichiers de dépôt, cela touche directement le coût en tokens d'entrée et la latence du premier token, le taux de succès du cache devenant ainsi un indicateur d'ingénierie observable. Troisièmement, les profils d'inférence interrégions découplent « où la requête est envoyée » et « où elle est réellement traitée » ; les clients entreprises doivent réexaminer la résidence des données et les exigences de conformité, plutôt que de supposer un traitement sur place. Quatrièmement, la documentation de Strix utilise actuellement GLM 5.3 comme modèle par défaut et peut pointer vers Bedrock, ce qui place l'inférence de charges très sensibles comme les tests de sécurité sous le contrôle de leur propre compte AWS ; c'est une option pertinente pour les équipes sécurité, mais elle implique des questions de périmètre d'autorisation et de conformité et ne peut être assimilée à une solution « clé en main ». À noter : ces descriptions de capacités proviennent uniquement du blog unilatéral d'AWS et des benchmarks auto-déclarés par Z.ai, sans reproduction indépendante à ce jour.
Intégration et évaluation
Il est suggéré d'évaluer selon les règles conditionnelles suivantes, qui sont des jugements fondés sur la source et non des conclusions établies. Premièrement, faut-il passer à l'interface compatible OpenAI : si l'application existante est déjà basée sur le SDK OpenAI et nécessite l'ensemble complet des fonctionnalités de cache explicite, AWS indique qu'il faut privilégier l'API Responses compatible OpenAI ; si le code existant est fortement lié à Bedrock Converse ou doit partager la couche d'appel avec d'autres modèles Bedrock, conserver l'interface native réduit les modifications. Condition préalable : le compte dispose des permissions bedrock:InvokeModel, bedrock:InvokeModelWithResponseStream et bedrock:CallWithBearerToken. Le critère d'évaluation mesurable consiste à exécuter deux tours de conversation avec un même long prompt système, vérifier si input_tokens_details.cached_tokens est non nul dans la réponse, et comparer la facturation des tokens d'entrée et la latence du premier token entre les deux tours. Deuxièmement, faut-il activer le cache explicite : si la charge de travail renvoie à chaque tour de grands blocs de contexte statique (prompt système, définitions d'outils, extraits de dépôt), la source recommande de passer au mode explicit de prompt_cache_options et de placer un prompt_cache_breakpoint ; si le contexte est court ou change fréquemment, le cache implicite suffit et le coût de maintenance des marqueurs n'en vaut pas la peine. Condition préalable : chaque point d'arrêt doit comporter au moins 1 024 tokens pour être éligible au cache ; un marquage sur un prompt court est sans effet. Le critère mesurable est la part de tokens en cache et la réduction de la latence de bout en bout sous la même charge, en vérifiant que le découpage des points d'arrêt ne brise pas les frontières sémantiques. Troisièmement, quel profil interrégions choisir : les équipes visant les utilisateurs américains ou ayant déjà des exigences de conformité sur la région us évaluent us.zai.glm-5.3 ; en cas de besoin de couverture plus large, évaluer global.zai.glm-5.3, le choix reposant sur les exigences de résidence des données et les mesures de latence, et non sur un choix par défaut du « global ». Les critères mesurables sont la latence P50/P95 depuis la région source cible, ainsi que la conclusion écrite de l'évaluation de conformité sur la région de traitement. Quatrièmement, le niveau de service : évaluer Flex pour optimiser les coûts sur les tâches peu sensibles comme le traitement par lots ou l'analyse hors ligne, évaluer Priority pour les requêtes sensibles à la latence comme un assistant de codage interactif, Standard servant de référence par défaut. Condition préalable : le choix du niveau modifie le prix unitaire, vérifier impérativement la facturation actuelle dans la console. Dans tous les cas, commencer par une comparaison à petite échelle avec son propre dépôt de code et de véritables trajectoires d'agents, plutôt que de remplacer directement le modèle par défaut en production.
Limites et points à confirmer
Cette version GLM 5.3 n'apparaît pas actuellement dans le catalogue en temps réel de KimiSeek ; la disponibilité sur Bedrock, les identifiants de modèle et les modalités de facturation mentionnés ici se réfèrent à AWS et Z.ai et ne représentent pas l'offre sur KimiSeek. Le catalogue de KimiSeek contient d'autres entrées telles que GLM-5.3, GLM-5.3 Flash et GLM-5.2, qui sont des versions ou canaux de fourniture différents, et l'on ne peut en déduire que la version Bedrock décrite ici est disponible sur KimiSeek. Les affirmations de performance de la source, notamment CyberGym 84,5, l'amélioration de 50 % du benchmark de codage interne par rapport à GLM 5.2 et les mentions de « compétitivité » sur DeepSWE, Terminal Bench 3.0 et FrontierSWE, sont auto-déclarées par Z.ai ou relayées par AWS, sans reproduction indépendante ; les versions des benchmarks ont aussi été mises à jour depuis GLM 5.1, ce qui invite à la prudence dans les comparaisons transversales. AWS précise explicitement que GLM 5.3 s'adresse aux « clients entreprises éligibles » ; la source n'indique pas si un compte ordinaire peut l'activer directement ni si toutes les régions sont disponibles. L'article original mentionne aussi que LiteLLM ne pouvait alors pas résoudre bedrock/global.zai.glm-5.3 et nécessitait de spécifier explicitement la route Converse et l'ARN du profil d'inférence, une limitation connue à l'époque dont on ignore si elle a été corrigée. L'affirmation selon laquelle Strix utilise GLM 5.3 comme modèle par défaut provient d'une description de documentation « à la date de rédaction » et peut avoir changé. Les prix et tarifs des niveaux évoluent avec le temps ; se référer aux pages de tarification en temps réel d'AWS et de KimiSeek. Les exemples de tests de sécurité ne s'appliquent qu'à des applications détenues ou faisant l'objet d'une autorisation écrite ; le contenu de la source est tronqué au paragraphe AWS Continuum.
Illustrations de l’article original