JD Logistics « Super Brain » 3.0 : planification d’itinéraires annoncée à l’échelle de la seconde, cinq modèles industriels, sans mention de poids publics ni d’API
Selon un article d’InfoQ Chine publié le 6 novembre 2026, JD Logistics a fait évoluer son grand modèle « Super Brain » vers la version 3.0 et affirme que le calcul de la planification optimale d’itinéraires pour des centaines de millions de colis est passé d’une échelle de minutes à une échelle de secondes. Le système comprend cinq modèles natifs de la chaîne d’approvisionnement : PreX, OptiX, OmniX, GeoX et EmbodiedX. Il couvrirait plus de 3 600 entrepôts et plus de 600 000 employés, avec un taux de planification automatisée des véhicules de 86 %. L’article ne mentionne ni poids publics, ni licence open source, ni interface directement appelable par des tiers.
Ce qui change
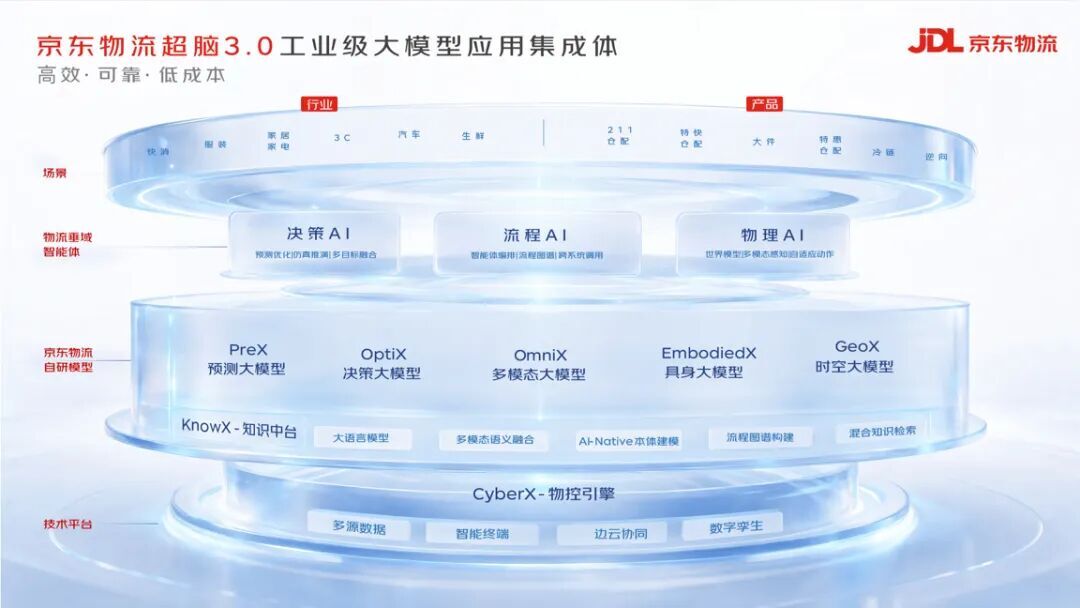
Selon un article publié par InfoQ Chine le 6 novembre 2026, le grand modèle « Super Brain » de JD Logistics a été porté à la version 3.0. L’article le présente comme un ensemble d’applications industrielles de grands modèles où l’IA pilote l’ensemble du processus, du stockage à la livraison. Par rapport à la version 2.0, l’article affirme que la version 3.0 offre une efficacité opérationnelle plus élevée, une meilleure résilience du système et des coûts d’exploitation plus faibles, et qu’elle réduit le temps de calcul de la planification optimale de bout en bout des itinéraires pour des centaines de millions de colis, le faisant passer d’une échelle de minutes à une échelle de secondes. Le système se compose de cinq modèles natifs de la chaîne d’approvisionnement : PreX prédit les variations de l’offre et de la demande à partir de données dynamiques multidimensionnelles ; OptiX combine optimisation opérationnelle, apprentissage par renforcement et capacités de modèles génératifs pour résoudre des solutions globales sous contraintes de réseau d’entrepôts, de stocks, de transport, de personnel et d’équipements ; OmniX comprend de manière unifiée les images, les vidéos, l’espace et les objets ; GeoX place adresses, positions, itinéraires et temps dans un système de coordonnées spatio-temporelles unifié ; EmbodiedX convertit la perception et les décisions en actions exécutables par des robots. L’article décrit cet ensemble comme la réunion de l’IA de décision, de l’IA de processus et de l’IA physique : la couche de décision modélise de manière unifiée les commandes, les stocks, le réseau d’entrepôts, les véhicules, l’état des routes, la météo ainsi que les informations issues des images, des vidéos et des positions ; la couche de processus se charge d’interconnecter les données des systèmes de stockage, de transport, de tri et de livraison, d’unifier les définitions des personnes, des marchandises, des véhicules, des entrepôts, des commandes et des équipements, puis de décomposer les décisions en tâches exécutables à distribuer, à suivre et à traiter en cas d’anomalie ; la couche physique est pilotée par le moteur de contrôle physique CyberX, qui fait exécuter les tâches par les robots « Zhilang », les bras de tri « Yilang » et les véhicules de livraison autonomes « Dulang », lesquels renvoient les résultats, formant ainsi une boucle fermée de perception, de prédiction, de décision, d’exécution et de retour d’information. Les autres chiffres cités dans l’article incluent : la couverture de plus de 3 600 entrepôts et de plus de 600 000 employés ; un taux de planification automatisée des véhicules de 86 % ; un gain d’efficacité de 13,8 % pour les employés des entrepôts ; le service de chaîne d’approvisionnement de bout en bout « Jinghui » destiné aux commerçants, qui affirme atteindre en moyenne plus de 80 % de livraisons le lendemain et propose automatiquement des recommandations de réapprovisionnement avec exécution des transferts ; les « Yilang », déjà en fonctionnement 24 heures sur 24 dans plusieurs parcs logistiques, avec plus de dix millions de colis réels saisis et empilés à titre de validation ; les « Dulang », testés à plusieurs endroits en Chine et en Arabie saoudite. L’article indique également que ces capacités s’ouvrent progressivement aux secteurs de la fabrication et du commerce de détail.
Conséquences pour les développeurs
Il convient d’abord de distinguer ce qui est vérifiable de ce qui ne l’est pas. Les chiffres ci-dessus proviennent tous du récit de JD Logistics ; l’article ne fournit ni nombre de paramètres des modèles, ni volume des données d’entraînement, ni méthode de test de référence, ni matériel d’inférence, ni fenêtre temporelle de mesure. Il ne mentionne pas non plus de poids ouverts, de licence open source, de fiche de modèle ou d’API publique destinée à des tiers. Pour un développeur, il s’agit plutôt d’un bilan de fonctionnement d’un système à usage interne que d’un modèle téléchargeable, hébergeable ou appelable au token. Les indicateurs laissent aussi des zones d’ombre. L’expression « à l’échelle de la seconde » ne précise pas s’il s’agit d’une moyenne ou d’une latence de queue, ni pour quel volume de commandes, quel délai de résolution et quel matériel la mesure a été effectuée ; le taux de 86 % de planification automatisée des véhicules ne précise pas si le dénominateur est l’ensemble des véhicules ou seulement ceux remplissant certaines conditions ; le gain de 13,8 % pour les employés n’a ni groupe de contrôle ni période de mesure. Ces chiffres opérationnels doivent plutôt être considérés comme des déclarations de l’entreprise à vérifier, et non comme des prévisions de performance directement transposables à sa propre activité. Ce qui a réellement une valeur transférable, c’est la répartition des rôles architecturaux, pas les chiffres précis : séparer la prédiction, l’optimisation sous contraintes, la perception multimodale, la cognition spatio-temporelle et le contrôle physique en modules indépendants, puis aligner les définitions d’entités entre systèmes via une couche de processus avant l’orchestration. Cet enchaînement répond au problème du « calcul de la décision possible, mais non applicable sur le terrain ». Le coût est tout aussi clair : une couche de sémantique unifiée supplémentaire implique une couche supplémentaire d’objets de correspondance et de points de défaillance à maintenir sur le long terme, ce qui n’est rentable que si les données sont réellement dispersées entre systèmes hétérogènes. Un autre point flou est l’« ouverture aux secteurs » : l’article ne précise pas s’il s’agit d’un produit, d’un SDK, d’une API ou d’une livraison sous forme de projet, ni les conditions d’accès et le mode de facturation. L’offre externe la plus clairement décrite est « Jinghui » destinée aux commerçants, mais il s’agit d’un service de chaîne d’approvisionnement, non d’une interface de modèle ; y souscrire signifie confier à un tiers les données de commandes, de stocks, de réseau d’entrepôts et d’exécution, et valider point par point selon le scénario propre au commerçant.
Intégration et évaluation
Les analyses et recommandations ci-dessous sont conditionnelles et ne constituent pas des faits énoncés dans l’article. Les équipes qui envisagent d’intégrer un grand modèle dans une chaîne de planification ou d’orchestration peuvent d’abord mener de petites expériences comparatives inspirées des deux approches décrites dans l’article. Premièrement, l’IA de processus unifie d’abord les définitions des personnes, des marchandises, des véhicules, des entrepôts, des commandes et des équipements avant d’orchestrer les tâches ; cela mérite une vérification distincte. Le choix à faire est le suivant : faut-il ajouter, en amont de votre couche d’orchestration d’agents, une couche de sémantique unifiée des entités et des règles ? La condition préalable est que les données soient réellement dispersées entre plusieurs systèmes et que le même objet métier soit défini de manière incohérente selon les étapes ; s’il n’existe qu’une seule source de données, cette couche n’ajoutera que de la latence et de la maintenance. Le critère d’acceptation mesurable consiste à exécuter le même lot de tickets historiques selon deux chaînes : l’une avec « unification préalable des définitions », l’autre avec « décomposition directe de bout en bout par le modèle », puis à comparer le nombre d’erreurs de correspondance de champs, le taux de nouvelles tentatives, le taux de prise en charge humaine et la latence de bout en bout ; les deux premiers indicateurs doivent baisser sans hausse significative de la latence. Deuxièmement, l’IA de décision intègre la prédiction et l’optimisation sous contraintes dans une même boucle glissante et affirme mettre à jour les décisions en quelques secondes lorsque les commandes, les routes ou les capacités de transport changent. Le choix à faire est le suivant : pour les tâches de planification, faut-il laisser un modèle génératif produire directement la solution finale, ou séparer la prédiction, la résolution et le retour d’exécution en trois étapes évaluées séparément ? La condition préalable est que votre problème comporte des contraintes strictes (délais, coûts, capacités) et que le coût d’une erreur soit élevé ; les tâches de simple classement ou de recommandation peuvent conserver une solution à modèle unique. Le critère mesurable consiste à rejouer des commandes historiques et à comparer le taux de violation des contraintes, l’écart de coût par rapport à une base de règles existante et le temps de rétablissement après injection de perturbations. Troisièmement, la partie relevant de l’IA physique ne peut pas être reproduite localement et ne peut être vérifiée que dans le cadre d’un pilote ou d’un processus d’achat. Pour évaluer une solution de bras robotisé ou de véhicule autonome, commencez par délimiter la diversité des formes de colis sur le site, puis demandez au fournisseur des indicateurs observables tels que le nombre d’heures de fonctionnement continu, le taux de réussite de saisie, le taux de casse et la fréquence d’intervention humaine, plutôt que d’accepter des formulations comme « fonctionnement en régime normal ». Une autre action très peu coûteuse s’applique à tout récit de ce type : indiquez directement dans votre grille d’évaluation les précisions à demander au fournisseur, notamment les quantiles de latence, la taille du problème, la configuration matérielle, la fenêtre statistique et le dispositif de contrôle. Sans ces éléments, les chiffres du fournisseur ne peuvent pas être convertis en planification de capacité pour votre propre système.
Limites et points à confirmer
Tous les chiffres de performance et d’efficacité de l’article proviennent de JD Logistics et n’ont pas été reproduits par un tiers ; ils ne doivent pas être considérés comme une base de référence extrapolable. L’article ne décrit que la répartition des rôles entre les cinq modèles et ne fournit pas les informations nécessaires au choix, telles que la taille des paramètres, les conditions de licence, la publication éventuelle des poids ou le coût d’inférence ; la forme concrète de l’« ouverture aux secteurs de la fabrication et du commerce de détail », les conditions d’accès et le mode de facturation ne sont pas précisés, et l’étendue réelle de disponibilité de « Jinghui » doit être confirmée auprès de JD Logistics. Il faut préciser que le grand modèle « Super Brain » 3.0 de JD Logistics ne figure pas actuellement dans le catalogue de modèles de KimiSeek ; notre site n’en propose pas de fiche correspondante, et cet article ne le considère pas comme un modèle appelable sur notre site. Les services externes mentionnés, leur disponibilité, leurs spécifications et leur facturation relèvent des indications de JD Logistics. Si ce système venait à publier une API ou des poids, l’opportunité de l’intégrer devrait encore être évaluée séparément selon les critères mesurables évoqués plus haut.
Illustrations de l’article original