JetBrains ouvre Mellum2.1 en Apache 2.0 : modèle MoE 12B pour agents de code, avec versions quantifiées
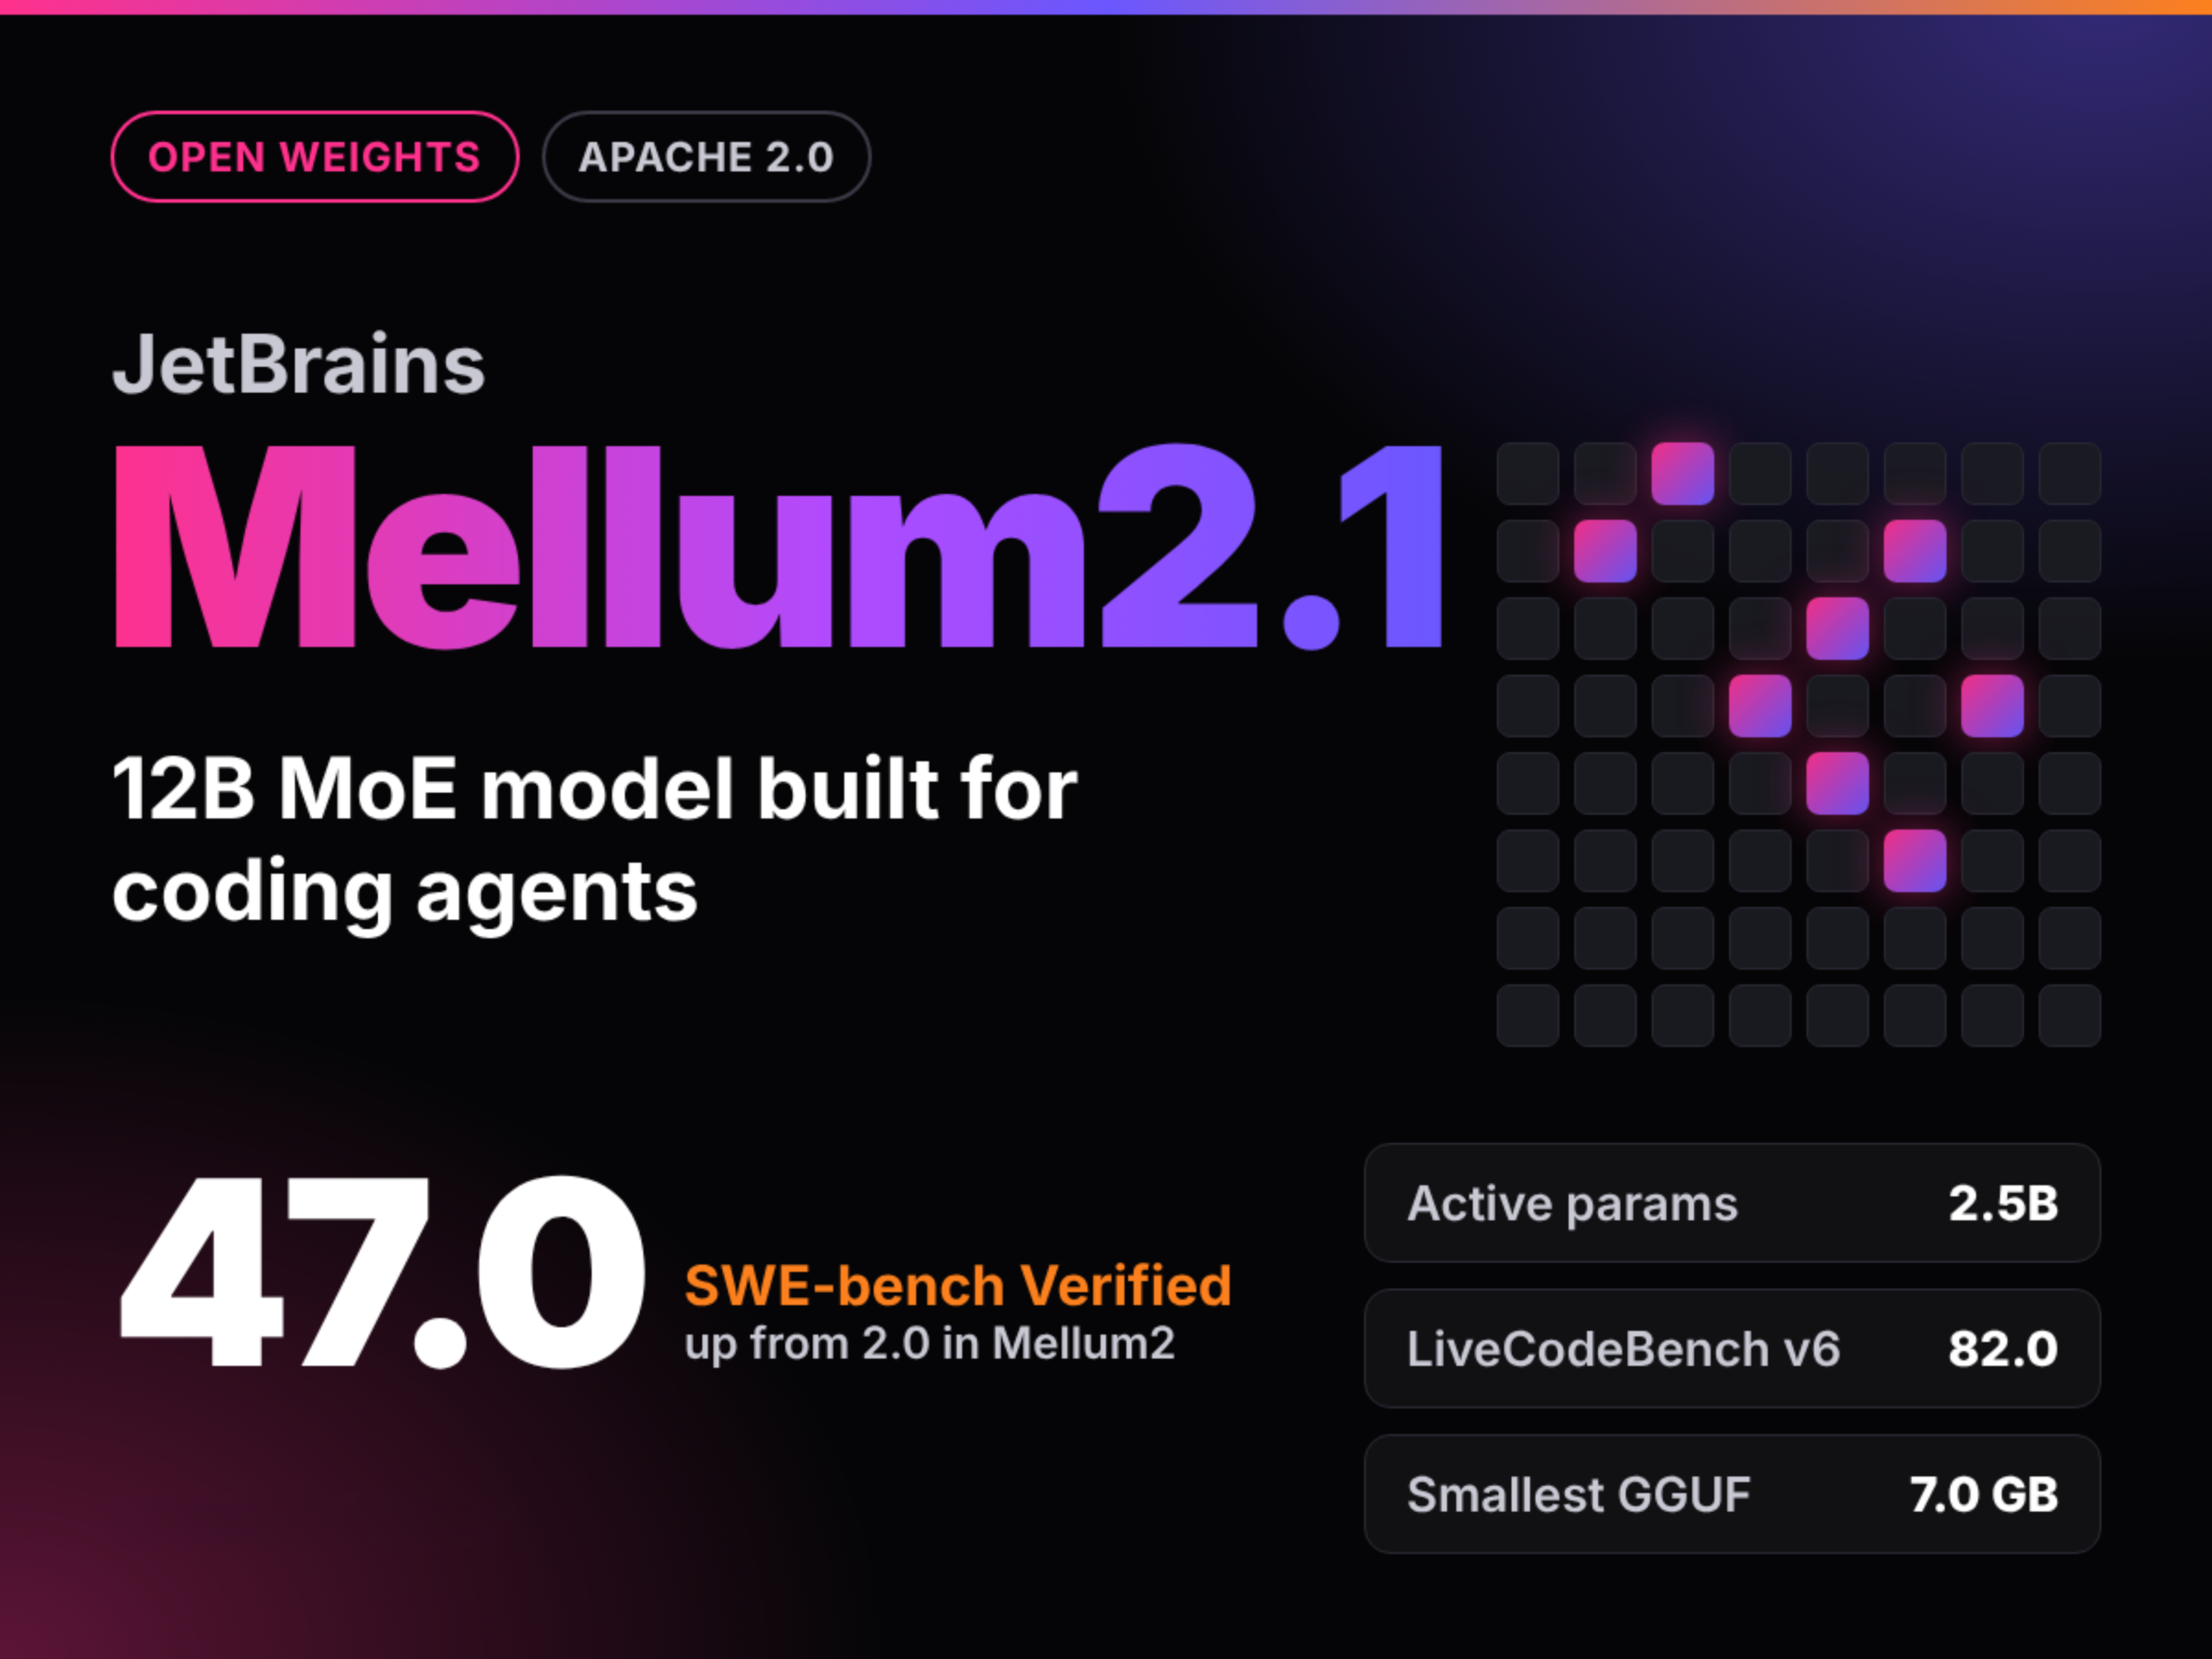
Selon un article de MarkTechPost du 8 octobre 2026, JetBrains publie Mellum2.1 sous licence Apache 2.0, à savoir Mellum2.1-12B-A2.5B-Thinking : un modèle de raisonnement MoE de 12B de paramètres totaux et 2,5B activés par token. L'architecture reste identique à celle de la génération précédente ; les gains proviendraient principalement de l'apprentissage par renforcement sur de vrais dépôts de code, avec un score SWE-bench Verified rapporté passant de 2.0 à 47.0.
Ce qui change
Selon un article de MarkTechPost du 8 octobre 2026, JetBrains publie Mellum2.1, sous le nom de point de contrôle Mellum2.1-12B-A2.5B-Thinking, avec des poids diffusés sur Hugging Face sous licence Apache 2.0. Il s'agit d'un modèle de raisonnement à mélange d'experts de 12B de paramètres totaux et 2,5B de paramètres activés par token, à 28 couches, 64 experts, 8 activés par token, avec GQA (32 têtes de requête, 4 têtes KV), une fenêtre glissante de 1024 tokens sur trois couches sur quatre, un contexte de 131072 tokens, un vocabulaire de 98304 et des poids en bfloat16. L'article indique que l'architecture est inchangée par rapport à Mellum2 Thinking, publié en open source en juin 2026, et que la mise à niveau vient presque entièrement du post-entraînement : le RL devient le cœur de l'entraînement, avec des tâches ajoutées en mathématiques, programmation compétitive, sciences, appel d'outils et ingénierie logicielle, l'entraînement s'effectuant dans de vrais dépôts de code avec des outils shell et d'édition de fichiers, une récompense étant attribuée en cas de réussite des tests. L'article rapporte que, selon les tests internes de JetBrains, SWE-bench Verified passe de 2.0 à 47.0, SWE-bench Pro de 0.0 à 28.0, Terminal-Bench 2.1 de 0.6 à 17.4, LiveCodeBench v6 atteint 82.0, BFCL v4 62.3, et HarmBench descend de 21.5 à 8.5 ; Qwen3.5-9B resterait en tête sur SWE-bench Verified (50.0), SWE-bench Pro (38.0), GPQA Diamond (77.8) et AIME 25/26 (86.7).
Conséquences pour les développeurs
L'intérêt de cette publication pour les agents de code auto-hébergés tient à trois points, qui reposent tous sur les déclarations de l'article et non sur une reproduction indépendante. Premièrement, le modèle est diffusé en open weights sous Apache 2.0 : il s'agit d'une publication à licence explicite, et non de simples poids téléchargeables ; mais tous les scores de benchmarks cités sont auto-déclarés par JetBrains, et les valeurs LiveCodeBench v6 et GPQA Diamond de la fiche officielle de Qwen pour le même modèle diffèrent nettement de celles du protocole d'évaluation de JetBrains, ce qui montre que les scores sont sensibles au cadre d'évaluation et ne peuvent pas être traités comme des conclusions comparables entre fournisseurs. Deuxièmement, 2,5B de paramètres activés, un contexte de 131072 tokens et des quantifications GGUF rendent un sous-agent local envisageable sur un poste grand public ou une seule carte : l'article liste des versions BF16 de 24,3 GB, Q8_0 de 12,9 GB, Q4_K_M de 8,1 GB (taux de correspondance du premier token de 88,0 %) et MXFP4_MOE de 7,0 GB (85,6 %). Ce qui doit retenir l'attention des développeurs n'est pas la taille d'un fichier, mais de savoir si la dégradation de capacité après quantification reste dans la tolérance de leurs tâches. Troisièmement, l'article rapporte qu'avec une seule H200 sous forte charge, le débit approche le double de Qwen3.5-9B, et que le MTP apporte environ 1,6x d'accélération en requête unique, mais la tête MTP destinée au décodage spéculatif vLLM est annoncée comme à venir, ce qui signifie que les déploiements actuels ne peuvent pas exploiter directement cette accélération. Pour les équipes qui utilisent des agents de code, il s'agit plutôt d'un candidat comme unité d'exécution à faible coût que d'un remplaçant principal pour l'inférence générale : l'article montre qu'il reste en retrait sur Terminal-Bench 2.1 et les benchmarks de connaissances.
Intégration et évaluation
Il est conseillé de valider par couches selon les tâches, plutôt que de remplacer toute la pile. Décision un : si la charge de travail est de la complétion de code ou une unité d'exécution de sous-agents à forte concurrence et en étapes courtes, on peut évaluer en priorité un déploiement MoE à 12B/2,5B activés, à condition de disposer de plus de mémoire GPU qu'une seule carte et d'un environnement vLLM ou SGLang ; l'article indique un lancement avec vLLM et --reasoning-parser qwen3, l'appel d'outils nécessitant --enable-auto-tool-choice --tool-call-parser hermes, et des paramètres d'échantillonnage conseillés de temperature 0.6, top_p 0.95, top_k 20 ; les indicateurs à mesurer devraient être le débit par token et le coût par tâche à matériel équivalent, et non les seuls scores de benchmarks. Décision deux : si la charge de travail est une réparation à l'échelle du dépôt sur une longue chaîne, il est conseillé de commencer par une comparaison sur petit échantillon avec ses propres dépôts, face à des modèles comme Qwen3.5-9B, en comparant taux de réussite des tâches et modes d'échec, car le SWE-bench Verified auto-déclaré de 47.0 est inférieur au 50.0 de Qwen3.5-9B et l'écart sur Terminal-Bench 2.1 est plus marqué ; la condition ici est que l'entreprise dispose déjà d'un ensemble de tests jugeable automatiquement ; les indicateurs sont le taux de réussite de bout en bout et le nombre moyen d'étapes. Décision trois : pour des scénarios locaux ou hors ligne, on peut d'abord essayer les versions quantifiées Q4_K_M et MXFP4_MOE, à condition que les tâches soient peu sensibles aux écarts de comportement sur le premier token ; les indicateurs sont le taux de correspondance du premier token et l'écart de justesse réelle entre la version quantifiée et la référence BF16 sur son propre jeu de prompts. À noter également : la disponibilité décrite dans l'article renvoie aux poids publiés par le fournisseur et au support des frameworks d'inférence ; les modalités d'intégration suivent la documentation de chaque framework.
Limites et points à confirmer
Les limites essentielles doivent être précisées : Mellum2.1 n'apparaît pas dans le catalogue de modèles en temps réel de KimiSeek ; cette version n'est pas disponible sur KimiSeek, et les poids, les GGUF et les modes de déploiement vLLM/SGLang mentionnés dans l'article renvoient à la publication de JetBrains et ne signifient pas qu'ils sont disponibles sur ce site. Tous les chiffres de performance proviennent de déclarations de JetBrains ou de son protocole d'évaluation unifié, y compris SWE-bench, Terminal-Bench, LiveCodeBench et BFCL, sans reproduction indépendante ; l'article lui-même signale que la fiche officielle de Qwen et l'évaluation de JetBrains donnent des valeurs différentes pour le même modèle, ce qui invite à la prudence dans les conclusions de comparaison transversale. Le taux de correspondance du premier token des versions quantifiées n'équivaut pas au taux de justesse des tâches ; la liste GGUF de l'article et la mention selon laquelle « les GGUF sont encore en préparation » présentent des divergences de formulation, et il convient de vérifier soi-même les fichiers réellement disponibles et leur qualité. La tête MTP est annoncée comme à venir ; l'accélération par décodage spéculatif vLLM n'est pas disponible actuellement. Enfin, pour les prix d'appel et les modalités de facturation, se référer à la page tarifaire du fournisseur ; cet article ne cite aucun chiffre précis.