DataCanvas met en open source Alaya-DFlash2, sa solution de décodage spéculatif pour GLM-5.3, et annonce un décodage 3.41 fois plus rapide sur 32k de contexte
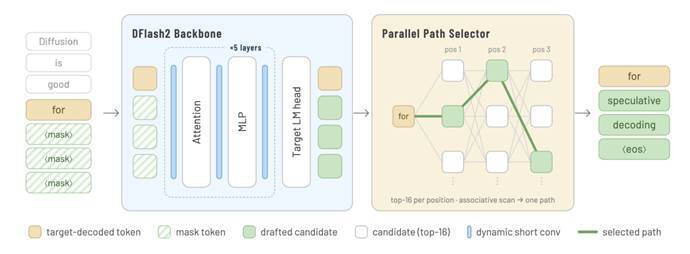
Selon un article d'InfoQ daté du 20 octobre 2026, DataCanvas a publié Alaya-DFlash2, une solution d'accélération par décodage spéculatif destinée à GLM-5.3, comprenant un modèle de brouillon capable de rédiger en parallèle et un mécanisme de sélection de chemin, avec mise à disposition publique des poids. Les évaluations du fournisseur indiquent une vitesse de décodage en concurrence unique 3.41 fois supérieure à l'autorégression native sur 8×H200 avec TP=8, et des longueurs d'acceptation supérieures aux deux solutions comparées sur des contextes à faible entropie de 1k à 32k. Ces chiffres et comparaisons proviennent tous de tests réalisés par le fournisseur lui-même et attendent encore une reproduction par un tiers.
Ce qui change
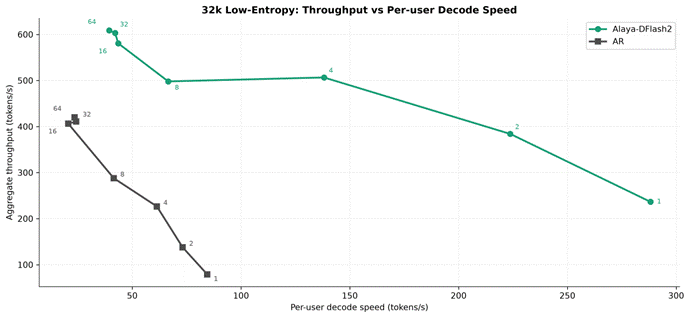
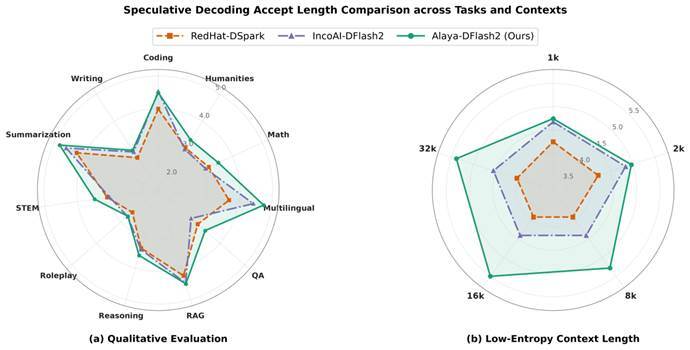
Selon un article d'InfoQ daté du 20 octobre 2026, DataCanvas a lancé Alaya-DFlash2, une solution d'accélération par décodage spéculatif destinée à GLM-5.3, composée d'un modèle de brouillon pouvant rédiger en parallèle et d'un mécanisme de sélection de chemin. Les poids sont publiés sous le nom AlayaNeW/GLM-5.3-DFlash2, l'article ne précisant pas les termes de la licence open source retenue. D'après l'article, la solution s'appuie sur le moteur de calcul intelligent AlayaNeW de DataCanvas pour entraîner un modèle de brouillon adapté à GLM-5.3. Côté évaluation, l'article donne des données obtenues dans un environnement 8×H200 avec TP=8 : une vitesse de décodage en concurrence unique d'environ 288.2 tokens/s, contre environ 84.5 tokens/s en autorégression native, soit un facteur 3.41 ; le débit de sortie total correspondant passe de 78.95 à 236.47 tokens/s. L'avantage se resserre lorsque la concurrence augmente : à 4 requêtes simultanées, le débit est 2.24 fois celui de l'autorégression native ; à 64 requêtes simultanées, il atteint 608.71 tokens/s, soit une hausse de 44.9 % par rapport aux 420.13 tokens/s de l'autorégression native. L'article liste également les longueurs d'acceptation sur contextes à faible entropie : 4.74, 4.97, 5.28, 5.50 et 5.39 respectivement pour 1k, 2k, 8k, 16k et 32k, toutes supérieures à celles d'IncoAI-DFlash2 et de RedHat-DSpark, les deux solutions mises en comparaison. Il affirme en outre que la longueur d'acceptation arrive en tête sur 9 des 11 catégories de tâches, les deux catégories restantes, code et jeu de rôle, restant proches d'IncoAI-DFlash2.
Conséquences pour les développeurs
Pour les développeurs, l'intérêt concret du décodage spéculatif tient au fait qu'il modifie la structure de coût de la génération sur un matériel identique, et non les capacités du modèle lui-même. Selon les chiffres de l'article, la longueur d'acceptation des brouillons se maintient autour de 5 sur les scénarios à long contexte, ce qui signifie qu'une seule passe avant du modèle principal permet de vérifier et de valider environ 5 tokens candidats, réduisant le nombre de cycles de décodage du modèle principal et comprimant directement l'attente sur la sortie continue après le premier caractère. Pour les équipes qui exploitent leur propre service d'inférence GLM-5.3, cela revient à gagner du débit de décodage sans changer de modèle principal ni modifier la distribution des sorties, au prix du chargement supplémentaire d'un jeu de poids de modèle de brouillon, avec la mémoire GPU et la charge d'ordonnancement associées. L'article montre par ailleurs que le gain varie avec la concurrence : l'amélioration de vitesse est maximale en concurrence unique, alors qu'à 64 requêtes simultanées la hausse du débit total se réduit à 44.9 %, ce qui indique que les bénéfices de la solution se manifestent surtout dans les scénarios interactifs à faible concurrence, l'apport unitaire de débit restant relativement limité pour les services à forte concurrence. Il faut noter que tous les chiffres proviennent de tests internes du fournisseur, que l'environnement de test est figé à TP=8 sur 8×H200, que la longueur d'acceptation dépend de la distribution précise des données et que les distributions autres que les contextes à faible entropie peuvent donner des résultats différents ; enfin, la publication des poids n'équivaut pas à des termes de licence clairs, et il reste nécessaire de vérifier les informations de licence du dépôt avant tout usage commercial.
Intégration et évaluation
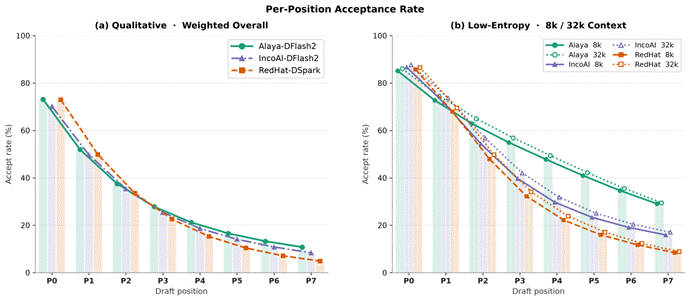
Il est conseillé d'arbitrer selon les conditions suivantes plutôt que de reprendre telles quelles les conclusions de l'évaluation. La première décision porte sur l'adoption ou non de ce modèle de brouillon. Si la charge d'inférence est dominée par des cas à long contexte et à concurrence faible à moyenne, comme les questions-réponses sur documents longs ou la synthèse en RAG, les données de l'article montrant des longueurs d'acceptation supérieures à 5 entre 16k et 32k justifient un test comparatif sur du trafic réel ; si la charge est dominée par des requêtes courtes à forte concurrence, la hausse de débit de seulement 44.9 % à 64 requêtes simultanées rapportée par l'article impose de calculer d'abord si la mémoire GPU supplémentaire et le coût d'ordonnancement induits par le modèle de brouillon en valent la peine. Le critère d'évaluation peut être le suivant : mesurer sur ses propres échantillons de 32k la longueur d'acceptation réelle et la latence entre tokens, et renoncer à l'adoption si la longueur d'acceptation est nettement inférieure au niveau annoncé ou si le surcroît de mémoire GPU fait baisser le plafond de concurrence. La seconde décision porte sur la configuration du nombre de positions de brouillon et du lot de vérification. L'article montre que le taux d'acceptation reste appréciable en fin de brouillon (49.43 % à la 5e position et 29.51 % à la 8e position sur 32k), ce qui plaide pour régler la profondeur de vérification au-delà de la valeur par défaut ; mais ce gain suppose que le taux d'acceptation des positions terminales se maintienne sur ses propres données, car s'il chute rapidement sur des types de tâches où l'article ne revendique pas d'avance, comme le code ou le jeu de rôle, allonger le brouillon ne fera que gaspiller de la puissance de calcul. Le critère d'évaluation peut être le suivant : relever le taux de validation position par position, repérer la position à laquelle le taux d'acceptation passe sous le seuil fixé et tronquer la longueur de brouillon en conséquence. Toutes ces recommandations sont conditionnelles et fondées sur les données de l'article ; il ne s'agit pas de conclusions de déploiement émises par le fournisseur.
Limites et points à confirmer
Toutes les données de performance de l'article proviennent de tests internes de DataCanvas, sans reproduction par un tiers et sans divulgation du jeu de données de test, des modèles de prompt ni des paramètres de décodage ; la longueur d'acceptation dépend fortement de la distribution des données et ne se reproduira pas nécessairement sur son propre trafic. L'environnement d'évaluation est figé à 8×H200 avec TP=8, et le comportement sur d'autres matériels ou d'autres configurations de parallélisme reste inconnu. L'ouverture revendiquée par l'article se limite à une adresse de poids, sans indication du type de licence : la disponibilité des poids n'implique pas que les termes de licence autorisent un usage commercial ou une redistribution sans restriction, et c'est la déclaration du dépôt qui fait foi. Par ailleurs, Alaya-DFlash2 est une solution de modèle de brouillon indépendante destinée à GLM-5.3, à distinguer du modèle principal lui-même : GLM-5.3 figure bien dans le catalogue actuel de KimiSeek, mais la solution d'accélération Alaya-DFlash2 n'y est pas proposée comme modèle appelable, et sa disponibilité doit être vérifiée auprès du fournisseur et du dépôt de poids.
Illustrations de l’article original