Kimi K3.1 Pro Highspeed arrive sur Bedrock : effort de raisonnement max par défaut, nuances sur le niveau Flex et le cache explicite
Dans un billet de blog daté du 10 novembre 2026, AWS indique que Kimi K3.1 Pro Highspeed est disponible sur Amazon Bedrock, en réutilisant l'endpoint et l'API de K3 ; Moonshot AI annonce une vitesse de sortie 2 à 3 fois supérieure à celle de K3.1 Pro. L'effort de raisonnement max par défaut, le coût de latence du niveau Flex et l'indisponibilité du cache explicite sur Converse sont trois points à trancher avant l'intégration.
Ce qui change
Dans un billet du blog Machine Learning d'AWS daté du 10 novembre 2026, l'entreprise annonce que Kimi K3.1 Pro Highspeed de Moonshot AI est disponible sur Amazon Bedrock. Le billet le présente comme une version post-entraînée de Kimi K3 : même architecture à poids ouverts de l'ordre de 3T et même fenêtre de contexte de 1 million de tokens, avec un entraînement utilisant nettement plus de calcul post-entraînement ; selon Moonshot AI, cet entraînement vise les tâches d'agents sur de longues séquences, cherche à réduire les erreurs factuelles et améliore la modélisation financière, les documents bureautiques ainsi que le code destiné aux moteurs de jeu, aux scènes 3D et aux scripts CAO. Le débit de génération de tokens de sortie est plus élevé, Moonshot AI annonçant une vitesse 2 à 3 fois supérieure à celle de Kimi K3.1 Pro. Sur Bedrock, il reprend l'endpoint, l'API et les fonctionnalités de Kimi K3, si bien qu'une application déjà basée sur K3 n'a qu'à changer l'identifiant de modèle ; il prend en charge l'appel d'outils, les sorties structurées, le raisonnement configurable, l'entrée d'images et la sortie en flux, et est accessible via trois profils d'inférence inter-régions (global, us, in), les exigences de résidence des données déterminant le choix du profil. AWS indique que les données sont traitées dans son périmètre de données, ne sont ni partagées avec Moonshot AI ni utilisées pour entraîner des modèles, que la rétention nulle des données est toujours activée pour les requêtes d'inférence et que les opérateurs ne peuvent pas consulter les prompts ni les complétions pendant l'inférence. La série K3.1 avait déjà été évoquée ; ce qui s'ajoute ici, c'est le canal hébergé Bedrock et les options d'inférence et de facturation qui l'accompagnent.
Conséquences pour les développeurs
L'effet concret sur l'intégration porte sur la forme de l'interface et les valeurs par défaut, pas sur les capacités du modèle. Les équipes qui utilisent déjà le SDK OpenAI peuvent pointer base_url vers l'endpoint du runtime Bedrock et changer le nom du modèle, mais l'authentification passe par un jeton bearer de courte durée généré à partir des identifiants AWS ; IAM doit accorder InvokeModel et InvokeModelWithResponseStream, et l'usage du jeton bearer requiert en plus CallWithBearerToken. Bedrock propose à la fois Chat Completions et Responses, compatibles OpenAI, ainsi que ses propres Converse et Invoke, AWS recommandant les premiers. Deuxième changement : le raisonnement est poussé au maximum par défaut. Le modèle raisonne toujours avant de répondre et, sans réglage d'effort, prend max ; sur des tâches à espace de réponse réduit comme la classification, l'extraction de champs ou les questions-réponses courtes, cela augmente directement la latence et les tokens de sortie ; lors du parsing d'une réponse Converse, il faut aussi sélectionner le bloc de texte, car la réponse peut commencer par un bloc de raisonnement. Troisième point, les niveaux de service : AWS indique que Flex est facturé à la moitié du prix Standard, au prix d'un temps de réponse potentiellement plus long, et que les quotas à la demande sont partagés entre Standard, Priority et Flex, déplacer du trafic vers Flex ne créant pas de quota supplémentaire ; le niveau se précise par requête et une même application peut les mélanger. Quatrième point, les limites du cache côté interface : le cache de prompt explicite s'applique à Chat Completions, Responses et Invoke, mais pas à Converse ; il faut au moins 256 tokens de contenu stable avant le point de rupture, le contenu mis en cache est conservé au moins 30 minutes, l'écriture est facturée à un tarif supérieur à l'entrée standard, la lecture à un tarif réduit et n'entre pas dans le quota de tokens d'entrée par minute. Pour les agents et assistants de code qui renvoient à chaque tour les instructions système, les définitions d'outils et les conventions du dépôt, le taux de succès du cache pèse souvent plus sur la facture que le prix unitaire. L'article explique aussi pourquoi la vitesse de sortie compte davantage dans les agents de code : lire des fichiers, planifier des modifications, éditer du code, lancer des tests et corriger les échecs forment une chaîne d'appels séquentiels où chaque étape attend la fin de la précédente, et produire plus de tokens par unité de temps raccourcit toute la boucle. Il s'agit de changements structurels du côté du canal, qui ne constituent pas une validation indépendante de la qualité du modèle.
Intégration et évaluation
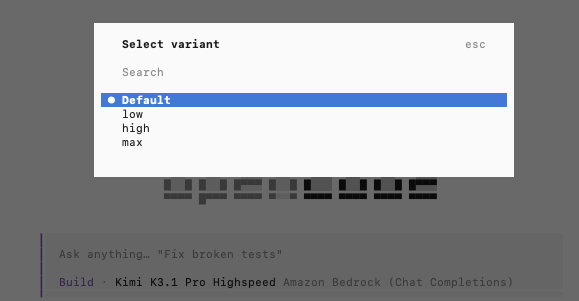
Voici des analyses conditionnelles et recommandations fondées sur ce compte rendu ; elles sont proposées, non vérifiées. Premier choix : inscrire explicitement l'effort de raisonnement dans la configuration. Selon l'article, sans reasoning_effort la valeur par défaut est max, avec low, high et max disponibles, et le même réglage correspond à reasoning.effort sur Responses. Si votre charge est de la classification, de l'extraction de champs, des questions-réponses courtes ou de la réécriture sur modèle, où l'espace de réponse est réduit, il est conseillé de fixer low ou high selon le type de tâche et de ne garder max que sur les chaînes nécessitant réellement un raisonnement multi-étapes. La condition est de disposer de vos propres résultats d'évaluation par niveau, et non de réduire au ressenti ; si la chaîne impose un format de sortie strict, vérifiez aussi que la baisse de niveau ne réduit pas le nombre de champs des sorties structurées. Critère mesurable : comparer, sur le même jeu de questions maison, le taux de réussite et la médiane des tokens de sortie entre low et max ; si la baisse de réussite reste dans une plage acceptable tandis que les tokens de sortie diminuent nettement, inscrivez le niveau dans la configuration au lieu de dépendre du défaut. Deuxième choix : sélectionner le niveau de service par requête et vérifier celui réellement appliqué. AWS indique que Flex peut être plus lent mais moins cher, que le niveau se définit par requête et que les quotas sont partagés entre les trois niveaux. Si vos tâches sont des évaluations hors ligne, des résumés par lots ou des étapes d'arrière-plan d'un agent, insensibles au temps de réponse d'un appel, vous pouvez envoyer une petite part du trafic vers Flex et laisser les requêtes synchrones destinées aux utilisateurs sur Standard ou Priority. La condition est de confirmer, via les dimensions ServiceTier et ResolvedServiceTier de CloudWatch, quel niveau a réellement servi la requête, car demander Flex et être servi par Flex sont deux choses différentes, et mélanger les niveaux modifie à la fois la latence de queue et la consommation de quotas. Critère mesurable : sur un même lot de tâches, comparer la latence p95 et le coût pour mille tâches entre Flex et Standard ; n'augmentez la proportion que si le coût s'améliore et que la latence de queue reste dans votre budget d'expiration. Troisième choix : traiter la disponibilité du cache comme un critère de choix d'interface, et non comme une optimisation a posteriori. Le cache explicite n'est pas disponible sur Converse, il faut au moins 256 tokens de contenu stable avant le point de rupture et le cache est conservé au moins 30 minutes. Si votre service repose déjà sur Converse et que le contexte contient un long préfixe stable (instructions système, définitions d'outils, conventions du dépôt), il faut choisir entre passer à Chat Completions ou Responses pour obtenir le cache explicite et se contenter du cache automatique : la première option peut améliorer le taux de succès, au prix d'un changement de chemin d'appel et d'une facturation de l'écriture du cache à un tarif plus élevé. Critère mesurable : lire d'abord le nombre de tokens mis en cache dans l'usage pour confirmer un taux de succès supérieur à zéro, puis comparer le coût d'entrée et la latence du premier token avant et après activation, tout en vérifiant qu'un léger ajustement de la position du point de rupture ne fait pas s'effondrer le taux de succès. Un autre point gagne à être tranché en revue d'architecture : le profil global coûte moins cher par token que les profils géographiques, mais en cas d'exigence de résidence des données, seuls us ou in sont possibles, et changer après la mise en production affecte la topologie de déploiement. Si vous exploitez déjà Kimi K3 sur Bedrock, la vérification minimale consiste à conserver un jeu de tâches et à solliciter K3 et Highspeed en parallèle, en comparant le temps d'achèvement par tâche et le nombre de nouvelles tentatives après échec, plutôt que de ne regarder que la vitesse du premier paquet.
Limites et points à confirmer
Deux incertitudes doivent être maintenues. D'une part, le facteur 2 à 3 est une vitesse annoncée par Moonshot AI ; le billet AWS ne fournit ni référence, ni méthode de mesure, ni conditions de concurrence, et l'écart réel dépend de la longueur des sorties et du niveau utilisé, sans pouvoir être tenu pour un résultat reproduit indépendamment. D'autre part, l'expression « architecture à poids ouverts de l'ordre de 3T » décrit l'architecture, alors que Bedrock fournit un service d'inférence hébergé : la possibilité de télécharger les poids et leur licence ne peuvent en être déduits et exigent de consulter la publication officielle et le texte de licence de Moonshot AI ; même si les poids sont téléchargeables, des poids ouverts ne valent pas licence open source. Un autre point prête à confusion : selon le texte original, le surcroît de calcul post-entraînement, la réduction des erreurs factuelles et les gains sur la modélisation financière, les documents bureautiques, les moteurs de jeu, la 3D et les scripts CAO sont décrits par rapport à Kimi K3 ; entre Highspeed et la version non Highspeed de K3.1 Pro, la différence donnée ici porte principalement sur le débit de génération de tokens de sortie, l'article ne fournissant ni comparaison capacité par capacité ni données d'évaluation indépendantes pour Highspeed. La conservation du cache « au moins 30 minutes » ne donne qu'une borne inférieure, sans borne supérieure, et le coût de latence de Flex n'est décrit que qualitativement. Les régions prises en charge, les quotas et les prix doivent être vérifiés sur la fiche modèle, la page de disponibilité par région et la page de tarification de Bedrock, qui évoluent ; le catalogue interne comportait déjà une entrée du même nom lors de cette vérification, et ses prix et quotas sont à consulter sur la page de tarification interne, mais l'inscription au catalogue et la disponibilité sur Bedrock sont deux choses distinctes, la première ne validant pas la seconde.
Illustrations de l’article original