Kimi K3.1 Pro : MoE 2,8T/104B, contexte 1M, API en ligne
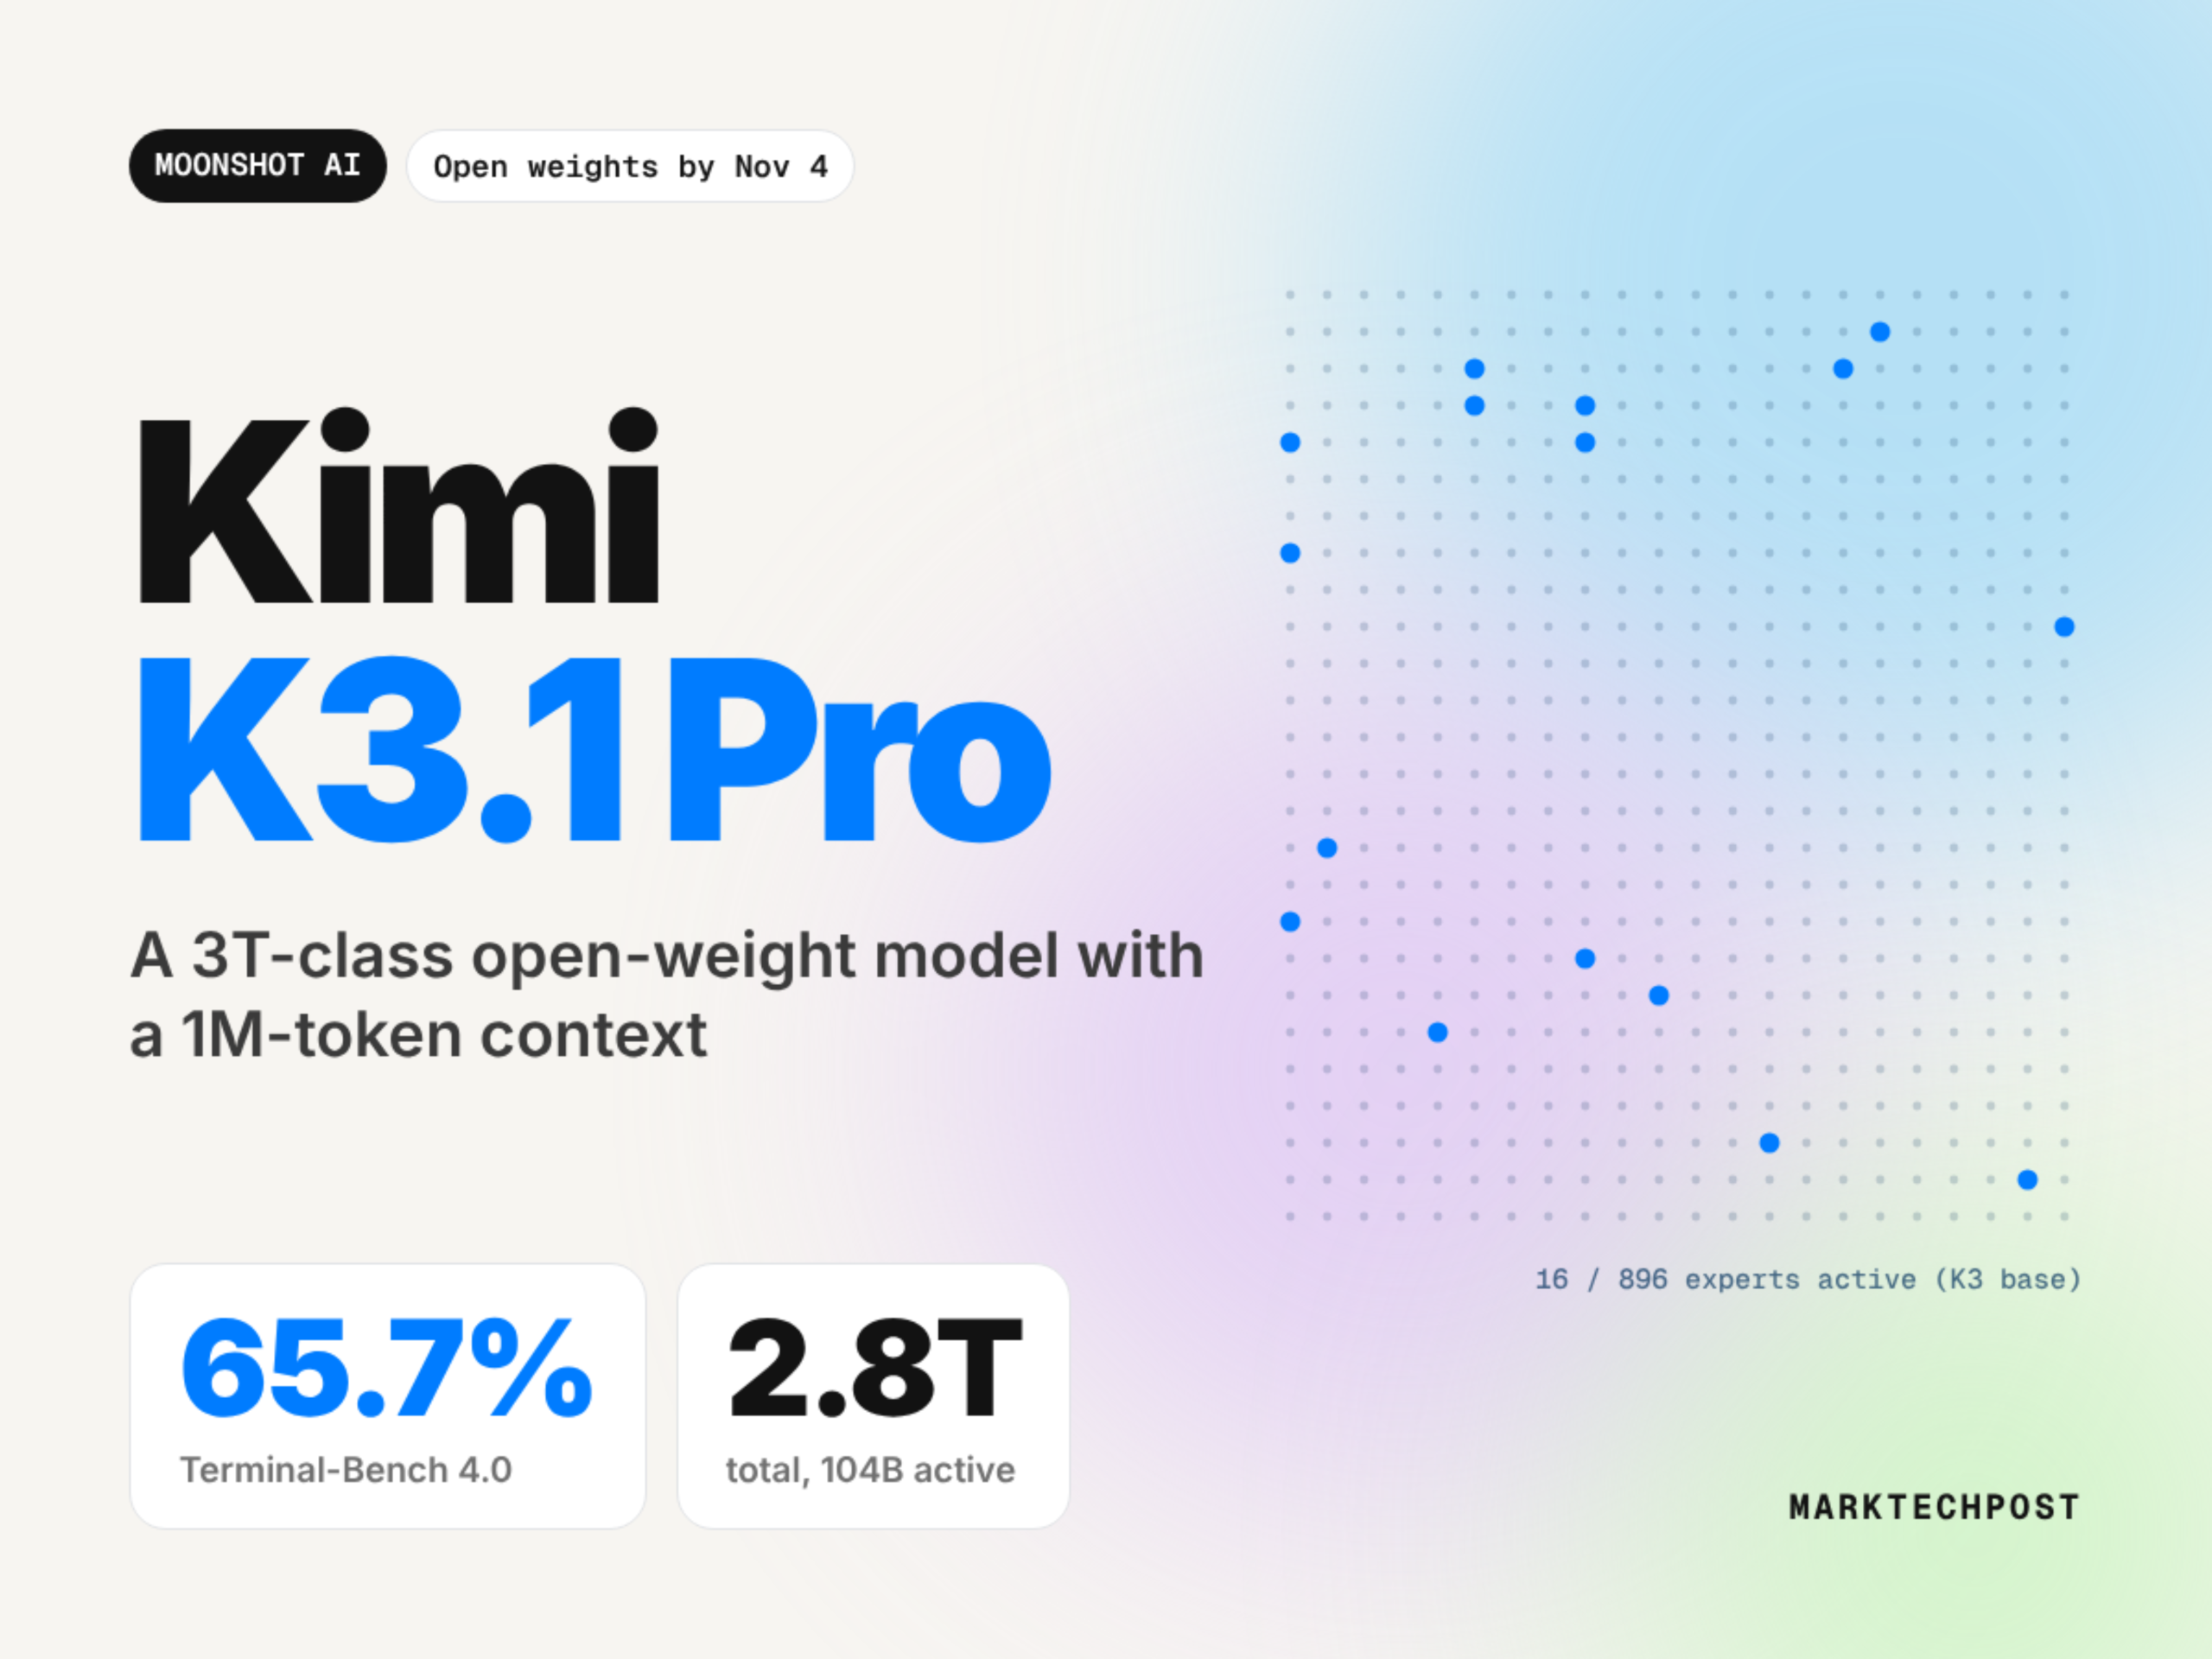
Selon Marktechpost, le 23 octobre 2026, Moonshot AI a publié Kimi K3.1 Pro, premier modèle de la série K3.1, avec une structure MoE de 2,8T de paramètres totaux et 104B activés, un contexte de 1M de tokens, déjà disponible sur l'API Kimi, un tarif API inférieur à K3, et des poids ouverts prévus pour novembre 2026. Ses benchmarks auto-déclarés sont proches de l'état de l'art en codage, mais nettement en retrait sur les tâches scientifiques en terminal.
Ce qui change
Selon Marktechpost, le 23 octobre 2026, Moonshot AI a publié Kimi K3.1 Pro, premier modèle de la série K3.1. Il s'agit d'une version post-entraînée de K3, dont la puissance de calcul de post-entraînement aurait fortement augmenté, avec un apprentissage par renforcement conjoint sur des centaines de domaines aval. La source indique 2,8T de paramètres totaux et 104B activés (MoE) ; l'architecture K3 sous-jacente utilise Kimi Delta Attention et Attention Residuals, active 16 experts sur 896 via Stable LatentMoE, prend en charge un contexte de 1M de tokens, et l'API accepte texte, images et vidéo. Une variante Highspeed a aussi été publiée, que le blog officiel annonce 2 à 3 fois plus rapide. Les identifiants API sont kimi-k3.1-pro et kimi-k3.1-pro-highspeed, avec un point d'accès compatible OpenAI. La source rapporte un tarif API inférieur à K3, avec facturation distincte des succès de cache ; les poids ouverts ne sont pas encore publiés et sont attendus en novembre 2026. Les chiffres de benchmark sont auto-déclarés par Moonshot, la plupart obtenus avec l'effort de raisonnement maximal et le harness Claude Code : Terminal-Bench 4.0 à 65,7 %, SWE-Marathon à 51,7, Terminal-Bench Science 0.1 à seulement 38,1, et sur le benchmark interne Kimi Hallu Bench Hard, les hallucinations au niveau des assertions passent de 23,4 % sur K3 à 8,3 %. La documentation de démarrage rapide liste plusieurs limites pratiques : le mode réflexion est toujours actif, l'effort de raisonnement se décline en low, high et max (max par défaut) ; la température 1,0 et top-p 0,95 sont fixes ; la sortie est par défaut de 131 072 tokens, jusqu'à 1 048 576 ; les entrées visuelles n'acceptent pas d'URL d'image publique, il faut utiliser du base64 ou un identifiant de fichier téléversé.
Conséquences pour les développeurs
L'impact direct pour les développeurs se concentre sur trois points : l'intégration, la structure de coûts et le comportement en contexte long. D'abord, il s'agit du premier modèle de la série K3.1, présenté comme une itération post-entraînée de K3 plutôt qu'une architecture entièrement nouvelle, ce qui pourrait réduire le coût de migration par rapport à un changement de génération, mais les identifiants API et les paramètres du mode réflexion doivent être revérifiés : comme le mode réflexion est toujours actif et que l'effort de raisonnement est max par défaut, les appels qui reposaient sur la désactivation du raisonnement ou un contrôle manuel du budget de réflexion doivent être repensés, sinon la latence et la consommation de tokens seront plus élevées que prévu. Ensuite, la source indique que le modèle accepte texte, images et vidéo via l'API, mais refuse explicitement les URL d'image publiques, exigeant du base64 ou un identifiant de fichier téléversé, ce qui constitue une contrainte réelle pour la construction des requêtes, la taille et le flux de téléversement des pipelines multimodaux. Troisièmement, le contexte de 1M et la limite de sortie allant jusqu'à 1 048 576 tokens permettent d'insérer des dépôts ou journaux plus longs dans une seule requête, mais la source rappelle qu'il faut renvoyer le message assistant complet, et K3 avait averti que supprimer l'historique de raisonnement dans un harness rend les sorties instables ; si l'on continue à tronquer cet historique, le bénéfice du contexte long pourrait être annulé. Côté tarification, la source indique 2 dollars par million de tokens en entrée et 10 dollars en sortie pour la version standard, 4/20 dollars pour Highspeed, tous inférieurs aux 3/15 dollars de K3 — il s'agit de tarifs constructeur rapportés par la source à la date de publication, à vérifier sur la page de tarification KimiSeek et lors de la facturation réelle, les prix pouvant changer. Il faut préciser que K3.1 Pro ne figure pas actuellement dans le catalogue de modèles en direct de KimiSeek ; la disponibilité API mentionnée par la source concerne le côté constructeur.
Intégration et évaluation
Deux décisions indépendantes sont suggérées, à titre d'analyse conditionnelle et non de conclusion de la source. Première décision : migrer ou non un agent de codage ou de terminal existant de K3 vers K3.1 Pro. Les changements rapportés sont une amélioration globale des benchmarks de codage et une baisse des prix, mais un recul marqué sur les tâches scientifiques en terminal. Le choix dépend de la composition de votre charge de travail : si les tâches sont principalement du codage au niveau dépôt, des corrections de type SWE et de l'automatisation de terminal, un déploiement progressif à faible trafic est possible ; si elles incluent une forte proportion de calcul scientifique, de simulation ou de tâches de terminal de recherche, il faut conserver le modèle existant ou router en parallèle. Critère d'évaluation mesurable : comparer sur votre propre jeu de tâches de codage le taux de réussite et la proportion de corrections manuelles entre K3 et K3.1 Pro, en enregistrant le nombre total de tokens nécessaire pour une qualité équivalente, puis convertir le coût par tâche avec la structure tarifaire rapportée ; n'augmenter le trafic que si le taux de réussite ne baisse pas et que le coût par tâche diminue. Deuxième décision : activer ou non la variante Highspeed. Les changements rapportés sont une vitesse 2 à 3 fois supérieure, un prix unitaire plus élevé et un effort de raisonnement fixé à max. Le choix dépend des contraintes de latence interactive : pour la complétion en ligne dans un IDE ou une boucle d'agent nécessitant une alternance humain-machine, si les requêtes tolèrent la longueur de sortie liée à l'effort max fixe, tester Highspeed en priorité ; pour des tâches par lots hors ligne et sensibles au coût, la version standard est plus appropriée. Critère d'évaluation : mesurer sous concurrence fixe la latence de bout en bout P95 et le nombre de tâches terminées par seconde, et calculer si la baisse de latence compense la hausse du prix unitaire. Condition préalable commune aux deux décisions : vérifier d'abord que les limites de paramètres de la documentation de démarrage rapide correspondent à votre client existant, notamment la température et top-p fixes, ainsi que le refus des URL publiques pour les entrées visuelles ; prévoir un interrupteur de retour arrière avant tout basculement, car les poids ouverts ne sont pas encore publiés et l'auto-hébergement est impossible à court terme.
Limites et points à confirmer
À préciser : Kimi K3.1 Pro ne figure pas actuellement dans le catalogue de modèles en direct de KimiSeek ; la disponibilité API mentionnée par la source concerne le côté constructeur, et il convient de se référer à la documentation du constructeur et au catalogue réel avant toute intégration. Les chiffres de benchmark de la source sont pour la plupart auto-déclarés par Moonshot, majoritairement obtenus avec l'effort de raisonnement maximal et le harness Claude Code, et les graphiques comparatifs proviennent de la page de comparaison du constructeur, sans confirmation sur les pages des concurrents ; ils ne doivent donc pas être considérés comme des conclusions de performance indépendamment vérifiées, d'autant que certaines victoires proviennent de benchmarks internes. Le recul marqué sur les tâches scientifiques en terminal est une faiblesse listée par la source elle-même, mais ses valeurs précises relèvent aussi d'une déclaration auto-déclarée. Les poids ouverts sont attendus en novembre 2026, un calendrier rapporté par la source et susceptible de changer ; l'auto-hébergement est actuellement impossible, et l'échelle de 2,8T suggère un déploiement de service multi-nœuds. Les prix sont ceux rapportés par la source à la date de publication et peuvent être ajustés à tout moment. Les limites de paramètres de requête, le mode réflexion toujours actif et la température fixe proviennent de la documentation de démarrage rapide citée par la source ; le comportement réel doit être vérifié dans la documentation la plus récente du constructeur. En outre, cette publication a déjà été couverte récemment ; l'intérêt de cette source réside dans les détails techniques et les contraintes d'intégration qu'elle ajoute, plutôt que dans une confirmation de première parution.