Kyutai publie CADRE, un autoencodeur vidéo : la latence d'action des world models ramenée sous 230 millisecondes, poids interdits d'usage commercial
Selon un article de MarkTechPost daté du 23 octobre 2026, Kyutai publie CADRE, un autoencodeur de représentation par diffusion causale ; l'article scientifique indique que son world model tourne à 20 fps sur une seule H100 et répond en 185 à 216 millisecondes. Le code est sous licence MIT, mais les poids sur Hugging Face sont sous CC BY-NC 4.0, ce qui exclut l'usage commercial, et la source mentionne également des faiblesses telles que le suivi du mouvement en manipulation robotique.
Ce qui change
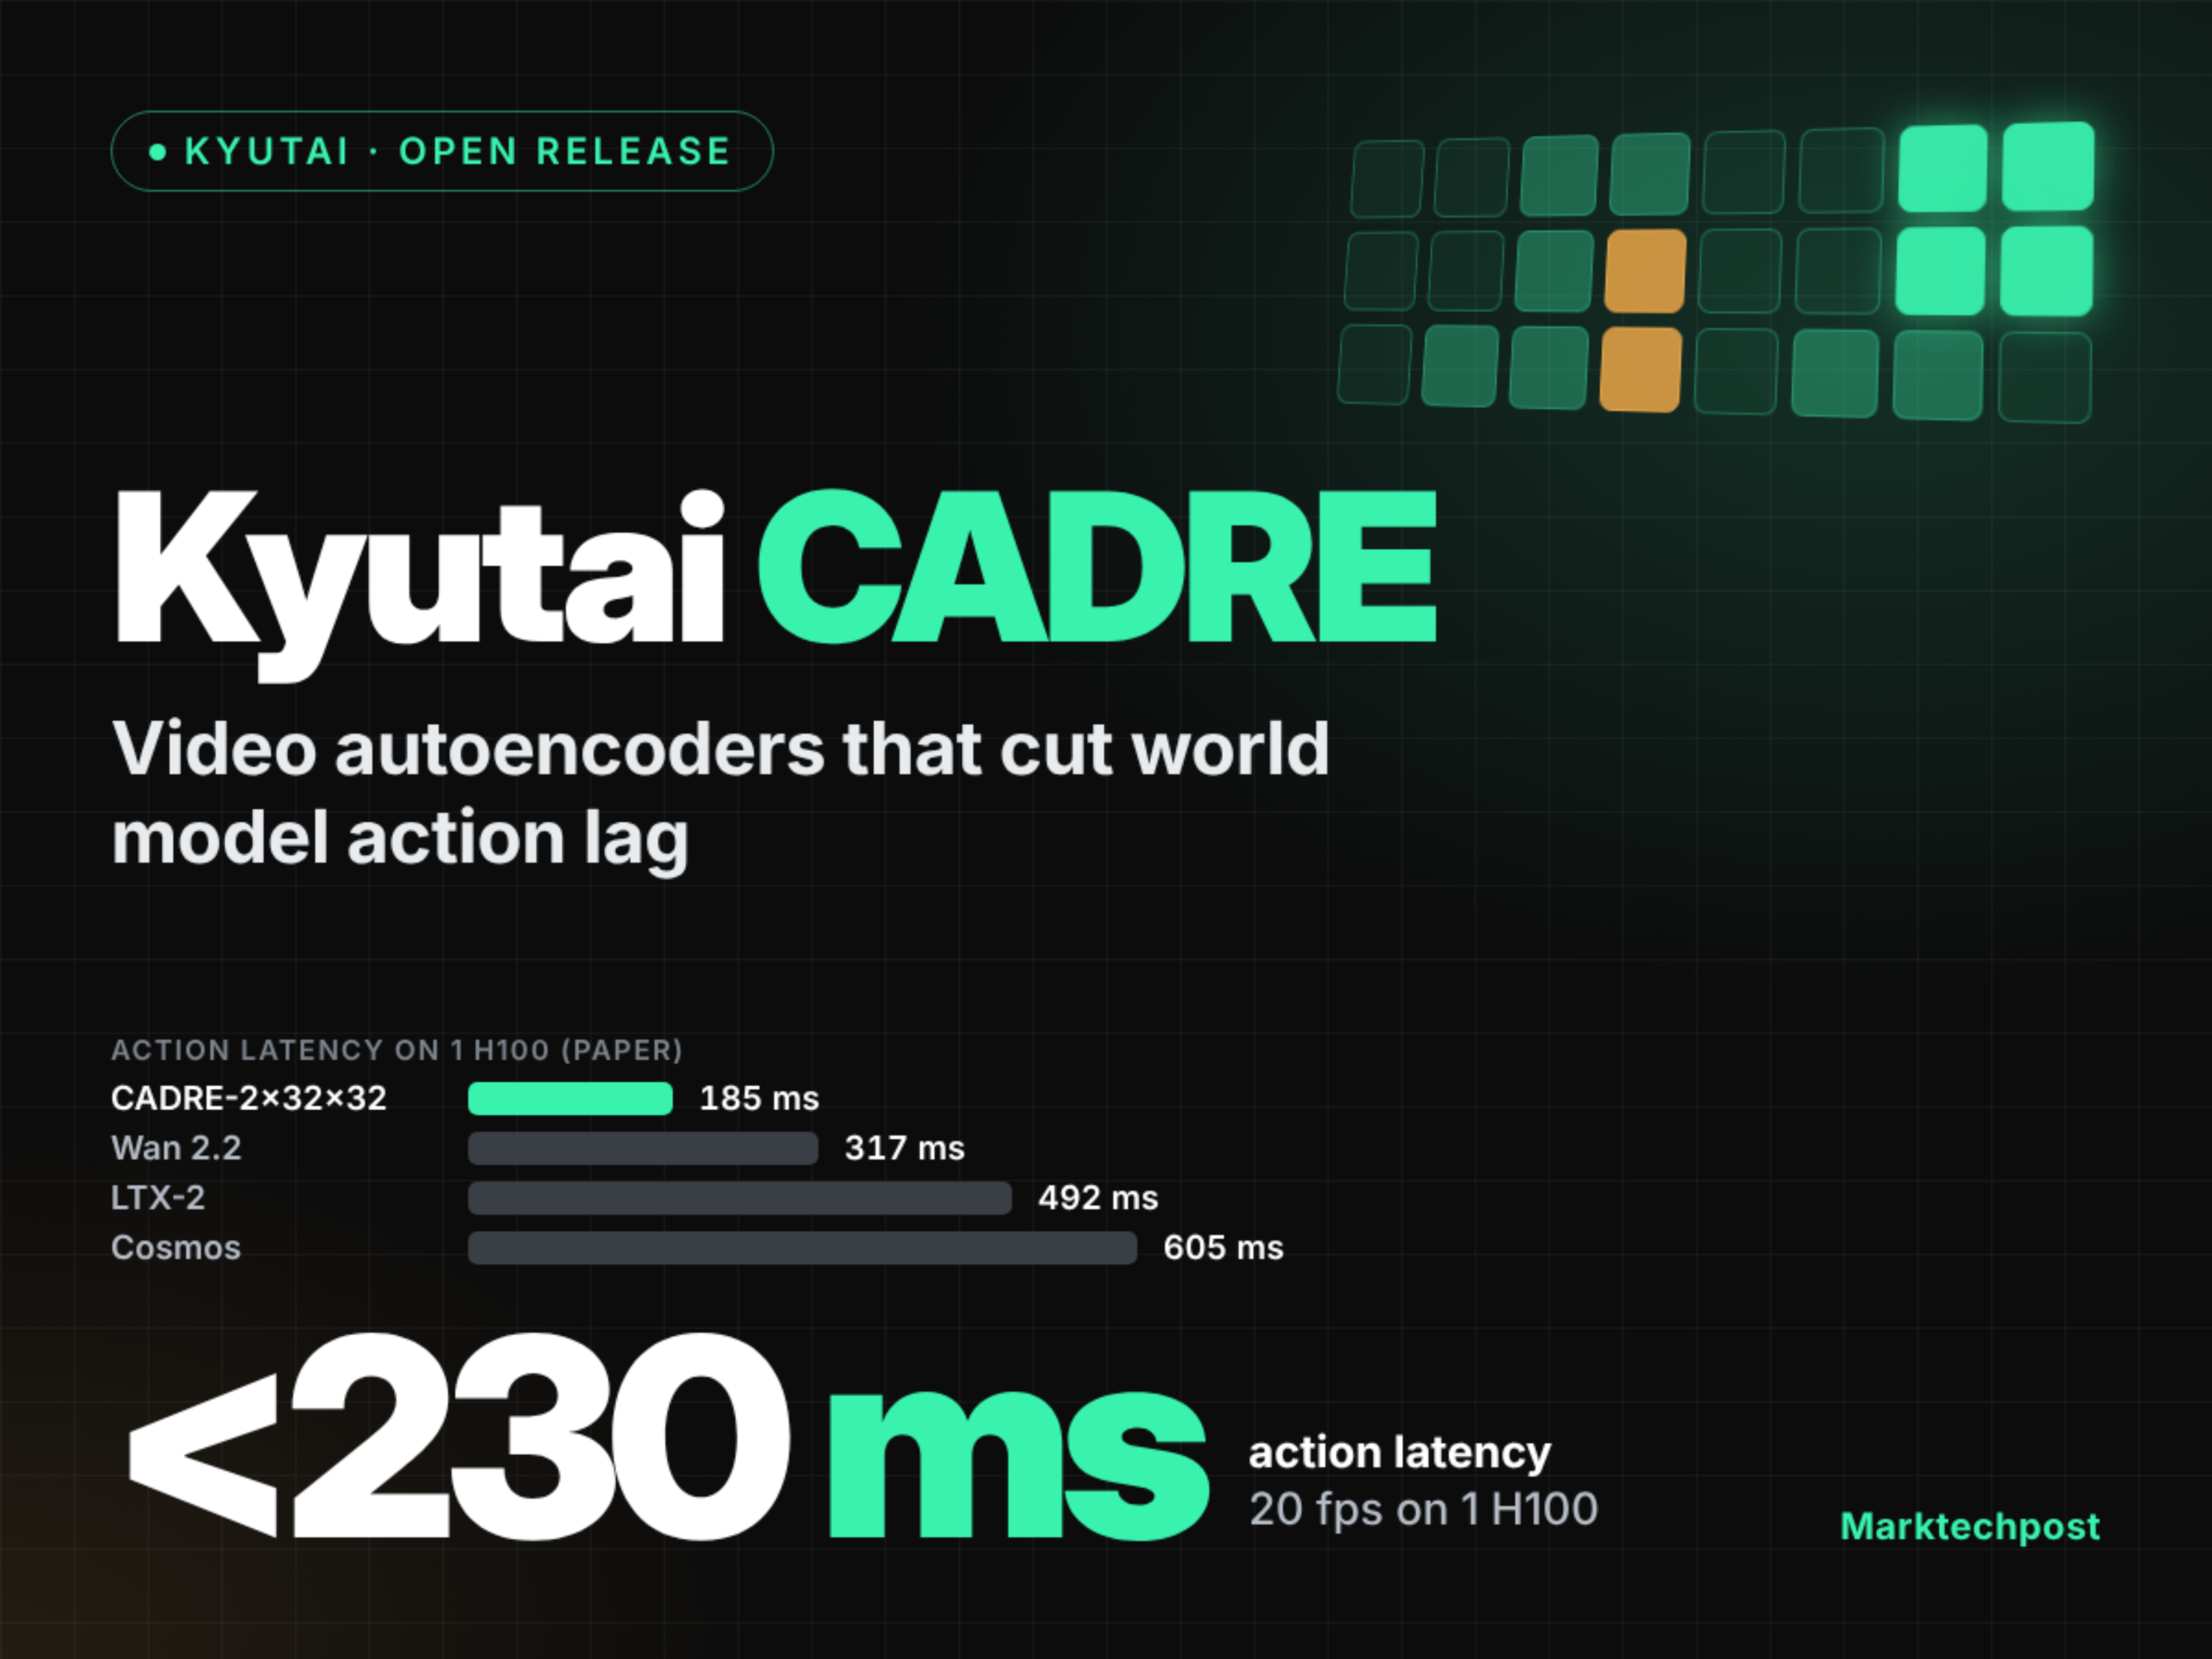
Selon un article de MarkTechPost daté du 23 octobre 2026, Kyutai publie CADRE, un ensemble d'autoencodeurs vidéo destinés aux world models interactifs conditionnés par l'action. Le problème central posé est le suivant : la plupart des world models réutilisent l'autoencodeur de la génération texte-vers-vidéo, qui regroupe plusieurs images dans une variable latente, obligeant chaque action à attendre. Le taux de compression est noté τ×s×s, où τ correspond au nombre d'images par variable latente et s au facteur spatial ; l'article scientifique donne une latence de τ/f plus le temps de génération et de décodage. L'encodeur de CADRE reprend l'approche MIRA : un DINOv3 gelé extrait des caractéristiques patch par patch, qu'une convolution 3D entraînée compresse ensuite en variables latentes de 64 canaux, les 7 membres ne différant que par ce goulot d'étranglement. Le décodeur est un Transformer à diffusion causale de 24 blocs, traité en flux bloc par bloc, qui apprend par auto-distillation progressive à décoder en 1 ou 2 étapes. La source indique que l'autoencodeur a été entraîné sur environ 76 000 heures issues de 23 sources vidéo publiques, couvrant le web, la robotique, la conduite et le jeu vidéo. Les données rapportées montrent que CADRE-2×32×32 répond en 185 millisecondes et maintient 23,4 fps sur une seule H100, en bf16 et avec un batch de 1, tandis que CADRE-2×16×16 atteint 216 millisecondes ; à titre de comparaison, l'autoencodeur de Wan 2.2 est à 317 millisecondes, LTX-2 à 492 millisecondes et Cosmos à 605 millisecondes, DC-AE étant plus rapide mais traitant image par image. Ces chiffres et ces comparaisons sont tous rapportés par Kyutai et n'ont pas été reproduits indépendamment.
Conséquences pour les développeurs
L'impact pratique pour les développeurs se concentre sur trois plans. Le premier est la modification de la composition du budget de latence : CADRE ramène l'attente par blocs de plusieurs centaines de millisecondes, dans le scénario τ=8, à l'ordre de τ=2, ce qui signifie que sous la contrainte de 20 fps et du seuil de 230 millisecondes perceptible par l'œil humain, le budget auparavant absorbé par la latence de découpage peut être réattribué au contrôleur ou au rendu ; cela convient aux simulations interactives et aux évaluations de rejeu robotique sensibles au suivi du mouvement. Le deuxième est que le taux de compression devient une variable explicitement ajustable : les 7 autoencodeurs ne diffèrent que par un goulot d'étranglement, et la source affirme que sur 48 comparaisons, 42 présentent une vitesse équivalente avec une meilleure qualité ; les développeurs peuvent donc traiter le facteur spatial et le facteur temporel comme des réglages indépendants, plutôt que d'accepter la compression fixe d'un VAE vidéo unique. Le troisième concerne les contraintes de licence et de déploiement : le code est sous MIT, mais les poids sont sous CC BY-NC 4.0, et la source précise explicitement que l'usage commercial est exclu ; un produit commercial ne peut donc que s'inspirer de la méthode ou entraîner son propre modèle, sans pouvoir distribuer directement les poids. La source signale en outre que chaque world model couvre un seul environnement en 288×512, que la transférabilité vers un modèle général reste à vérifier, et que les variables latentes longues laissent des coutures visibles entre les blocs, le dépassement de frontière atteignant 1,6 à 1,8 lorsque τ=8. Il s'agit là de conclusions de recherche rapportées par la source.
Intégration et évaluation
Ce qui suit est une analyse conditionnelle fondée sur les informations de la source, et non des faits vérifiés. Première décision : si votre charge de travail concerne des scènes à caméra statique ou lente, vous pouvez privilégier les membres à compression temporelle plus forte, par exemple une configuration à τ plus élevé et facteur spatial plus grossier ; si la caméra se déplace rapidement, vous devriez plutôt vous orienter vers des configurations à moins d'images et facteur spatial plus grand, car la source indique que les caméras en mouvement préfèrent ces dernières et que, dans les scènes de conduite, le FVD de CADRE est nettement meilleur que celui de Wan 2.2. La condition préalable est que votre jeu d'évaluation contienne des modes de mouvement de caméra cohérents avec le scénario de déploiement ; le critère mesurable est de savoir si, sur le même jeu de validation, l'indicateur de suivi du mouvement ARR ou le FVD de conduite atteint le seuil que vous avez fixé, et non de regarder uniquement le PSNR de reconstruction. Deuxième décision : si votre objectif concerne des tâches de manipulation robotique, ne présumez pas que CADRE est globalement supérieur, car la source indique qu'en manipulation robotique l'ARR de CADRE-2×32×32 est de 0,45, contre 0,85 pour Wan 2.2, et que le FVD de Cosmos est également plus faible. Dans ce cas, il convient d'abord de comparer localement les membres candidats par de courts rollouts sur vos données de manipulation robotique, le critère étant que l'ARR ne baisse pas par rapport à la référence et que la latence reste dans votre budget ; si ce n'est pas le cas, conservez d'autres autoencodeurs ou une solution hybride. En matière d'étapes d'évaluation, il est recommandé de reproduire le processus décrit par la source : alimenter d'abord 2 secondes de vidéo réelle, puis générer environ 4,8 secondes, tout en calculant l'ARR avec une sonde d'identification inverse gelée, et en vérifiant si des coutures visibles apparaissent aux frontières de blocs, celles-ci étant plus marquées lorsque τ est grand. Si vous prévoyez d'entraîner votre propre world model, notez que, dans la source, le Transformer à diffusion causale de 1,2 milliard de paramètres est entraîné séparément sur chaque autoencodeur ; changer d'autoencodeur implique donc de réentraîner le modèle aval, et non simplement de remplacer l'encodeur. Avant un déploiement commercial, il convient de vérifier vous-même les termes de la licence des poids et, si nécessaire, de passer à un autoencodeur sous licence permissive comme Apache 2.0.
Limites et points à confirmer
Les latences, fps, FVD, ARR, PSNR et conclusions comparatives de la source sont tous rapportés par Kyutai ; cet article n'a procédé à aucune reproduction indépendante et n'a effectué aucun test. Les versions quantifiées ne sont pas divulguées ; la source ne fournit que des données pour une seule H100 en bf16 et batch de 1, de sorte que la consommation de mémoire GPU, le débit multi-batch et la perte de précision après quantification en déploiement réel restent inconnus. La source indique explicitement que les poids sont sous CC BY-NC 4.0, excluant l'usage commercial, tandis que le code est sous MIT ; ces deux licences sont différentes et ne doivent pas être confondues. La source précise également que chaque world model ne couvre qu'un seul environnement, que la possibilité de transférer les conclusions à un modèle général reste une question ouverte, et que CADRE est plus faible que Wan 2.2 pour le suivi du mouvement en manipulation robotique. Il faut préciser que cette version de CADRE n'apparaît pas actuellement dans le catalogue en temps réel de KimiSeek ; le téléchargement sur Hugging Face et la démonstration en ligne mentionnés par la source relèvent des propres canaux de Kyutai et sont sans lien avec ce site ; en cas d'introduction ou de changement de prix futur, la page tarifaire du site ferait foi.