Liquid AI publie LFM3 : six modèles de classe 2B sur un même squelette, les compromis de l'embarqué en poids ouverts
Selon un billet de blog de Liquid AI du 27 octobre 2026, LFM3 réunit les modèles texte, vision, audio, omni et de décision sur un squelette partagé de classe 1,7B, annoncé entièrement en poids ouverts et ajustable sur un seul GPU ; les développeurs doivent arbitrer entre un modèle omni unique et des petits modèles spécialisés.

Ce qui change
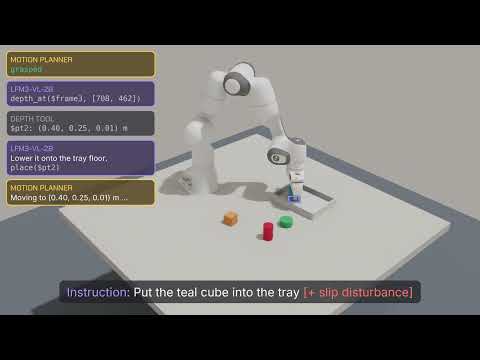
Liquid AI a publié la série LFM3 sur son blog officiel le 27 octobre 2026. Selon le billet, la série comprend six modèles de classe 2B : LFM3-1.7B (texte), LFM3-VL-2B (entrées texte, image et vidéo), LFM3-Audio-2B (entrées texte et audio, sorties texte et parole), LFM3-Omni-2B (entrées omni, sorties texte et parole), ainsi que les modèles de décision d1-2B et d1-omni-2B issus des branches vision et omni ; un LFM3-1.7B-Base est également proposé pour un post-entraînement propre. Le fournisseur affirme que tous les modèles dérivent d'un même squelette, sont disponibles sur Hugging Face et ajustables sur un seul GPU, que le modèle texte occupe environ 1 Go en précision 4 bits et que la fenêtre de contexte du squelette atteint 256K tokens. Le billet donne aussi des chiffres comparatifs, par exemple 38,42 pour LFM3-1.7B sur WebArena-Verified contre 3,02 pour le précédent LFM2.5-2.6B, et une moyenne sur 62 benchmarks visuels passant de 57,6 à 71,4 pour LFM3-VL-2B. Le fournisseur affirme en outre qu'à nombre de paramètres égal, LFM3-1.7B égale LFM2-1.2B sur les prompts courts des appareils en périphérie et serait environ 25 % plus rapide avec un contexte de 8K tokens. Ces chiffres sont tous déclarés par le fournisseur, sans reproduction tierce connue.
Conséquences pour les développeurs
L'impact principal pour les développeurs n'est pas un modèle de plus, mais un changement de granularité dans le choix : pour faire tourner du multimodal sur un appareil, il fallait souvent enchaîner ASR, modèle vision-langage et TTS, là où le fournisseur propose désormais une option omni unique ; il conserve toutefois des modèles unimodaux, ce qui suggère que la fusion multimodale n'est pas toujours rentable. Les contraintes côté inférence changent aussi : le modèle vision exige transformers 5.21.0 ou plus, les modèles audio et omni 5.20.2 ou plus, d1 5.19 ou plus, et la plupart des exemples reposent sur trust_remote_code ; mettre à jour le framework et auditer le code distant personnalisé deviennent donc des préalables à l'intégration. Côté mémoire embarquée, environ 1 Go en 4 bits pour le modèle texte est un chiffre exploitable, mais le billet ne donne pas l'empreinte mémoire des modèles vision et audio ; le coût réel des entrées vidéo et de la sortie vocale en flux doit être mesuré soi-même. Le billet met en avant l'efficacité du nouvel encodeur visuel et de LiquidCodec, avec un premier token audio annoncé à 50 ms et une synthèse vocale environ 87 fois plus rapide que le temps réel sur un seul thread CPU ; ces indicateurs dépendent fortement du matériel et de la longueur des entrées et ne doivent pas servir directement au dimensionnement en production. Le fournisseur propose aussi des notebooks de fine-tuning couvrant SFT, DPO, GRPO et le pré-entraînement continu : pour les équipes ayant besoin de terminologie privée et d'appels d'outils, c'est ce qu'il faut valider en premier, avant les scores de benchmark.
Intégration et évaluation
Recommandation 1 (analyse conditionnelle) : si l'application embarquée doit traiter parole et image dans une même requête, comparez d'abord le modèle omni unique et la combinaison « modèle audio + modèle vision ». Le déclencheur est un lien intermodal réel dans la requête, par exemple une question posée à l'oral devant une image ; si audio et vidéo sont indépendants métier, des modèles spécialisés offrent généralement plus de contrôle. Critère mesurable : sur un même lot d'échantillons réels, comparer la latence du premier token, le temps de bout en bout et le pic mémoire, et vérifier si le modèle omni se dégrade nettement face aux modèles spécialisés sur les sous-tâches purement texte ou purement vocales. Recommandation 2 (analyse conditionnelle) : si vous exploitez déjà un service d'inférence LFM2.5, ne basculez pas sur la seule foi de chiffres fournisseur comme 38,42 contre 3,02 sur WebArena-Verified ; faites d'abord un A/B sur vos propres trajectoires d'agents. Le déclencheur est une charge dominée par les appels d'outils à long contexte ; le billet situe le gain surtout sur les tâches d'agents et le contexte long, la comparaison sur prompts courts étant calculée à nombre de paramètres égal et non une équivalence absolue de performance. Critère mesurable : sur votre jeu de tâches, relever le taux de réussite des appels d'outils, la conformité de format et le temps réel par millier de tokens, plutôt que de se fier aux classements publics. Recommandation 3 (analyse conditionnelle) : si le jugement structuré vous intéresse plus que la génération de texte, évaluez si d1-2B peut remplacer une approche « petit modèle de langage + post-traitement d'analyse ». La condition est que le métier accepte des probabilités calibrées plutôt que du langage naturel ; si l'aval exige du texte explicable, la voie d1 ne convient pas. Critère mesurable : sur des tickets ou factures historiques annotés, calculer l'erreur de calibration par champ et comparer la latence d'une passe avant à celle du pipeline actuel.
Limites et points à confirmer
La source est un billet de fournisseur : scores de benchmark, vitesses et chiffres de mémoire sont auto-déclarés, sans reproduction indépendante ni méthode d'évaluation complète ; la cohérence des comparaisons internes au billet (certaines comparaisons d'encodeurs utilisent un même squelette linguistique LFM2.5-230M) doit aussi être vérifiée. Le billet présente tous les modèles LFM3 comme à poids ouverts, mais ne précise pas les clauses de licence ; des poids ouverts ne valent pas licence open source, et les droits d'usage commercial, de redistribution et de publication après fine-tuning doivent être établis d'après la carte de modèle et le texte de licence, sans les déduire du simple téléchargement des poids. Les modèles LFM3 n'ont actuellement aucune entrée correspondante dans le catalogue en ligne de KimiSeek : cette version n'y est pas disponible ; le billet ne propose pas non plus d'API hébergée, la disponibilité annoncée désignant le téléchargement des poids sur Hugging Face et l'exécution locale. Si un service hébergé ou une tarification distincte apparaît, la page officielle fera foi. Enfin, les exemples reposent sur trust_remote_code : le code distant doit être audité avant la production ; les performances réelles et l'empreinte des entrées vidéo, de la voix en flux et de la traduction vocale multilingue ne sont illustrées que par quelques exemples et demandent une validation propre.
Illustrations de l’article original