Meta ouvre les poids de Muse Spark Open : un MoE de 816 milliards de paramètres exécutable localement sur deux Mac Studio, scores de code inférieurs à GLM 5.3 max et Kimi K3 max
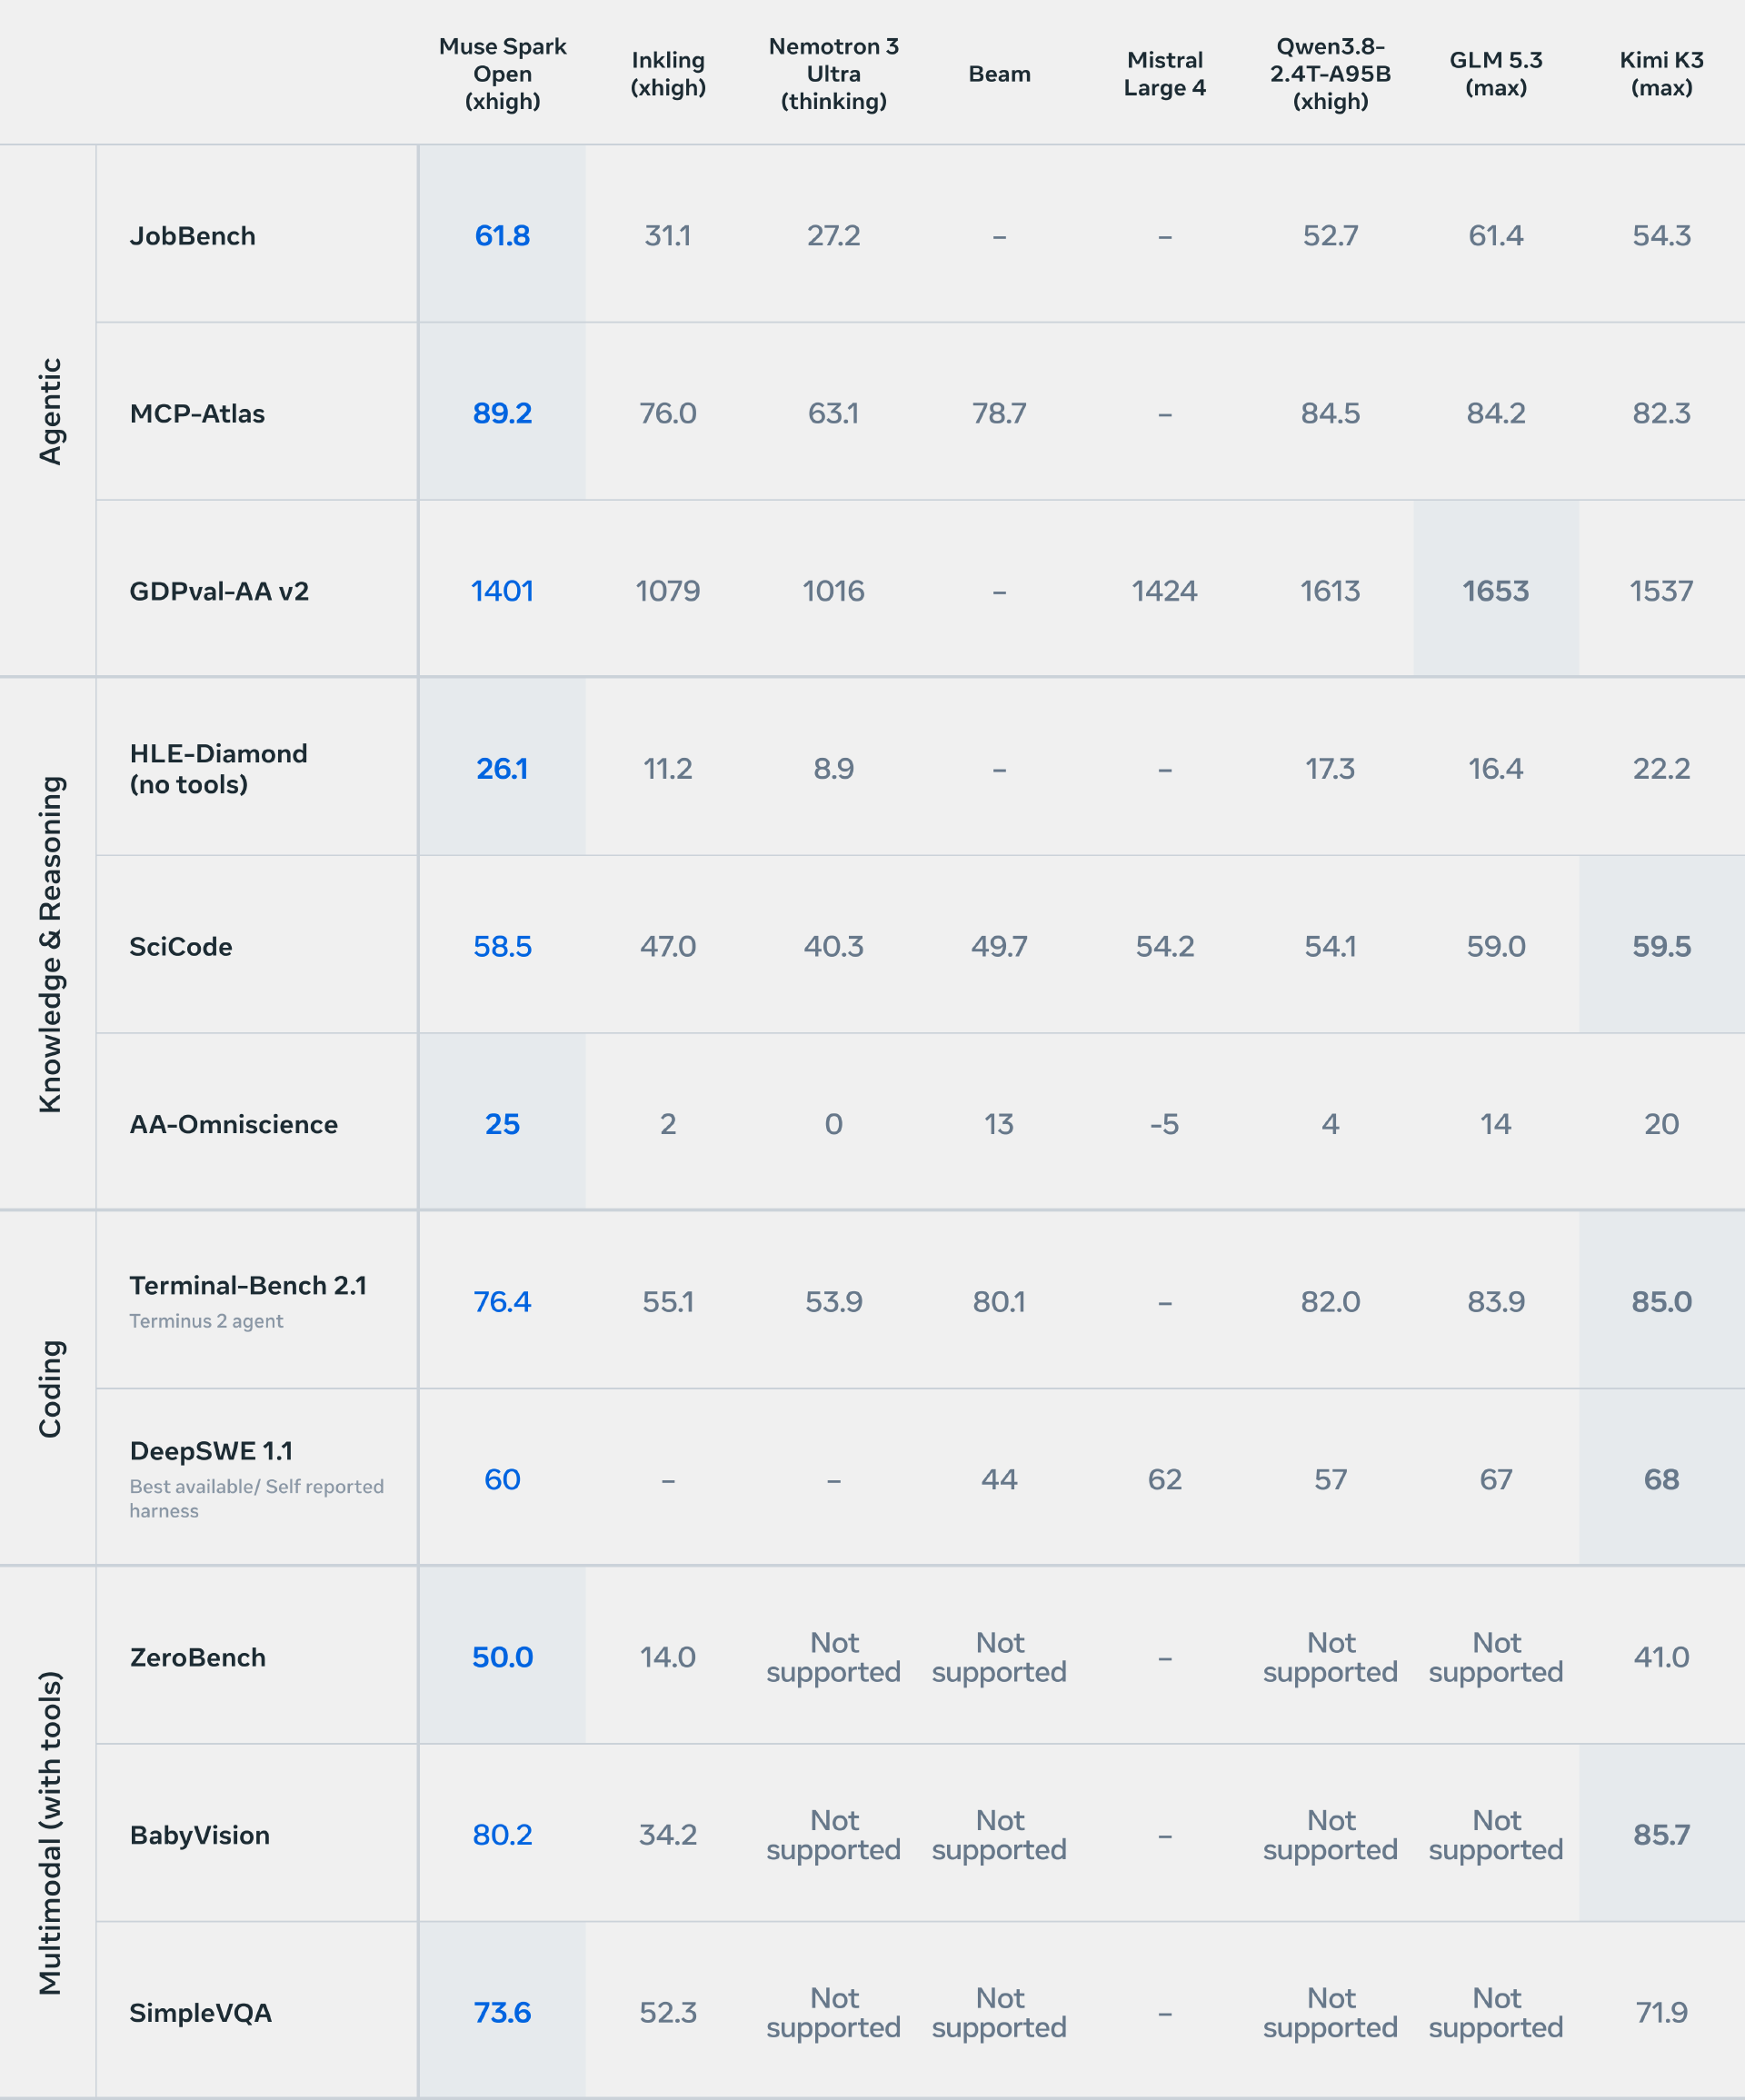
Selon un article d'InfoQ du 18 octobre 2026, Meta a ouvert les poids de Muse Spark Open le 15 octobre : un MoE clairsemé de 816 milliards de paramètres au total et d'environ 42 milliards activés, prenant en charge un contexte d'environ 1,05 million de tokens et des entrées texte, image, audio et vidéo, déployable via MLX sur deux Mac Studio M5 Ultra ; l'article indique que ses résultats à Terminal-Bench 2.1 et DeepSWE 1.1 sont inférieurs à ceux de GLM 5.3 max et Kimi K3 max, sous licence Muse Model License.
Ce qui change
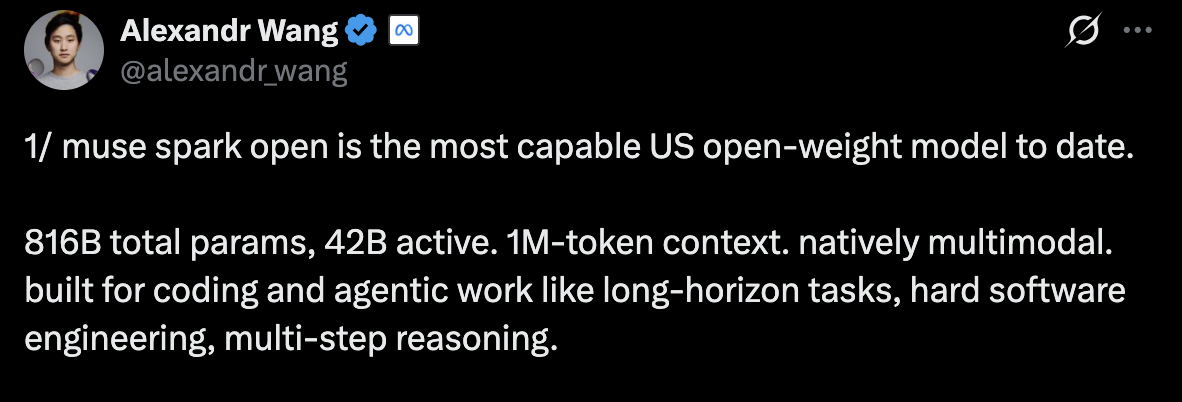
Selon un article d'InfoQ du 18 octobre 2026, Meta a annoncé le 15 octobre (heure locale) l'ouverture des poids du modèle Muse Spark Open, positionné comme un grand modèle d'agent destiné au génie logiciel, à l'exécution de tâches de longue durée et au raisonnement multi-étapes, que Meta présente comme le modèle à poids ouverts américain le plus capable à ce jour. Le modèle adopte une architecture de mélange d'experts clairsemée, avec un total de 816 milliards de paramètres, environ 42 milliards activés par token, un contexte de 1 048 576 tokens, des entrées texte, image, audio et vidéo, et une sortie texte. L'article rapporte les scores publiés par Meta : JobBench 61,8, MCP-Atlas 89,2, OSWorld Verified 80,4, ainsi que pour le code Terminal-Bench 2.1 à 76,4 et DeepSWE 1.1 à 60, et indique que ces deux derniers sont inférieurs à ceux des modèles ouverts chinois GLM 5.3 max et Kimi K3 max. La solution d'exécution locale passe par MLX sur deux Mac Studio équipés de M5 Ultra, et Apple annonce une vitesse de génération supérieure à 36 tokens par seconde dans un test distribué sur quatre machines ; la documentation officielle indique environ 1,65 To pour les poids en BF16 et environ 537 Go en NVFP4. La licence est la Muse Model License, qui exige l'affichage d'une attribution spécifiée et impose aux licenciés dont le chiffre d'affaires annuel cumulé dépasse 20 millions de dollars et qui fournissent le modèle en tant que service une notification et un accord écrit séparé, tout en listant des exceptions pour l'usage interne et la recherche.
Conséquences pour les développeurs
Pour les développeurs, la conséquence directe de cette publication n'est pas « un poids téléchargeable de plus », mais le fait que les variables de décision du déploiement d'un grand modèle se scindent en trois éléments : le stockage des poids, le coût de calcul par token et la communication entre appareils. La distinction entre 816 milliards de paramètres au total et environ 42 milliards activés est essentielle : la première détermine si le modèle tient dans la mémoire, la seconde s'il peut être calculé. Selon les chiffres rapportés, environ 1,65 To en BF16 nécessitent 8 B300, environ 537 Go en NVFP4 nécessitent 4 B300, et le test d'Apple utilise NVFP4 et non BF16 ; cela signifie que la quantification et le parallélisme multi-machines sont des conditions préalables à un déploiement sur poste de travail, aucune ne pouvant à elle seule expliquer le résultat. Par ailleurs, les deux Mac de 512 Go de mémoire chacun mentionnés dans l'article ne fusionnent pas en une machine à adressage unifié d'environ 1 To : la communication inter-machines nécessite RDMA et les communications collectives MLX, de sorte que le gain de mise à l'échelle est limité par la communication. Pour les équipes utilisant déjà GLM 5.3 max ou Kimi K3 max pour le code et les tâches de longue durée, cette comparaison offre un candidat de remplacement ou de complément, mais l'article rappelle que Muse Spark Open n'est pas en tête sur Terminal-Bench 2.1 et DeepSWE 1.1, et que les démonstrations officielles (développement iOS Ice Cubes, sélection image par image dans DaVinci Resolve) relèvent de la vitrine du fabricant et ne peuvent être extrapolées à une exécution sans surveillance sur des tâches similaires.
Intégration et évaluation
Les points suivants sont des recommandations et des analyses conditionnelles fondées sur le contenu de l'article, et non des faits vérifiés. Premièrement, si votre charge de travail consiste en appels d'outils de longue durée et exige que les données ne quittent pas votre machine, vous pouvez d'abord évaluer le taux de réussite de Muse Spark Open via une API hébergée avant de décider de l'auto-héberger ; les partenaires cités dans l'article incluent Baseten, Fireworks AI, Groq, Modal, Nebius, Together AI et OpenRouter, et les outils de déploiement couvrent SGLang, vLLM, TensorRT-LLM, llama.cpp et MLX. La condition pour choisir l'auto-hébergement est de disposer d'accélérateurs compatibles NVFP4 ou de deux Mac à grande mémoire, et l'indicateur à évaluer est l'écart de taux de réussite de bout en bout et de latence par tâche, sur un même ensemble de tâches réelles d'appels d'outils, entre API hébergée et inférence locale. Deuxièmement, pour l'arbitrage entre NVFP4 et BF16, l'article pose comme prémisses environ 537 Go en NVFP4 et environ 1,65 To en BF16 : si votre mémoire GPU ou mémoire unifiée est insuffisante, vous devez passer par NVFP4, au prix d'une vérification de la stabilité après quantification sur de longs contextes ; l'indicateur à évaluer est la baisse de précision de rappel d'informations et du taux de réussite des appels d'outils autour d'une longueur proche de 1,05 million de tokens par rapport au BF16. Troisièmement, si vous fournissez un modèle en tant que service à des tiers et que votre chiffre d'affaires annuel cumulé pourrait dépasser le seuil de 20 millions de dollars mentionné, vous devez vérifier l'applicabilité de la notification et de l'accord écrit séparé avant d'intégrer ce modèle ou un modèle dérivé dans votre activité, et vérifier si les exceptions pour usage interne, recherche et produits propres non fournis en tant que service couvrent votre cas ; il s'agit d'une question de clauses de licence, qui relève d'un jugement juridique et non technique. Quatrièmement, si vous prévoyez de mettre à l'échelle sur plusieurs Mac, n'estimez pas la capacité disponible par la somme des mémoires des machines : l'article indique que la communication inter-machines est un goulot d'étranglement distinct, et l'indicateur à évaluer est de savoir si l'augmentation de la vitesse de génération par token, entre une configuration à deux machines et une à quatre machines, évolue linéairement avec le nombre de machines.
Limites et points à confirmer
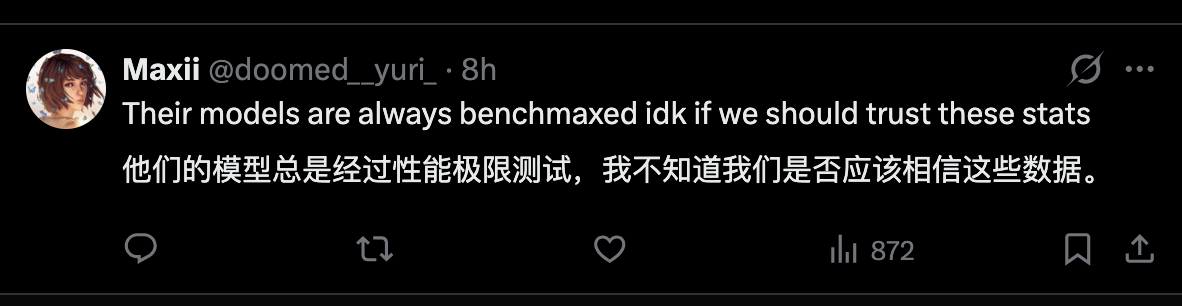
Il faut préciser que Muse Spark Open et sa version 816B-A42B n'apparaissent pas actuellement dans le catalogue de modèles en temps réel de ce site, qui ne dispose d'aucune fiche pour ce modèle ; les disponibilités d'hébergement et d'API mentionnées ci-dessus se réfèrent donc au fabricant et aux partenaires tiers qu'il liste, et non à un accès via ce site. Tous les scores d'évaluation, tailles de poids, configurations matérielles et clauses de licence proviennent des déclarations officielles de Meta et de la reprise d'InfoQ ; cet article ne les a pas reproduits de manière indépendante et n'a réalisé aucun test. La communauté exprime des réserves sur la crédibilité des résultats de classement, réserves déjà citées dans l'article. Des poids ouverts ne signifient pas absence de conditions commerciales : les clauses d'attribution et de seuil de chiffre d'affaires de la Muse Model License doivent être vérifiées point par point dans le texte original, et l'article précise qu'elles comportent des exceptions pour usage interne et recherche, ce qui ne doit pas être simplifié en « toutes les entreprises à hauts revenus doivent payer ». Les mentions d'une accélération de 1,03 à 3,95 fois au niveau des opérateurs et d'environ 3 % d'accélération de bout en bout sur AMD MI350 relèvent de deux échelles différentes, opérateur et bout en bout, et ne peuvent être extrapolées à un gain global de vitesse d'inférence. Les démonstrations officielles et les citations de personnes sont des déclarations de tiers et ne peuvent servir de preuve d'une capacité d'exécution sans surveillance. En outre, la prise en charge d'entrées vidéo et audio n'indique qu'une capacité de compréhension, sans capacité de génération native ; un déploiement local réduit le besoin de transfert de données, mais n'apporte pas automatiquement les contrôles de sécurité et d'accès d'un service hébergé, et un agent disposant de droits trop larges sur les fichiers et les commandes peut encore provoquer des modifications erronées ou des pertes de données.
Illustrations de l’article original