Nemotron 3.5 Super VL sur SageMaker JumpStart : 1M de tokens annoncés, endpoint limité à 15 600
Un billet AWS du 9 novembre annonce la mise à disposition de Nemotron 3.5 Super VL de NVIDIA sur SageMaker JumpStart, en deux variantes NVFP4 et BF16. 120B de paramètres totaux, 12B activés, poids sous licence OpenMDW 1.1 ; mais la configuration de service de l'endpoint managé limite le contexte à 520–15 600 tokens.
Ce qui change
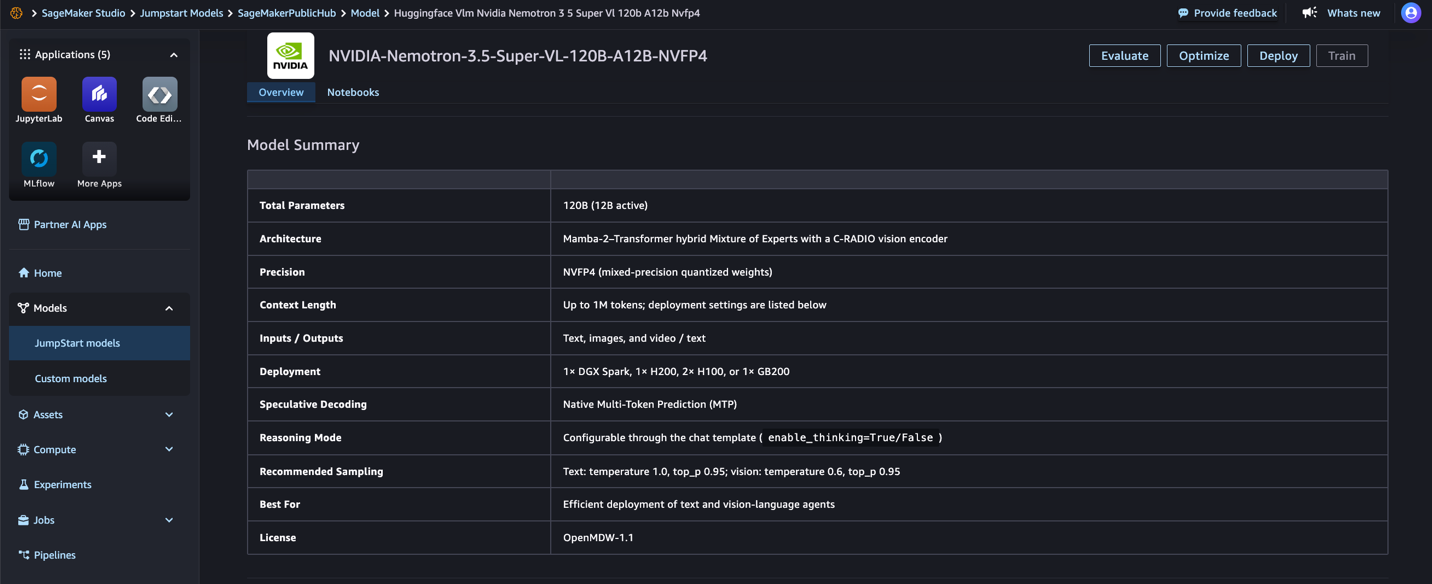
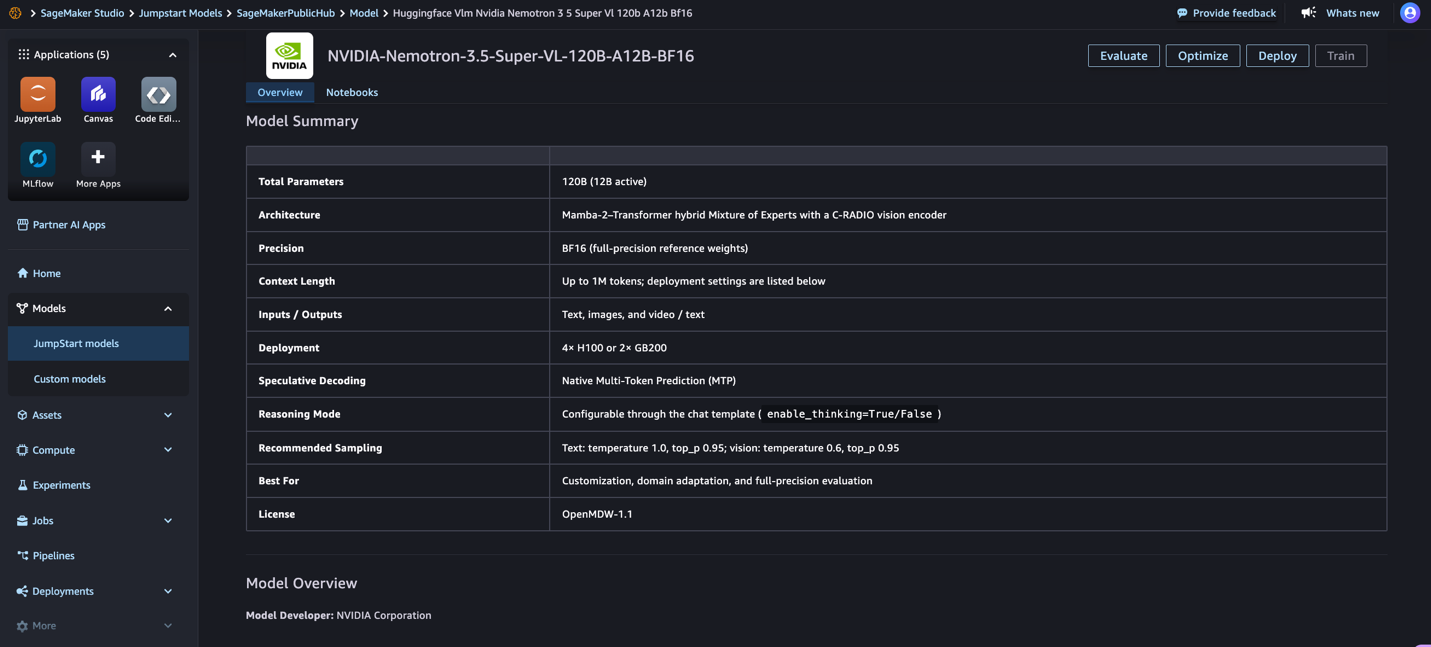
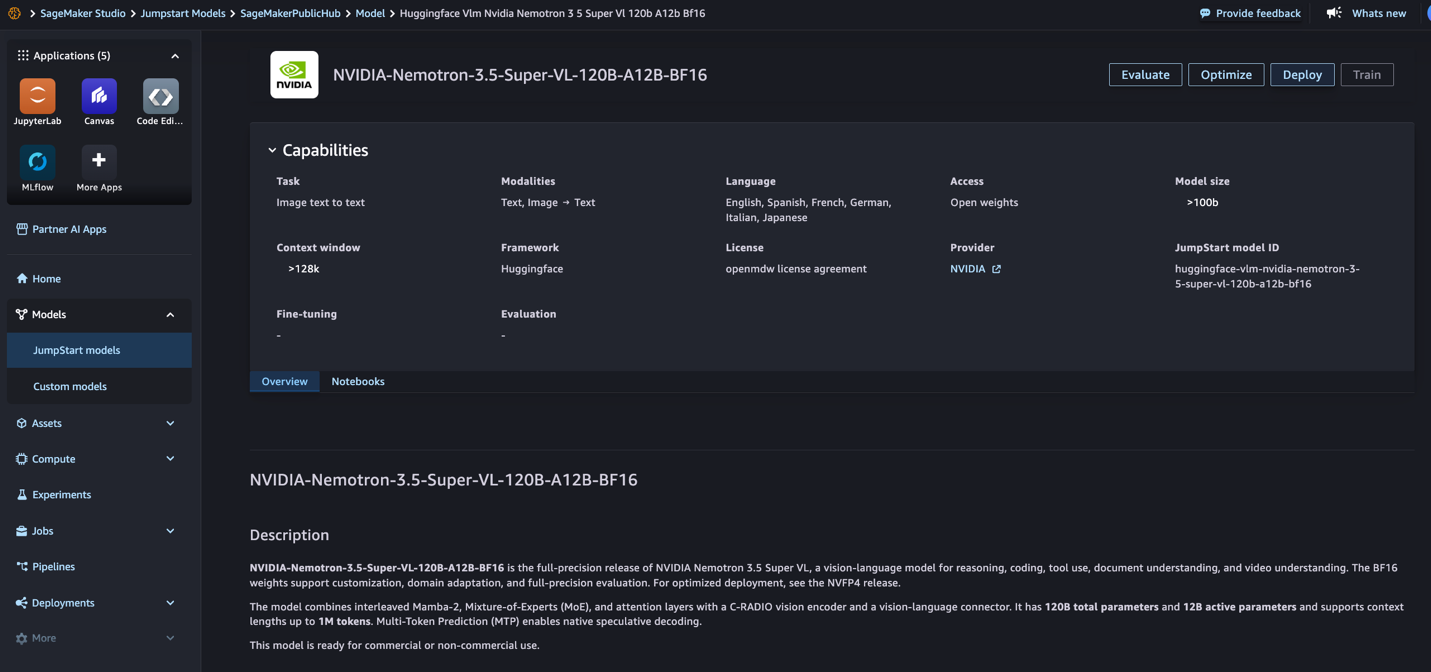
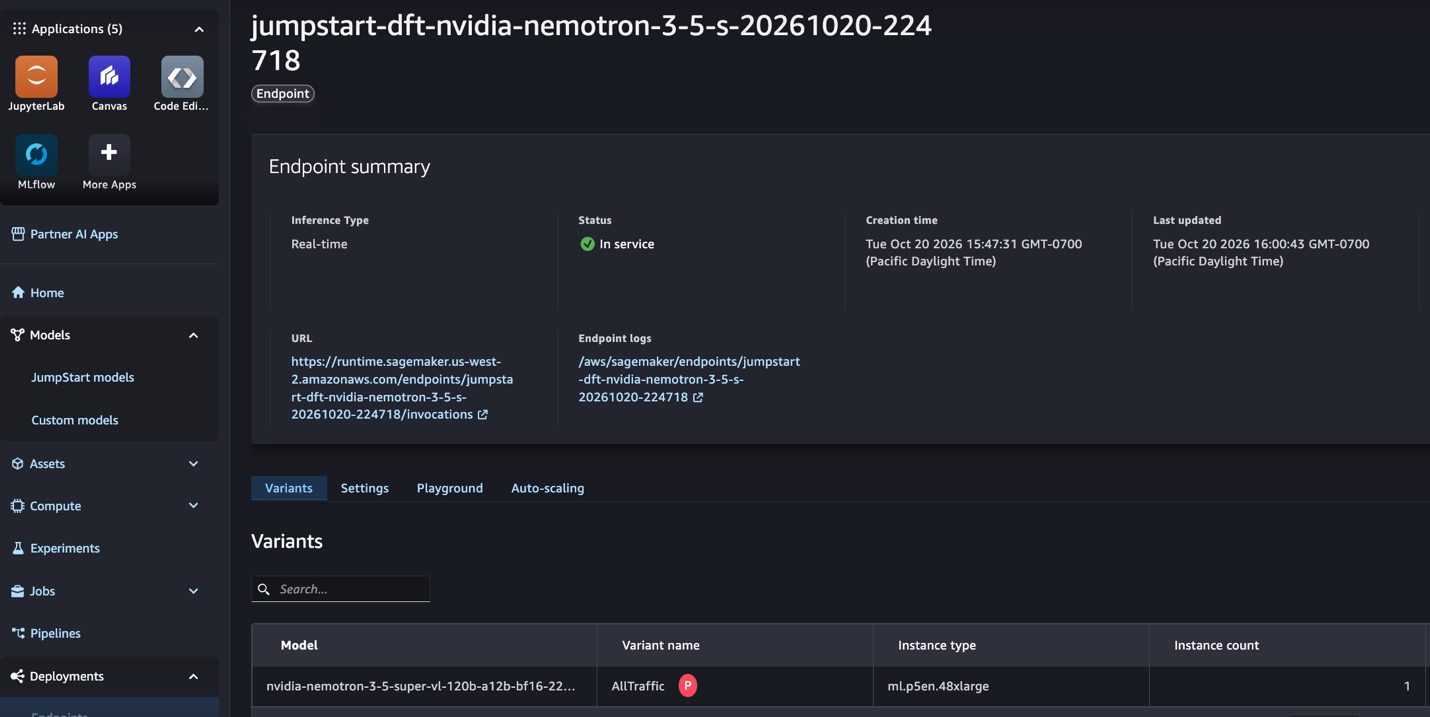
Selon un billet AWS publié le 9 novembre 2026 (auteurs Venu Kanamatareddy, Evan Kravitz, Naidile Murali), Nemotron 3.5 Super VL de NVIDIA est disponible sur Amazon SageMaker JumpStart. D'après le billet, ce modèle est un modèle vision-langage de la série Nemotron 3.5, qui accepte des entrées image, vidéo et texte et produit du texte ; son backbone linguistique compte 120B de paramètres totaux et 12B activés par token : 88 couches alternant Mamba-2 et MoE (512 experts routés, 22 activés par token), entrecoupées de 8 couches d'attention, un backbone initialisé depuis Nemotron 3 Super Base et distillé depuis Nemotron 3 Ultra Base, et un encodeur visuel C-RADIO. JumpStart propose deux variantes : NVFP4, obtenue par distillation avec quantification depuis BF16, environ 75 Go, exécutée sur des instances G7 avec RTX PRO 4500 Blackwell, avec des poids et activations en 4 bits ; BF16, poids de référence en pleine précision, environ 249 Go, exécutée sur 8 H200 d'une ml.p5en.48xlarge. Les poids sont fournis sous licence OpenMDW 1.1 et prennent en charge l'anglais, le français, l'allemand, l'italien, le japonais, l'espagnol et le chinois. Le billet indique que le modèle prend en charge jusqu'à 1 million de tokens de contexte, mais la configuration de service JumpStart ne va que de 520 à 15 600 tokens ; le checkpoint intègre une tête de prédiction multi-token, la configuration de service JumpStart n'active pas le décodage spéculatif, et l'endpoint ne charge pas d'adaptateurs LoRA.
Conséquences pour les développeurs
Le premier effet pour les développeurs concerne la forme de l'interface. D'après le billet, l'endpoint JumpStart expose une interface chat completions pilotée par vLLM, avec le raisonnement activé par défaut ; le contenu de raisonnement est placé dans le champ reasoning du message et renvoyé séparément de content, ce qui signifie que les clients existants qui ne lisent qu'un seul champ content doivent être adaptés, sous peine de perdre le texte principal ou de prendre le raisonnement pour le texte principal. Les médias doivent être envoyés en ligne sous forme de data URL base64, car l'endpoint est isolé du réseau et ne peut pas récupérer d'URL ; cela augmente sensiblement la taille des requêtes et rend caduque l'approche consistant à « donner un lien pour que le modèle le télécharge ». Le deuxième effet concerne le dimensionnement. La fiche modèle annonce un contexte allant jusqu'à 1 million de tokens, mais la configuration de service de l'endpoint managé n'en donne réellement que 520 à 15 600, et chaque requête n'accepte qu'une image et une vidéo. Une image de page en 1 536×1 024 consomme environ 1 536 tokens, et le billet précise que le modèle reçoit des images et non des PDF bruts : il faut d'abord convertir chaque page en image. On en déduit qu'un PDF de plusieurs dizaines de pages ne peut pas être envoyé en une seule fois par cette voie managée : il faut soit faire des requêtes page par page, soit assembler plusieurs pages en une seule image pour réduire le budget de contexte. Le troisième effet concerne les attentes de latence. Le billet rapporte des mesures en configuration generate (250 tokens d'entrée, 1 500 tokens de sortie, 5 flux concurrents en streaming) : sur G7, NVFP4 traite environ 63 tokens/s par requête, avec un premier token à environ 0,45 s ; mais la même g7.24xlarge, en configuration summarize avec 10 000 tokens d'entrée, porte le premier token à 12,62 s. Les requêtes image et vidéo se situent généralement du côté des longues invites ; avant d'envisager ce modèle pour un agent GUI interactif, il vaut la peine de mesurer cet ordre de grandeur du premier token. Côté qualité, le billet cite cinq benchmarks multimodaux de la fiche modèle NVIDIA (raisonnement activé) : MMLongBench-Doc 62,82 contre 62,82, OCRBench v2 anglais 68,12 contre 68,34, CharXiv reasoning 80,82 contre 79,88, Video-MME v2 32,85 contre 32,54, OSWorld-Verified 51,14 contre 52,30, la première valeur étant BF16 et la seconde NVFP4. Le billet affirme que les paramètres d'évaluation sont identiques et que seul le checkpoint diffère. Ce sont des chiffres auto-déclarés par le constructeur, sans reproduction tierce connue.
Intégration et évaluation
Les trois recommandations ci-dessous sont conditionnelles et fondées sur les faits rapportés ; ce ne sont pas des conclusions vérifiées. Premièrement, choisir d'abord la variante. Le changement rapporté est que JumpStart propose à la fois les checkpoints NVFP4 et BF16, NVFP4 par défaut et démarrant sur ml.g7.24xlarge, BF16 uniquement sur ml.p5en.48xlarge. Le choix à faire : pour un service d'inférence pur, commencer par NVFP4 ; ne télécharger les poids de référence BF16 pour un déploiement autonome que si vous faites du SFT, de l'apprentissage par renforcement, de la distillation, de l'adaptation métier ou une quantification personnalisée. La condition décisive est le besoin de fine-tuning : le billet indique explicitement que l'endpoint ne fournit que les poids de base et ne charge pas d'adaptateurs LoRA ; si votre solution repose sur un basculement à chaud de LoRA, la voie managée est inapplicable. Le critère testable : exécuter les deux checkpoints sur le même lot de captures de documents et de clips vidéo, comparer l'écart de précision sur la tâche et le taux de conformité de la sortie JSON, et fixer l'écart acceptable sous le niveau d'erreur correspondant à votre taux de relecture humaine actuel. Deuxièmement, choisir la configuration de service avant de parler de contexte. Le changement rapporté est que inference_config_name détermine la longueur du modèle : generate 2 275, interact 520, summarize 13 650, modify 15 600 tokens ; les exemples image, vidéo et raisonnement du billet utilisent tous modify. En pratique, utiliser modify pour les requêtes avec image, vidéo ou raisonnement multi-étapes, generate pour l'extraction de textes courts, et estimer le nombre de pages par requête sur la base d'environ 1 536 tokens par page. La condition : un document multi-pages doit être découpé en plusieurs requêtes ou assemblé en une seule image. Le critère testable : avant mise en production, mesurer le taux de rejet pour dépassement de longueur et le temps p95 du premier token, en prenant les 12,62 s à 10 000 tokens d'entrée comme référence basse du budget de latence. Troisièmement, choisir d'abord l'activation du raisonnement. Le changement rapporté est que le raisonnement est activé par défaut, que le contenu de raisonnement est renvoyé séparément, et que les requêtes vidéo avec raisonnement recommandent un max_tokens d'au moins 8 192. En pratique, désactiver avec enable_thinking=False pour les tâches nécessitant une réponse courte et directe comme l'extraction de champs de ticket ou la description d'image, et conserver le raisonnement pour l'analyse multi-étapes et la localisation GUI. La condition décisive est de savoir si la tâche a réellement besoin d'étapes intermédiaires. Le critère testable : sur le même lot d'échantillons, comparer avec et sans raisonnement la précision d'extraction de champs, le nombre de tokens de sortie et la latence de bout en bout, pour voir si les tokens économisés s'accompagnent d'une perte de précision acceptable. Avant le déploiement, vérifier aussi le quota ml.g7 (nul au départ pour un nouveau compte) et un SDK Python SageMaker au moins en version 3.25, et passer explicitement le type d'instance, sinon le SDK retombe sur ml.m5.large et la construction échoue.
Limites et points à confirmer
La version Nemotron 3.5 Super VL n'est actuellement pas dans le catalogue de modèles de KimiSeek ; la disponibilité rapportée concerne AWS SageMaker JumpStart, c'est-à-dire un service managé côté constructeur, et non un modèle déjà référencé sur ce site. Les autres inconnues doivent aussi être conservées : les cinq benchmarks cités proviennent de la fiche modèle NVIDIA et relèvent d'une déclaration du constructeur ; le billet précise lui-même que les chiffres de performance NVFP4 et BF16 ont été obtenus sur des systèmes GPU et des configurations différents, et non dans le cadre d'une comparaison de précision isolée ; on ne peut donc pas déduire directement une perte de quantification en comparant 63 tokens/s et 140,85 tokens/s. Le contexte de 1 million de tokens annoncé par la fiche modèle n'est pas exposé sur l'endpoint managé, dont la limite réelle dépend de la configuration de service ; l'échantillonnage des frames vidéo est fixé au démarrage de l'endpoint, et l'endpoint refuse media_io_kwargs par requête : pour contrôler l'échantillonnage par requête, il faut un déploiement autonome. Les poids sont fournis sous licence OpenMDW 1.1 ; des poids ouverts ne signifient pas une licence open source, et les clauses d'utilisation commerciale, de redistribution et de modèles dérivés doivent être lues dans le texte de la licence. La source ne donne pas de prix ; les coûts dépendent de l'instance choisie, à vérifier sur la page de tarification AWS SageMaker. Le chinois figure dans la liste des langues prises en charge, mais la source ne fournit pas de données de benchmark pour des scénarios en chinois.
Illustrations de l’article original