NVIDIA lance Nemotron 3.5 Bolt E4B, un modèle d'agent local visant 4 Go de VRAM, en retrait sur Tau2-Bench face à Qwen3.5-4B
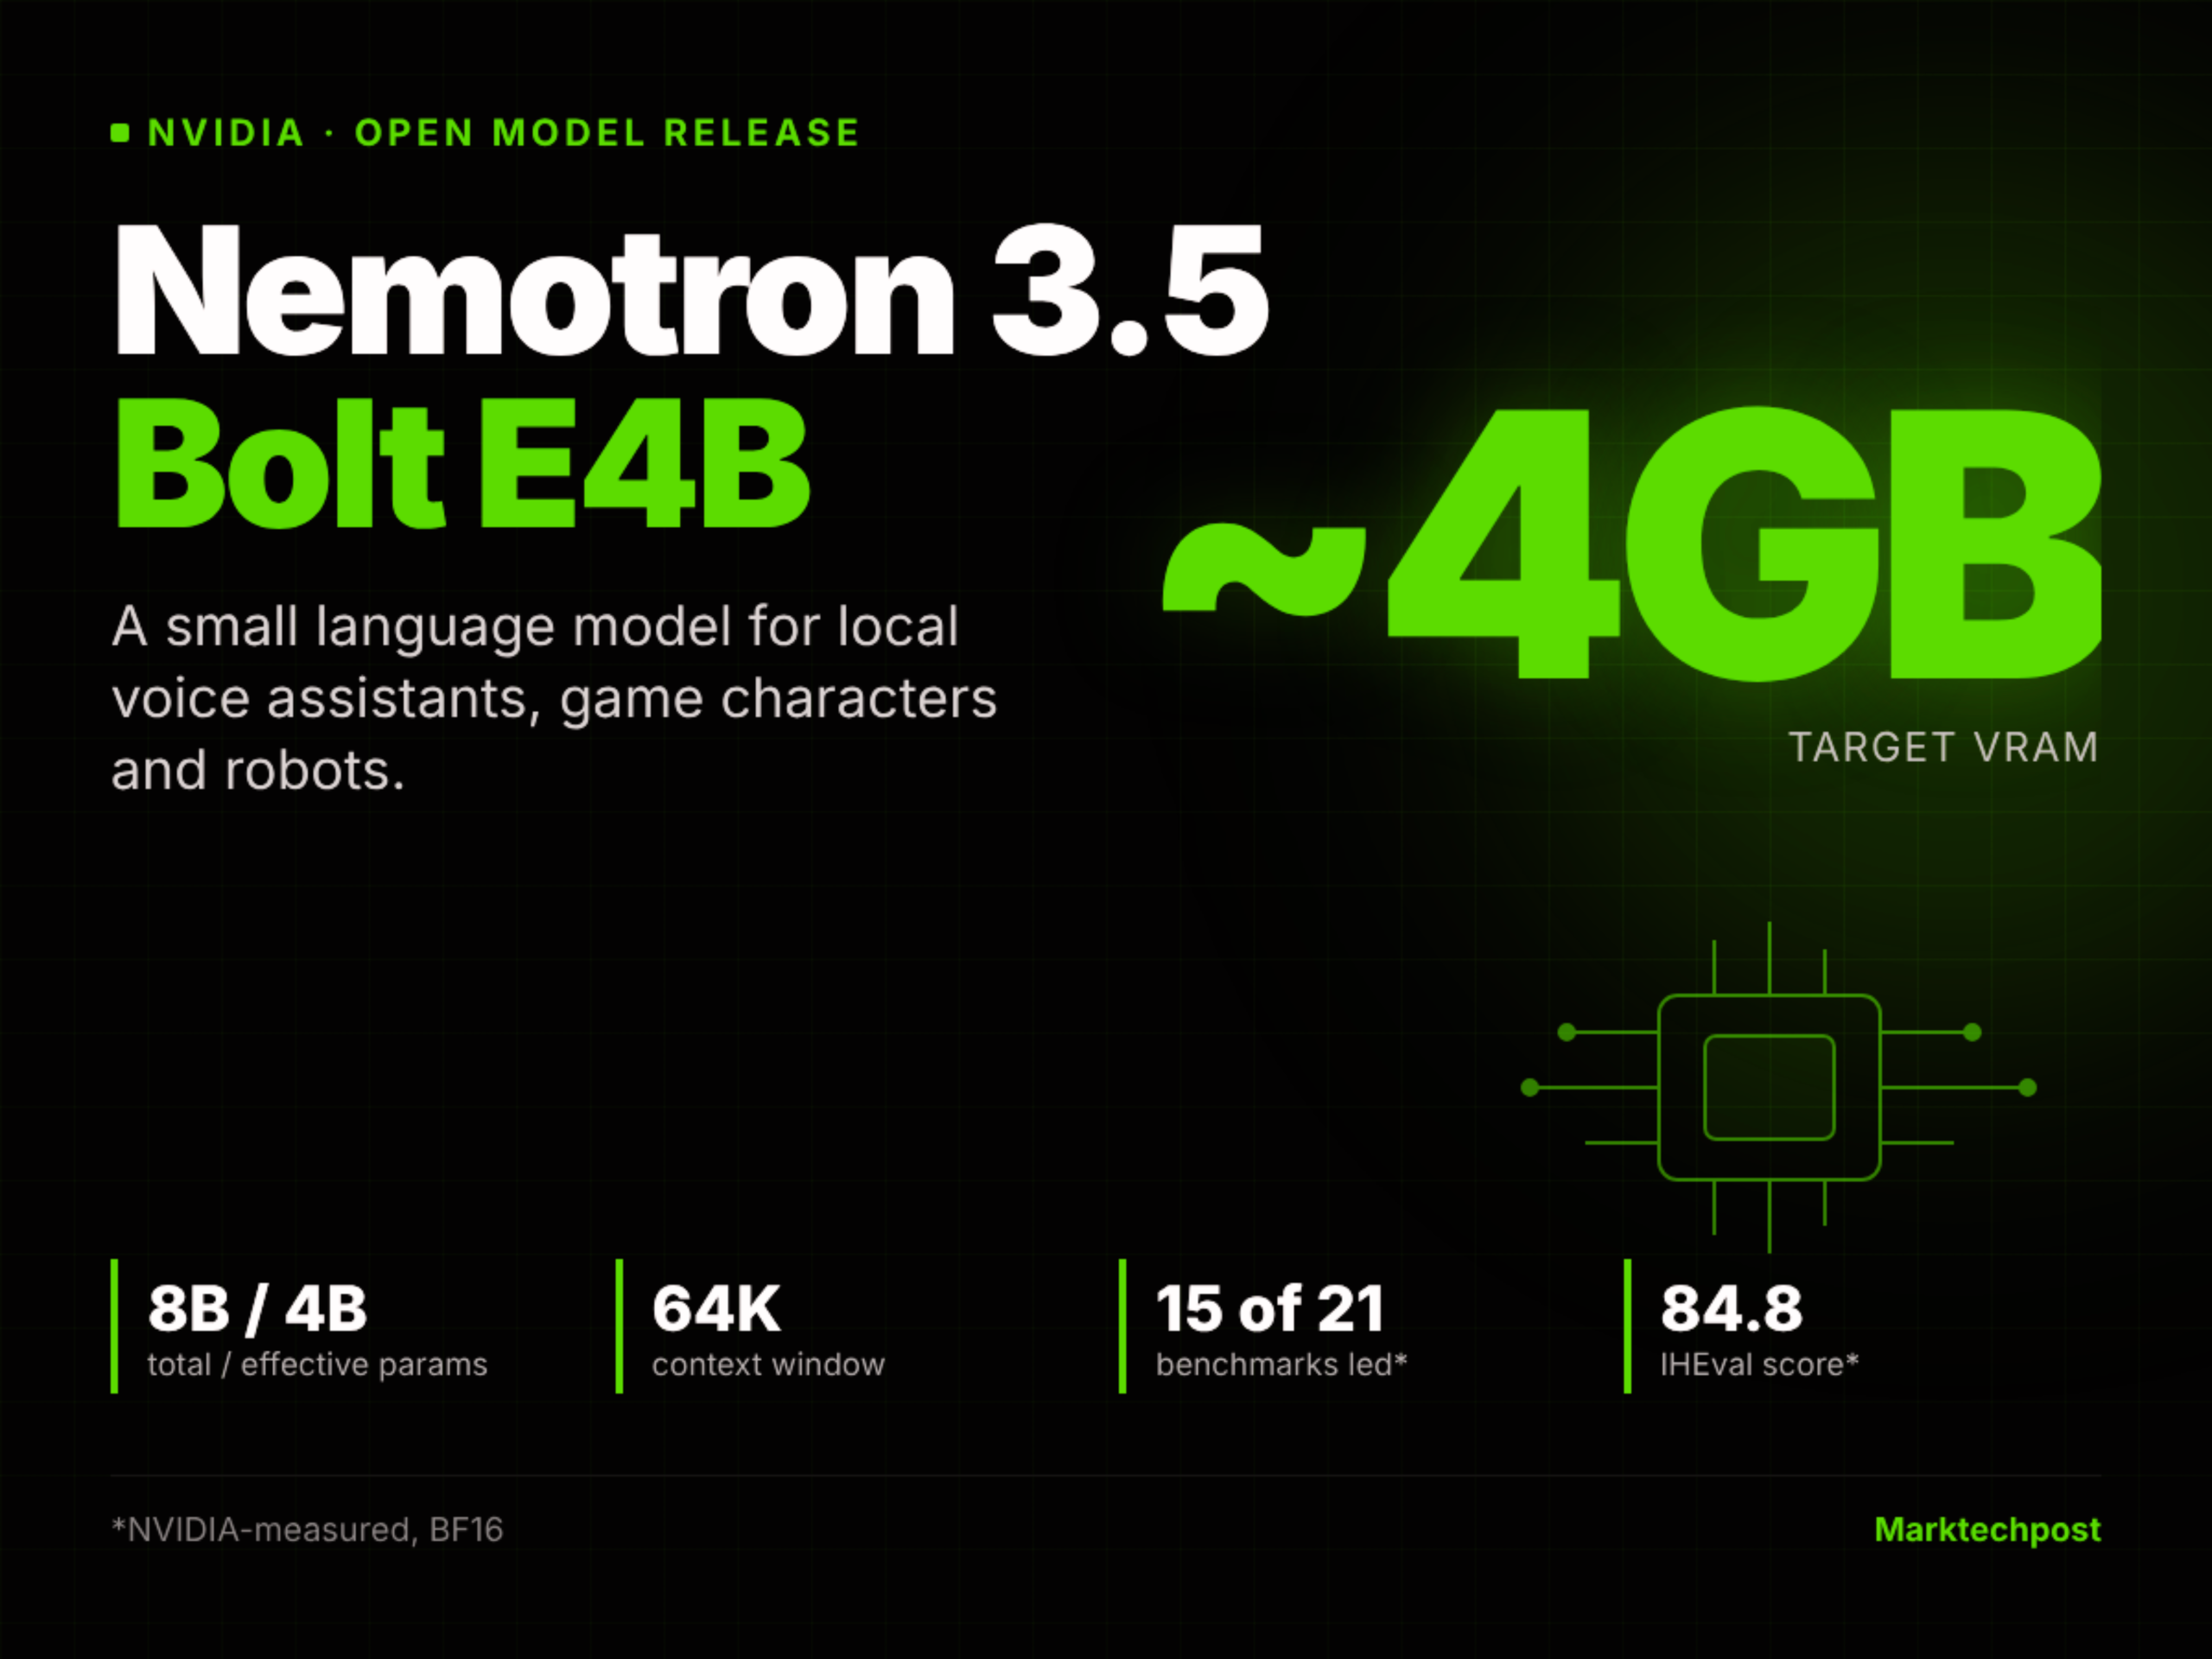
Selon MarkTechPost du 23 octobre 2026, NVIDIA publie Nemotron 3.5 Bolt E4B, un modèle à poids ouverts dérivé de Gemma 4 E4B par post-entraînement en apprentissage par renforcement uniquement : 8 milliards de paramètres au total, 4 milliards effectifs, contexte de 64K, destiné aux assistants vocaux locaux, aux PNJ de jeux et à la robotique. Sur 21 benchmarks auto-évalués, 15 donnent Bolt en tête, mais Tau2-Bench le place à 55,1 contre 75,1 pour Qwen3.5-4B.
Ce qui change
Un article de MarkTechPost daté du 23 octobre 2026 annonce la publication par NVIDIA de Nemotron 3.5 Bolt E4B, construit à partir de Gemma 4 E4B de Google, en sautant totalement le fine-tuning supervisé pour ne recourir qu'au RLVR et au RLHF via NeMo-RL et NeMo-Gym ; chaque échantillon d'entraînement fait tourner simultanément un mode raisonnement et un mode non-raisonnement, le ratio non-raisonnement/raisonnement restant de 2:1 dans les lots, une pénalité de longueur dans l'environnement GenRM freinant l'allongement des réponses, et le jeu de données comme la recette sont publics. Le modèle compte 8 milliards de paramètres au total, 4 milliards effectifs et un contexte de 64K ; il gère les appels d'outils multi-tours et les instructions d'appels asynchrones, un indicateur conversational_mode génère des réponses courtes adaptées à la voix, et la capacité de raisonnement comme le budget de réflexion à l'exécution sont configurables. Selon l'article, il s'agit de la troisième génération de petit modèle destiné aux personnages de jeu NVIDIA ACE, et une démonstration montre un robot Reachy Mini tournant sur un Jetson Orin Nano 8 Go, où Cosmos 3 Edge assure la vision tandis que Bolt produit la réponse vocale et les appels d'outils. Côté déploiement, NVIDIA quantifie le checkpoint BF16 en Q4_K_M après calibration par matrice d'importance, sur environ un million de tokens de rollouts RL, et fournit un drafter DFlash pour le décodage spéculatif : l'article rapporte 272,6 tokens/s pour Bolt sur RTX 5070, contre 225,9 tokens/s pour Gemma 4 E4B avec son drafter MTP. Les mesures matérielles (Q4_K_M, llama.cpp, batch size 1, 3K en entrée et 50 tokens en sortie) indiquent 3,5 Go de VRAM sur RTX 5070, 548 ms avant le premier token et 133,4 tokens/s ; 4,2 Go, 3687 ms et 24,0 tokens/s sur Jetson AGX Orin 32 Go ; 4,2 Go, 5785 ms et 15,5 tokens/s sur Jetson Orin Nano 8 Go. L'article souligne que « 4 Go » désigne une plage de VRAM visée et non la taille du fichier : le GGUF Q4_K_M sur Hugging Face pèse 6,18 Go. Les poids sont publiés sous licence OpenMDW-1.1, les données et la recette sont publiques, et le modèle est disponible sur Hugging Face, Ollama, LM Studio, Unsloth et Jetson AI Lab, ainsi que sous forme de NVIDIA NIM et d'In-Game Inferencing SDK, avec une API gratuite sur la plateforme hébergée officielle de NVIDIA. Côté benchmarks, tous les scores cités sont en BF16 et mesurés par NVIDIA dans son propre framework NeMo-Gym : Bolt est premier sur 15 des 21 épreuves, avec IHEval à 84,8 (Gemma 4 E4B 67,0 ; Qwen3.5-4B 60,6) ; il obtient 55,1 sur Tau2-Bench, derrière les 75,1 de Qwen3.5-4B, 87,0 sur RULER 64K contre 95,1 pour Qwen3.5-4B, et Qwen3.5-4B devance également sur LongBench v2 (50,5 contre 59,9) et BFCL-v3 (68,5 contre 70,9), tandis que Gemma 4 E4B garde un léger avantage sur EQ-Bench v3 (41,1 contre 39,4). L'article relaie aussi les affirmations de NVIDIA : un score moyen supérieur d'environ 40 % à Nemotron 3 Nano 4B, et jusqu'à 80 % de tokens de sortie en moins dans les comparaisons avec raisonnement activé.
Conséquences pour les développeurs
L'effet direct pour les développeurs porte surtout sur deux points : le budget de VRAM et la répartition des tâches. Les chiffres de VRAM cités correspondent à l'inférence du modèle seul, sans reconnaissance vocale, synthèse vocale ni modèle de vision ; si l'on se réfère à la démonstration sur Jetson Orin Nano 8 Go, le modèle occupe déjà 4,2 Go, et la marge restante détermine la taille du modèle de perception que l'on peut ajouter, la résolution d'image possible et la nécessité éventuelle de passer à un appareil de 16 Go ou plus. L'écart sur le temps du premier token compte tout autant : 548 ms sur RTX 5070 et 5785 ms sur Orin Nano 8 Go ne donnent pas la même expérience d'interaction, la seconde se rapprochant davantage d'échanges tour par tour que d'une conversation avec interruptions naturelles. La répartition des capacités indique qu'il faut plutôt le traiter comme un composant spécialisé que comme un petit modèle généraliste. Sur les 21 benchmarks couvrant 5 domaines, NVIDIA ne revendique la première place que sur 15, et les défaites se concentrent sur le contexte long et la chaîne d'outils agentique : Tau2-Bench, RULER 64K, LongBench v2 et BFCL-v3 sont tous perdus face à Qwen3.5-4B. À l'inverse, un score de suivi d'instructions comme IHEval 84,8 est un point fort, et conversational_mode confirme une intention de conception orientée vers des réponses courtes, rapides et directement diffusables. Au global, c'est un candidat pour « dialogue plus appels d'outils légers », pas le choix par défaut pour une planification multi-tours complexe ou une recherche sur contexte très long. Il faut intégrer les différences de méthode dans le jugement. Tous les scores ci-dessus sont mesurés par le constructeur dans son propre framework de test et peuvent diverger de reproductions tierces ; l'article mentionne par ailleurs un 56,03 % de Scale Labs sur MultiChallenge, supérieur aux 53,1 % déclarés par NVIDIA. La coexistence de deux séries de chiffres dans un même article montre qu'aucun score isolé ne doit servir de conclusion lors d'un choix, surtout si la distribution de vos cas d'usage diffère de celle des benchmarks.
Intégration et évaluation
Les recommandations et analyses conditionnelles ci-dessous découlent de l'article et ne constituent pas des conclusions vérifiées. Décision 1 : choisir la quantification et la forme de déploiement selon la marge de VRAM de l'appareil cible. Si l'appareil est un Jetson de la classe 8 Go ou un GPU de 12 Go et que le modèle doit tourner en même temps que des modèles vocaux et de vision, la piste Q4_K_M avec llama.cpp est à valider en priorité : les 4,2 Go d'occupation et les 6,18 Go de fichier rapportés montrent que le fichier de poids ne tient pas dans le budget « 4 Go », c'est la forme quantifiée à l'exécution qui est utilisable. Le critère de test est concret : mesurez la latence du premier token et les tokens/s avec votre propre longueur d'entrée (l'article utilise 3K en entrée et 50 tokens en sortie), et vérifiez qu'il reste de la marge après ajout des modèles de perception ; si le premier token dépasse la limite acceptable pour l'interaction prévue, passez d'abord à une quantification plus petite ou plus agressive plutôt que de continuer à ajuster les prompts. Décision 2 : décider si Bolt a sa place selon que la charge de travail repose ou non sur les appels d'outils. Pour un produit de type assistant vocal, avec de courts dialogues et quelques appels d'outils, son conversational_mode et son contexte de 64K méritent un test ; si le cœur du système est une longue trajectoire d'outils multi-tours avec état, l'écart rapporté de 55,1 contre 75,1 sur Tau2-Bench suggère d'établir d'abord une référence avec Qwen3.5-4B. Le critère de test consiste à transformer vos propres trajectoires d'appels d'outils multi-tours en un jeu d'évaluation fixe et à comparer, avec les mêmes définitions de fonctions, le taux de réussite des tâches et le nombre moyen de tours d'appel, plutôt que de juger seulement la fluidité d'une réponse à un tour. Décision 3 : traiter le budget de réflexion à l'exécution comme un paramètre à étalonner, non comme un interrupteur. L'article indique que le modèle accepte un raisonnement configurable et un budget de réflexion à l'exécution, et que les comparaisons avec raisonnement activé réduisent les tokens de sortie jusqu'à 80 % (affirmation du constructeur). Autrement dit, les mêmes poids produisent deux courbes distinctes de latence et de qualité selon que le raisonnement est activé ou non. La méthode : fixer un budget de latence pour la chaîne vocale, choisir l'une des deux options dans ce budget, et prendre le nombre de tokens de sortie et le temps avant le premier paquet comme indicateurs mesurables pour vérifier si l'économie de tokens se vérifie sur la distribution de vos tâches. Décision 4 : vérifier la licence séparément. L'article indique que les poids sont publiés sous OpenMDW-1.1, alors que le modèle de base Gemma 4 E4B est sous Apache 2.0 ; les clauses diffèrent. Avant d'intégrer les poids à un produit, lisez directement le texte de la licence pour confirmer les conditions de distribution, d'attribution et d'usage commercial, plutôt que de déduire les droits d'une étiquette comme « poids ouverts ».
Limites et points à confirmer
Le Nemotron 3.5 Bolt E4B décrit ici n'est pas disponible sur KimiSeek : aucune entrée correspondante ne figure dans le catalogue du site. L'API gratuite mentionnée dans l'article renvoie à la disponibilité du modèle sur la plateforme hébergée officielle de NVIDIA et ne concerne pas ce site ; la disponibilité réelle et les conditions doivent être vérifiées dans la documentation du constructeur. Les limites connues sont les suivantes : tous les scores de benchmarks cités sont en BF16 et mesurés par NVIDIA dans son framework NeMo-Gym, sans reproduction indépendante ; le score moyen supérieur d'environ 40 % à Nemotron 3 Nano 4B et la réduction pouvant atteindre 80 % des tokens de sortie avec raisonnement activé sont des déclarations du constructeur. La comparaison de vitesse comporte aussi des différences de méthode : 272,6 contre 225,9 tokens/s correspond à Bolt avec drafter DFlash face à Gemma 4 E4B avec drafter MTP sur RTX 5070, ce qui n'est pas la même mesure que les 133,4 tokens/s du tableau matériel ; les deux ne sont pas interchangeables. Sur MultiChallenge, NVIDIA déclare 53,1 %, tandis qu'un post sur X relayé par l'article attribue 56,03 % à Scale Labs ; les deux chiffres doivent être attribués séparément. Côté licence, Bolt est publié sous OpenMDW-1.1 et le modèle de base Gemma 4 E4B est sous Apache 2.0 : des poids ouverts ne signifient pas des clauses commerciales équivalentes. Les données matérielles ne couvrent que quatre configurations RTX et Jetson ; aucune donnée n'existe pour d'autres plateformes. Concernant les modalités d'entrée, selon le tableau comparatif de l'article, la fiche du modèle Bolt indique du texte en entrée, tandis que la forme NIM accepte aussi images et audio ; les modalités réellement disponibles et leurs limites restent à confirmer dans la documentation officielle, l'article ne fournissant pas de résultats d'évaluation pour ces modalités.