OlmoEarth v1.3 : embeddings satellitaires 128 dimensions, embeddings précalculés mondiaux et explorateur sans authentification
Selon un billet de blog d'Allen AI publié le 22 octobre 2026, OlmoEarth v1.3 est un modèle d'embeddings satellitaires qui lit des séries temporelles annuelles de Sentinel-1, Sentinel-2 et Landsat et génère un vecteur de 128 dimensions pour chaque pixel de 10 mètres, les 64 premières dimensions pouvant être utilisées seules. La source affirme que ses embeddings 128 dimensions obtiennent le meilleur score sur 20 des 27 évaluations, et publie les embeddings précalculés mondiaux, les poids, les données de préentraînement et le code sous OlmoEarth Artifact License.
Ce qui change
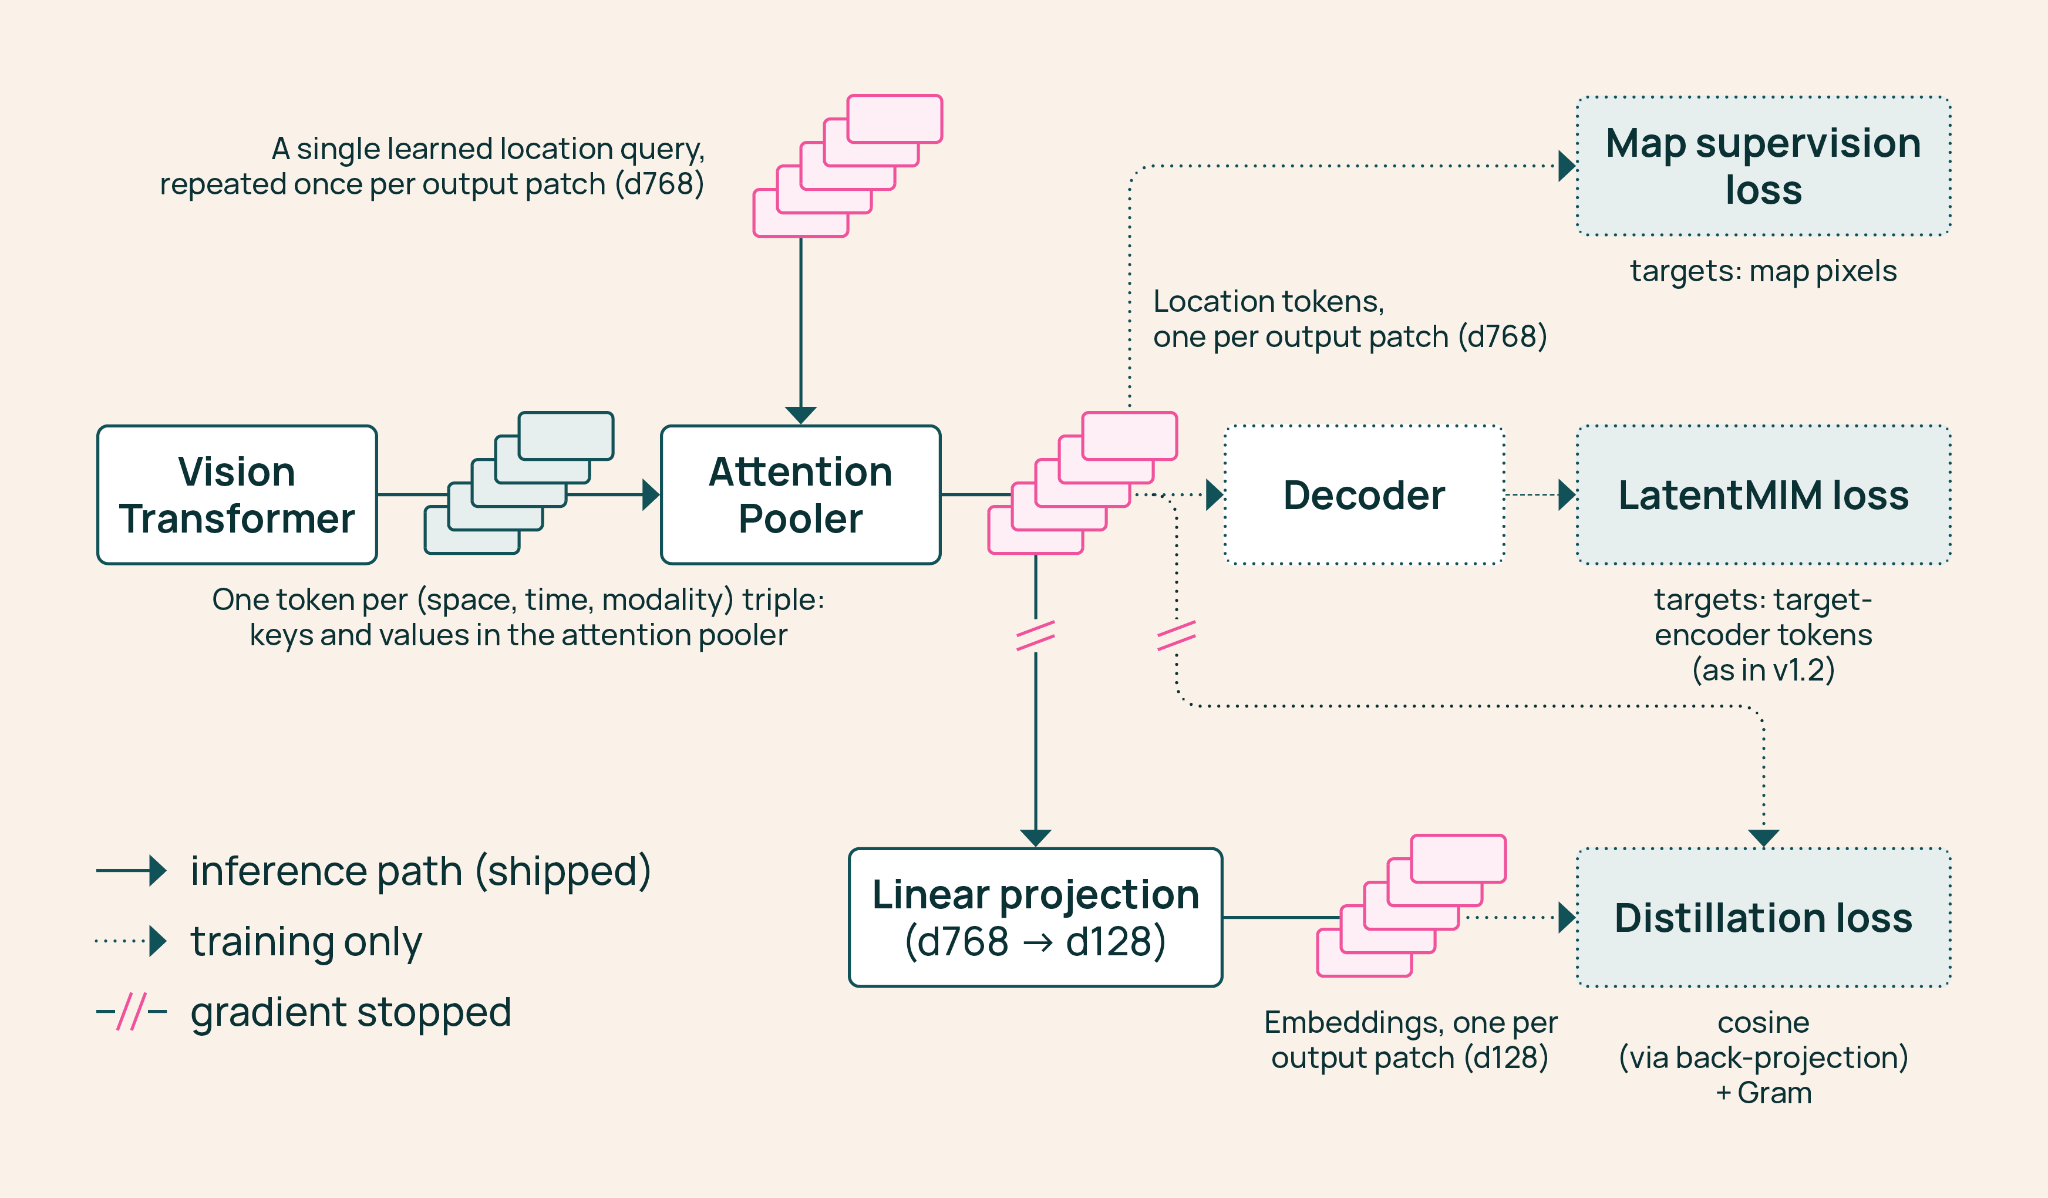
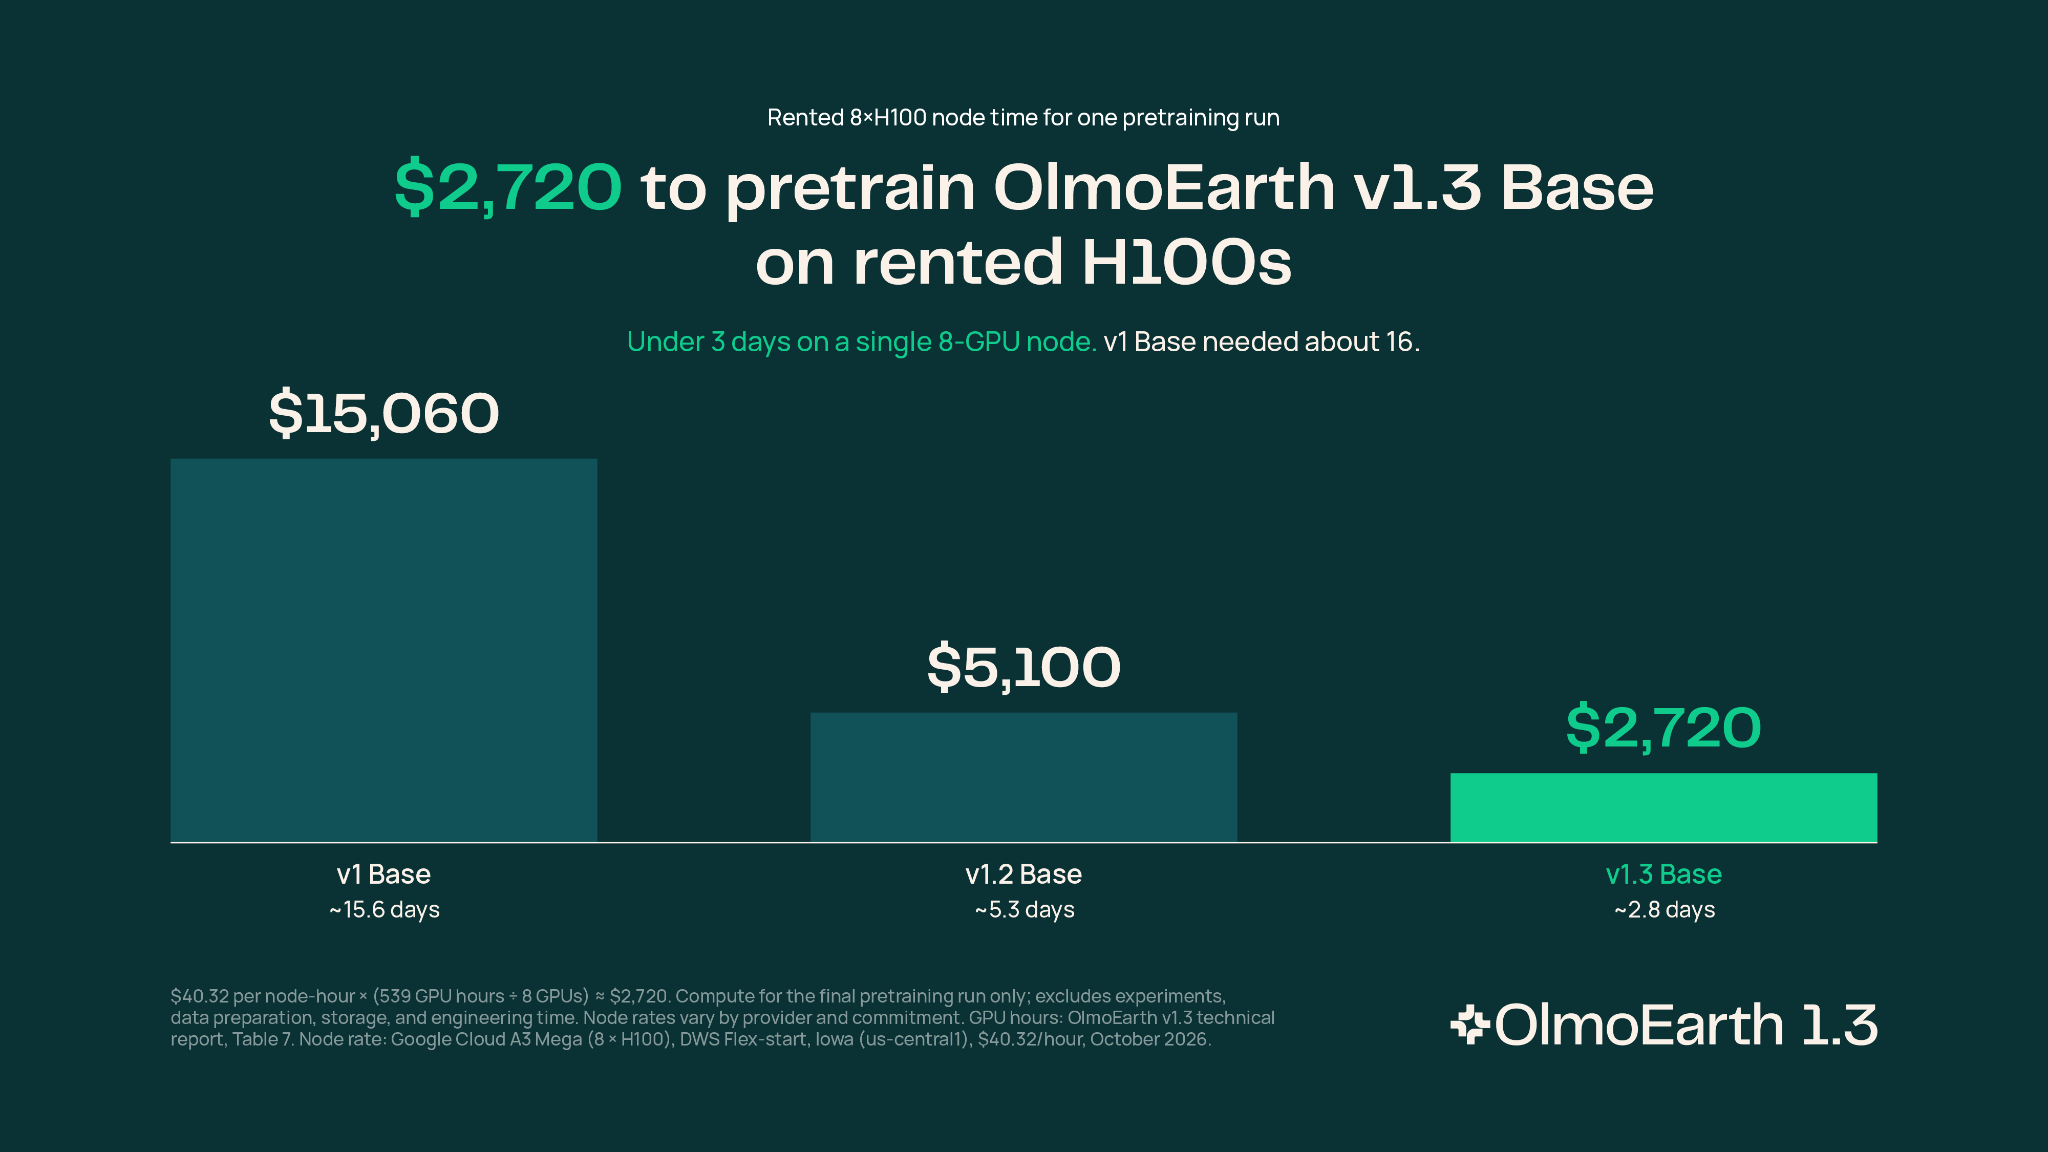
Allen AI a annoncé la sortie d'OlmoEarth v1.3 dans un billet de blog daté du 22 octobre 2026. Selon ce billet, il s'agit d'un modèle d'embeddings satellitaires : il lit une année de séries temporelles radar (Sentinel-1) et multispectrales (Sentinel-2 et Landsat) et génère pour chaque pixel de 10 mètres sur Terre un vecteur de 128 dimensions, dont les 64 premières dimensions peuvent aussi être utilisées seules comme embedding plus compact. Concernant l'architecture, un Transformer visuel lit les données satellitaires, un Attention Pooler les agrège en un vecteur unique par parcelle, et une couche linéaire compresse le tout en 128 nombres. La source affirme que, sur 27 évaluations couvrant six continents et diverses tâches, les embeddings 128 dimensions obtiennent le meilleur score sur 20, et la version 64 dimensions sur 18 ; les comparaisons portent sur AlphaEarth Foundations (AEF) et Tessera v2, et un benchmark de types de cultures pour l'agriculture tropicale, PLANTEUR, est également introduit. Le blog indique que les poids du modèle, les données de préentraînement et le code de préentraînement sont tous ouverts, sous OlmoEarth Artifact License, comme pour v1 et v1.2. Sont également fournis avec la sortie les embeddings annuels précalculés mondiaux (résolution 10 mètres, 64 et 128 dimensions), les données hébergées sur Source Cooperative, et l'outil navigateur sans authentification OlmoEarth Embeddings Explorer. Le blog estime que la dernière exécution de préentraînement d'OlmoEarth v1.3 Base nécessite environ 2 720 dollars de temps de location de H100 ; l'archive d'embeddings représente environ 150 To par an, avec une couverture mondiale pour 2025, 2024 et 2023, et une couverture partielle de certains pays pour 2017 à 2022.
Conséquences pour les développeurs
Du point de vue du développeur, cette sortie déplace le centre de gravité du flux de travail « créer une carte à partir de données satellitaires » du fine-tuning vers la réutilisation de caractéristiques. Le blog précise que la principale façon d'utiliser OlmoEarth jusqu'ici était de fine-tuner un modèle par tâche dans OlmoEarth Studio, ce qui exigeait un accès GPU et la capacité de télécharger et stocker des images ; l'approche par embeddings consiste à compresser les données satellitaires en caractéristiques directement réutilisables, ce qui transforme l'entraînement d'un classifieur en un problème de modélisation local léger. Pour les équipes aux ressources limitées, cela signifie qu'elles peuvent d'abord mener une première analyse avec quelques points annotés dans l'Embeddings Explorer, sans GPU, avant de décider si un investissement en calcul pour le fine-tuning est justifié. Un autre effet concerne l'accessibilité des données : la source a publié des embeddings précalculés couvrant toute la planète et affirme qu'il existe une table de traçabilité pour chaque cellule de 20 km et chaque année, listant les scènes Sentinel-1, Sentinel-2 et Landsat lues par le modèle ainsi que des liens vers les catalogues publics, ce qui permet de remonter d'un pixel à sa source d'image. Cela abaisse la barrière pour construire soi-même un pipeline de caractéristiques de télédétection, mais déplace la dépendance vers la couverture, le rythme de mise à jour et les conditions de licence de l'archive officielle. Sur le coût d'entraînement, le blog affirme que le temps de calcul de v1.3 représente 53 % de celui de v1.2 et 18 % de celui de v1, avec des émissions de carbone de 50 % et 22 %, tout en affirmant des performances comparables à v1.2 sur des étiquettes de recherche et de partenaires. Ces chiffres sont des déclarations du fournisseur et restent à vérifier par des tiers.
Intégration et évaluation
Avant de décider d'adopter le modèle, il est recommandé aux développeurs de faire une distinction selon les critères suivants. La première décision concerne la possibilité de fine-tuner localement : le blog affirme que v1.3 est aussi un modèle de fine-tuning puissant, avec des performances comparables à v1.2 sur des étiquettes de recherche et de partenaires (déclaration du fournisseur). Si votre tâche dispose déjà de données annotées historiques et nécessite une précision spécifique, il est conseillé de fixer d'abord un même jeu d'étiquettes de validation et de comparer les embeddings v1.3 avec un petit classifieur à votre base de référence v1.2 existante ; ce n'est que si l'écart sur le jeu de validation est net et stable qu'un processus complet de fine-tuning vaut l'investissement. Les critères d'évaluation mesurables sont la précision de classification ou l'intersection sur union moyenne sur le même jeu de validation, ainsi que le nombre d'annotations nécessaires pour atteindre la précision cible. La deuxième décision concerne la nécessité de générer soi-même les embeddings : des embeddings mondiaux précalculés en 64 et 128 dimensions sont déjà fournis, mais le blog indique une couverture mondiale pour 2025, 2024 et 2023, et une couverture partielle de certains pays seulement pour 2017 à 2022. Si votre fenêtre d'étude sort de cette couverture, ou si vous avez besoin de dates, modalités et résolutions personnalisées, il faudra générer les embeddings sur votre propre calcul via OlmoEarth Studio ou le tutoriel mentionné dans le blog ; dans ce cas, il convient de lancer d'abord un essai de bout en bout sur une petite zone, avec comme critère d'acceptation la capacité à reproduire les dimensions de vecteur et les enregistrements de traçabilité des embeddings officiels. La troisième décision porte sur la licence et la distribution : le blog indique que tous les poids, données et code sont publiés sous OlmoEarth Artifact License, comme pour v1 et v1.2. Ce nom n'est pas une licence open source de type OSI courante ; il est conseillé de lire attentivement les clauses de la licence avant de redistribuer les poids ou d'utiliser les produits d'embeddings dans un produit commercial, afin de confirmer le périmètre de redistribution et d'usage commercial, et de ne pas déduire l'étendue des droits du seul fait que les poids sont ouverts. Ces recommandations sont conditionnelles et fondées sur les informations de la source, et non des conclusions vérifiées.
Limites et points à confirmer
Il faut d'abord préciser qu'OlmoEarth v1.3 n'apparaît pas actuellement dans le catalogue de modèles en direct de KimiSeek ; toutes les descriptions de capacités du modèle, de données et d'outils dans cette entrée proviennent du blog d'Allen AI et sont sans rapport avec la disponibilité sur la plateforme KimiSeek. Les conclusions d'évaluation citées dans la source (meilleur score sur 20 des 27 évaluations, comparaison avec AEF et Tessera v2) et les chiffres d'efficacité (temps de calcul à 53 % de v1.2, 18 % de v1) sont des déclarations du fournisseur et n'ont pas été reproduites indépendamment dans cette note. Le blog affirme que les poids, les données de préentraînement et le code sont « tous ouverts », mais la licence est OlmoEarth Artifact License, qui n'est pas une licence open source OSI standard ; le périmètre exact des droits doit être vérifié dans le texte de la licence. Les embeddings précalculés pour 2017 à 2022 ne couvrent que certains pays ; si votre zone d'étude n'est pas couverte, il faut générer les embeddings soi-même, et la voie d'auto-génération mentionnée dans le blog dépend de son tutoriel et de calcul local. Le coût d'environ 2 720 dollars de location de H100 n'est qu'une estimation de la dernière exécution de préentraînement, hors préparation des données, stockage et débogage, et les prix de location de matériel évoluent avec le temps ; il ne faut pas s'en servir comme base budgétaire. Les descriptions de l'Embeddings Explorer (« résultats en quelques secondes » et « sans GPU ») reposent sur l'outil officiel ; la vitesse réelle dépend du réseau et du téléchargement des données, et des différences d'environnement peuvent modifier l'expérience.
Illustrations de l’article original