Reflection AI présente Beam, un modèle à poids ouverts : 501B de paramètres, 23B activés, poids Apache 2.0 annoncés
Selon un article de MarkTechPost du 5 octobre 2026, Reflection AI a présenté Beam, son premier modèle à poids ouverts : 501B de paramètres totaux, 23B activés par token, destiné aux tâches de programmation et d'agents, avec un paramètre d'intensité de raisonnement et un contexte effectif de 1 million de tokens. Les poids sous Apache 2.0 sont annoncés pour la fin octobre 2026 ; le modèle est encore en phase de red teaming et l'accès se fait uniquement via une liste d'attente.
Ce qui change
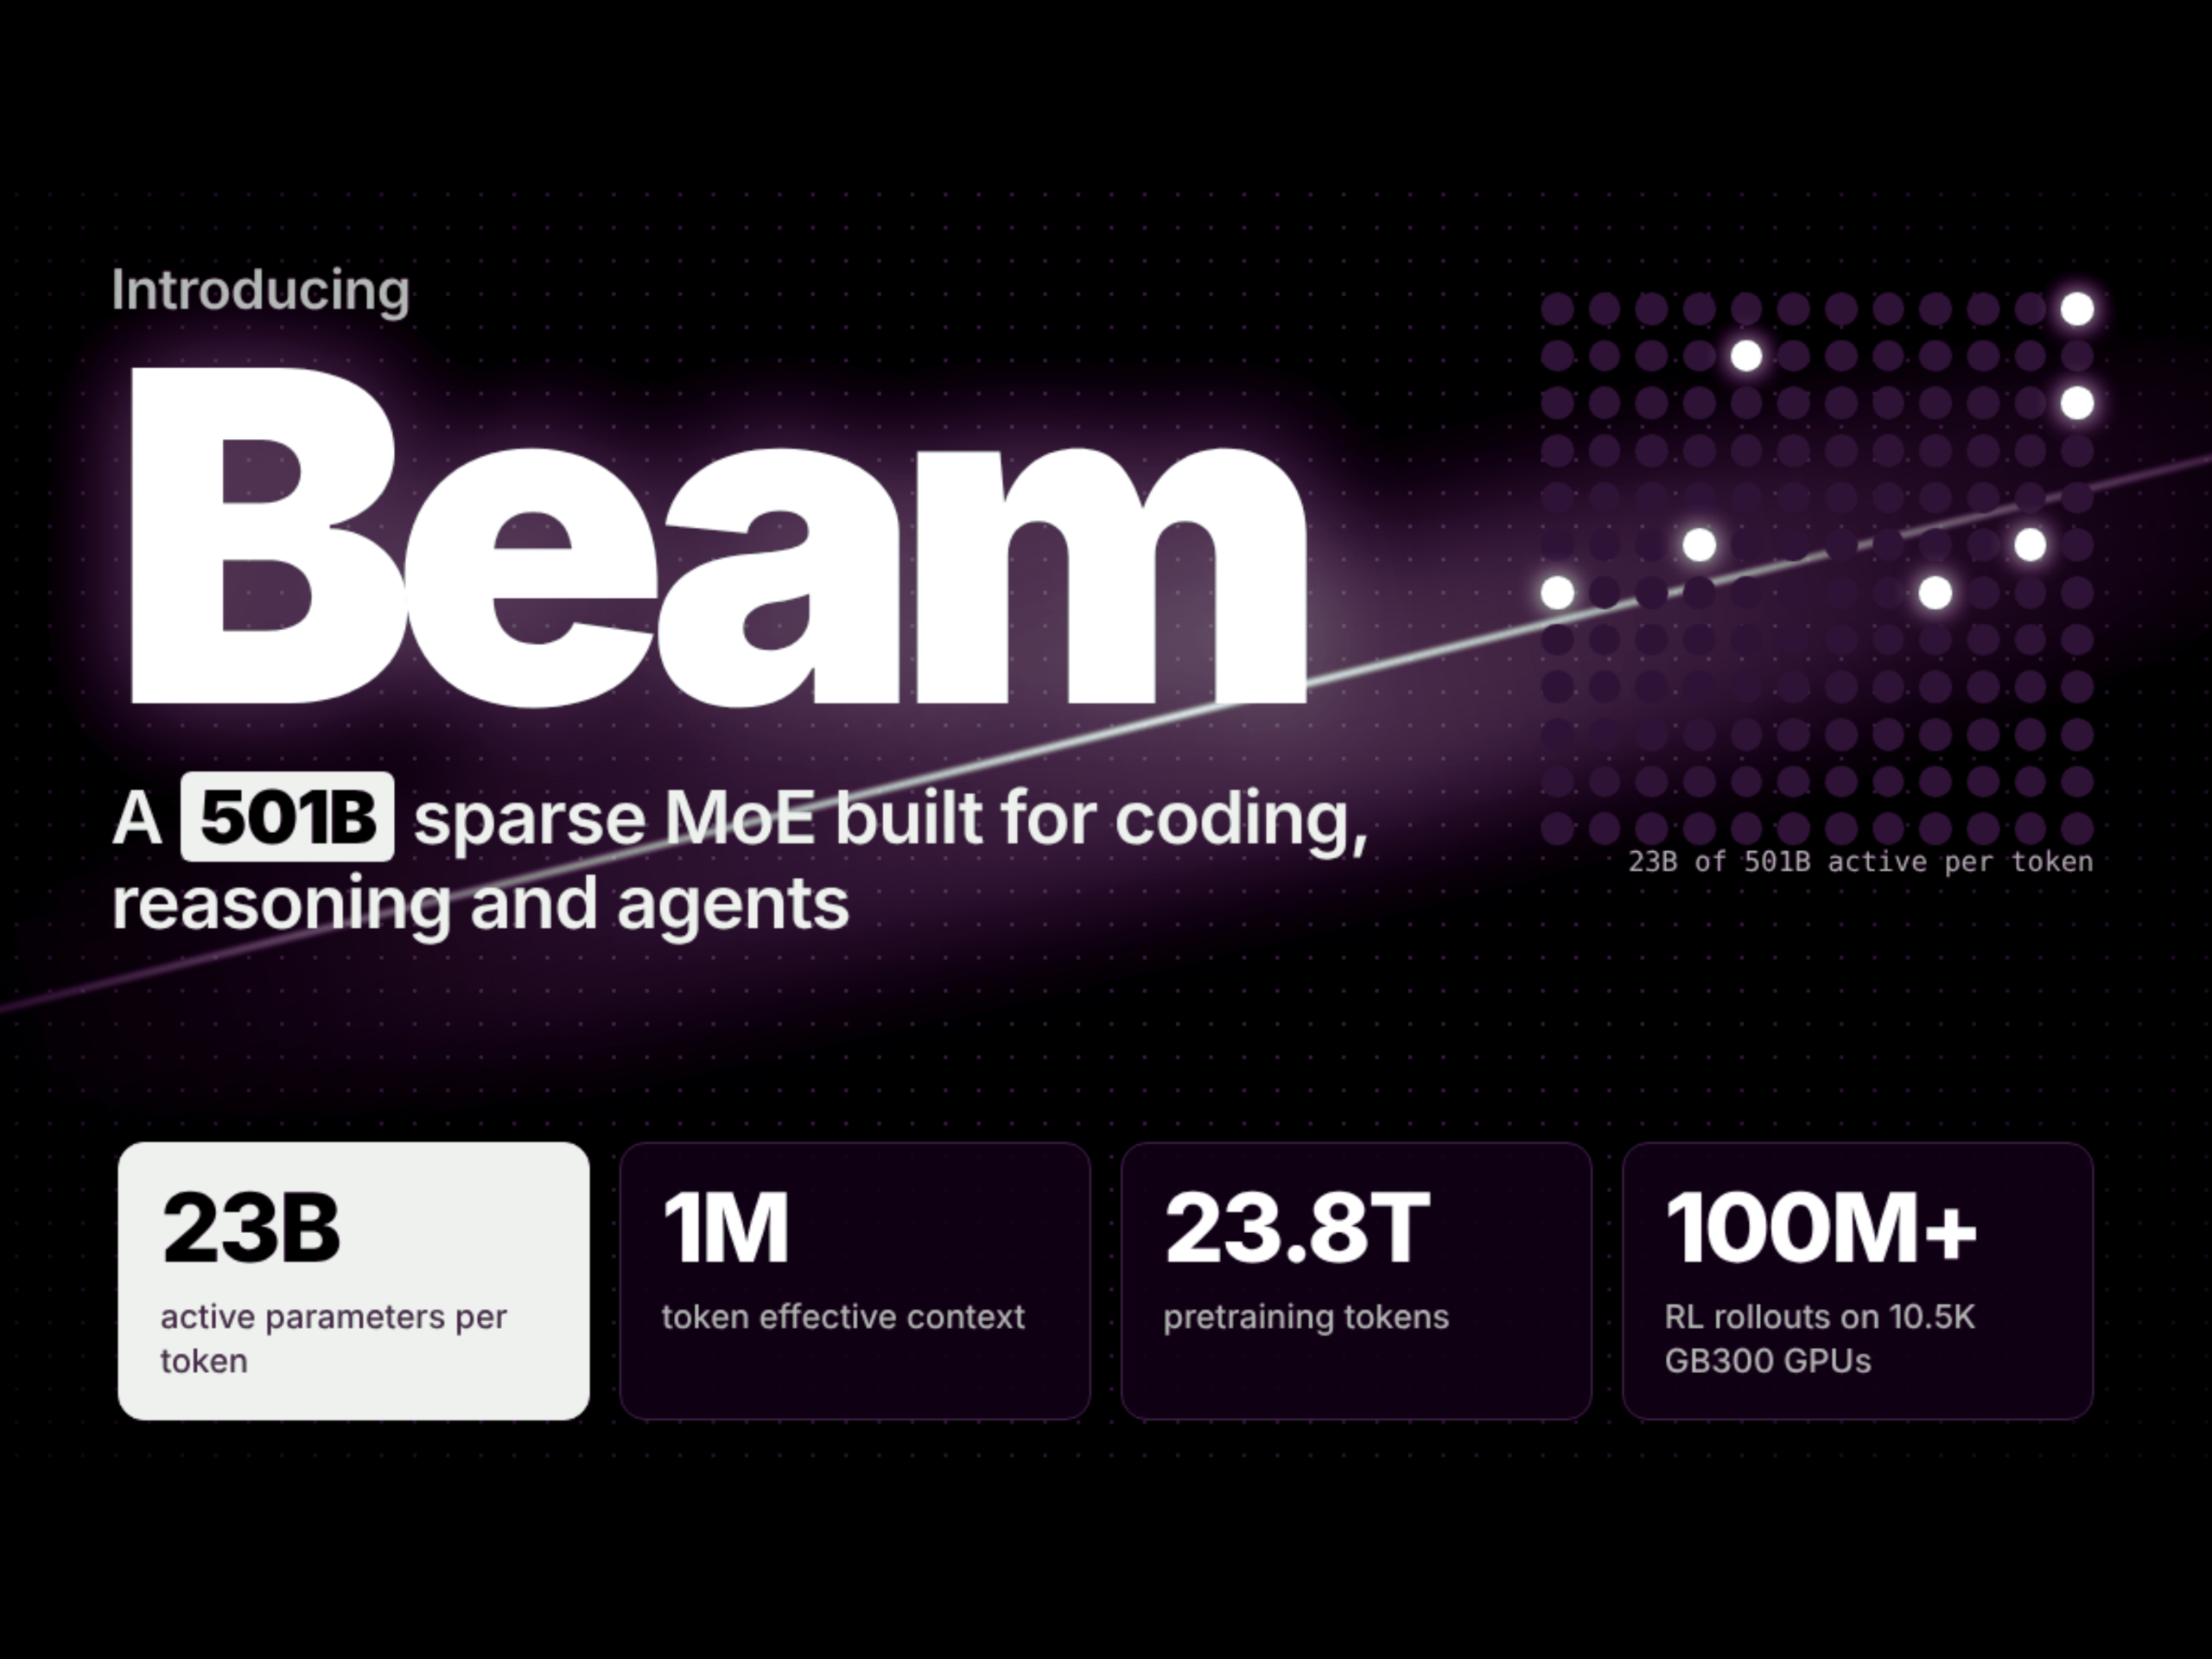
Selon un article de MarkTechPost du 5 octobre 2026, Reflection AI a publié Beam, son premier modèle à poids ouverts. Beam est un modèle à mélange d'experts creux, avec 501B de paramètres totaux et 23B activés par token, destiné aux charges de programmation, de raisonnement et d'agents ; il ne prend en charge que le texte, avec un contexte effectif de 1 million de tokens. L'équipe Reflection affirme que Beam se mesure directement à des modèles ouverts plus grands comme GLM 5.2, avec 3 à 4 fois moins de calcul d'inférence sur les benchmarks de raisonnement, tout en reconnaissant que Kimi K3 reste en tête en capacités brutes. Le modèle offre un paramètre d'intensité de raisonnement, ajustable selon la difficulté de la tâche et le budget de calcul. Le pré-entraînement a utilisé 23,8 billions de tokens, achevé en moins de 4 semaines sur 6 144 GPU NVIDIA GB300 NVL72 ; la phase d'apprentissage par renforcement a duré 4 semaines sur 10,5K GPU GB300, produisant plus de 100 millions de rollouts, avec un contexte de rollout maximal de 256K tokens. Les résultats publiés par Reflection sont SWE-bench Verified 80,9 et Terminal Bench v2.1 80,1. Le modèle serait encore en red teaming final, l'auto-hébergement n'est pas disponible pour l'instant, l'accès anticipé passe par la liste d'attente de la plateforme Reflection, et les poids Apache 2.0 sont prévus pour la fin octobre 2026.
Conséquences pour les développeurs
D'après les spécifications rapportées, Beam ne vise pas simplement à égaler les modèles ouverts les plus puissants, mais à réduire les paramètres activés par token à 23B tout en limitant le total à 501B, échangeant ainsi l'efficacité contre le seuil de déploiement. Pour les développeurs, cela change directement la structure des coûts d'inférence : si l'affirmation d'une économie de calcul de 3 à 4 fois tient, les mêmes tâches de programmation ou d'agents pourraient atteindre un débit proche sur moins de GPU, mais il s'agit d'une déclaration de l'équipe Reflection, non d'une conclusion reproduite indépendamment. Le deuxième impact concerne la licence : le rapport indique que Beam prévoit d'utiliser Apache 2.0, tandis que Kimi K3, comparé dans le tableau, utilise une licence personnalisée avec des exigences d'attribution supplémentaires pour les produits à très grande échelle, GLM-5.2 et DeepSeek V4.1 Flash étant sous MIT et Nemotron 3 Ultra sous OpenMDW-1.1. Il faut souligner que l'ouverture prochaine des poids et l'entrée en vigueur des clauses de licence sont deux choses distinctes : Apache 2.0 n'était encore qu'un projet au moment du rapport ; tant que les poids ne sont pas effectivement publiés avec une licence, aucun droit d'usage ne doit être considéré comme acquis. Le troisième impact est la limite de capacités : Beam ne prend en charge que le texte, contrairement à DeepSeek V4.1 Flash et Kimi K3 qui, dans le tableau, prennent en charge texte et image ; les charges multimodales doivent donc toujours recourir à un autre modèle. Sur les benchmarks, DeepSeek V4.1 Flash et Kimi K3 restent en tête sur Terminal Bench v2.1, ce qui montre qu'un avantage d'efficacité n'équivaut pas à un dépassement global des capacités.
Intégration et évaluation
Ce qui suit relève de recommandations et d'analyses conditionnelles, non de faits rapportés. Décision 1 : faut-il intégrer Beam dans le vivier de candidats pour les agents de programmation. Le rapport indique SWE-bench Verified 80,9 et Terminal Bench v2.1 80,1, tous deux auto-déclarés par Reflection ; cela suppose que les poids et la licence soient réellement publiés, sinon l'évaluation se limite pour l'instant à la liste d'attente. Le critère d'évaluation applicable est le suivant : sur des tâches de génération de correctifs dans vos propres dépôts, comparer le taux de réussite et la consommation de tokens par tâche avec le modèle actuellement utilisé ; un intérêt de bascule n'apparaît que si le taux de réussite est proche et la consommation de tokens nettement inférieure. Décision 2 : comment gérer le compromis coût-qualité lié au paramètre d'intensité de raisonnement. Le rapport indique que ce paramètre favorise les réponses courtes en position basse et permet un raisonnement plus long en position haute ; c'est un point de contrôle explicite propre à Beam, adapté aux pipelines où la difficulté des tâches varie fortement. Le principe de choix est le suivant : fixer d'abord les autres variables, exécuter un même lot de tâches difficiles aux niveaux bas, moyen et haut, enregistrer le taux de réussite et le total de tokens de sortie, identifier le point d'inflexion de la courbe de coût, puis décider quel niveau définir par défaut, plutôt que d'utiliser un niveau unique globalement. Décision 3 : vérification préalable de la licence et de la conformité. Avant la publication des poids, il convient d'inscrire comme prérequis de mise en production la question de savoir si la publication se fera réellement sous Apache 2.0 et si le fichier de licence accompagne les poids ; si les conditions de publication diffèrent des attentes du rapport, la décision de bascule doit être reprise. Le critère d'évaluation est que le fichier de licence soit fourni en même temps que les poids et que ses clauses correspondent aux attentes.
Limites et points à confirmer
Au moment du rapport, Beam était encore en red teaming final, l'auto-hébergement n'était pas disponible et l'accès anticipé se faisait uniquement via la liste d'attente de la plateforme Reflection ; il est donc impossible de tester localement les poids pour l'instant. Tous les scores de benchmark proviennent du tableau publié par Reflection lui-même, les scores des concurrents étant cités d'Artificial Analysis et de DataCurve, sans reproduction par un tiers indépendant ; SWE-bench Verified 80,9 et Terminal Bench v2.1 80,1 doivent être considérés comme des données auto-déclarées par le fournisseur. Apache 2.0 est décrit comme un projet, les poids étant prévus pour la fin octobre 2026 ; lors de la vérification actuelle du catalogue, cette version publiée de Beam n'est pas listée sur KimiSeek, et les disponibilités d'API et de plateforme mentionnées dans le rapport ne concernent que Reflection AI, sans lien avec notre catalogue. Les résultats d'évaluation de sécurité seraient publiés dans le rapport technique, mais aucune donnée concrète n'est disponible à ce jour. L'affirmation d'une économie de calcul d'inférence de 3 à 4 fois provient de l'équipe Reflection, et les conditions de test, le choix des références et la méthode de mesure ne sont pas précisés dans le rapport. La reproductibilité de ce gain d'efficacité en auto-hébergement reste inconnue.
Illustrations de l’article original