Sortie du modèle à poids ouverts Reflection Beam 501B : poids Apache 2.0 et deux voies de déploiement AWS
Selon un blog AWS publié le 16 octobre 2026, Reflection AI lance Beam, un modèle à poids ouverts destiné au codage agentique et aux tâches de longue durée, avec 501B de paramètres totaux, 23B de paramètres activés et un contexte effectif annoncé de 1 million de jetons ; les poids sont publiés sous Apache 2.0 via Hugging Face, avec des points de contrôle BF16/FP8/NVFP4, et deux voies de déploiement sont proposées : SageMaker JumpStart et HyperPod.
Ce qui change
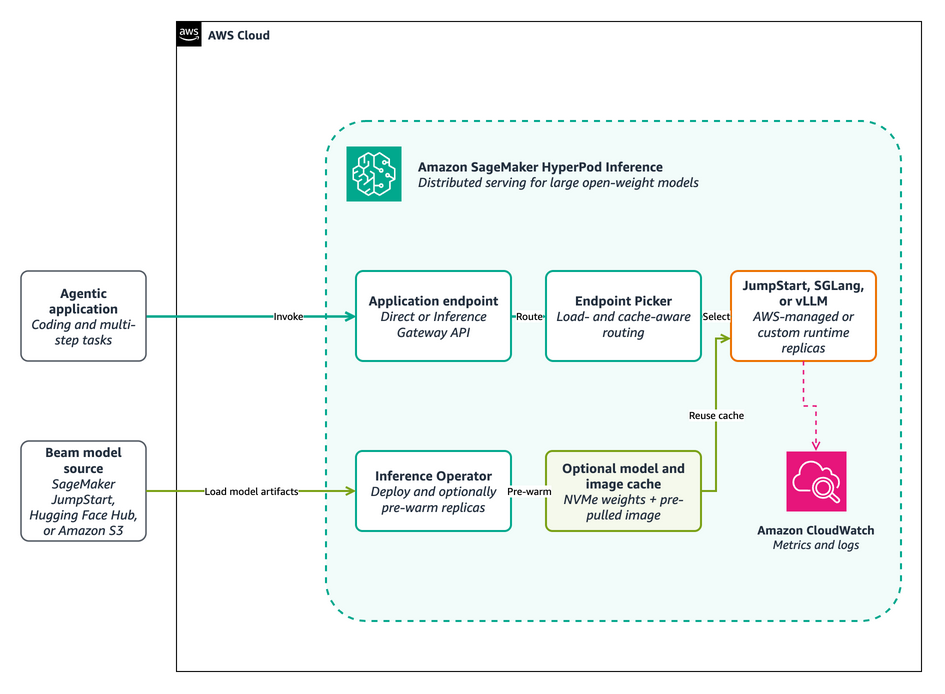
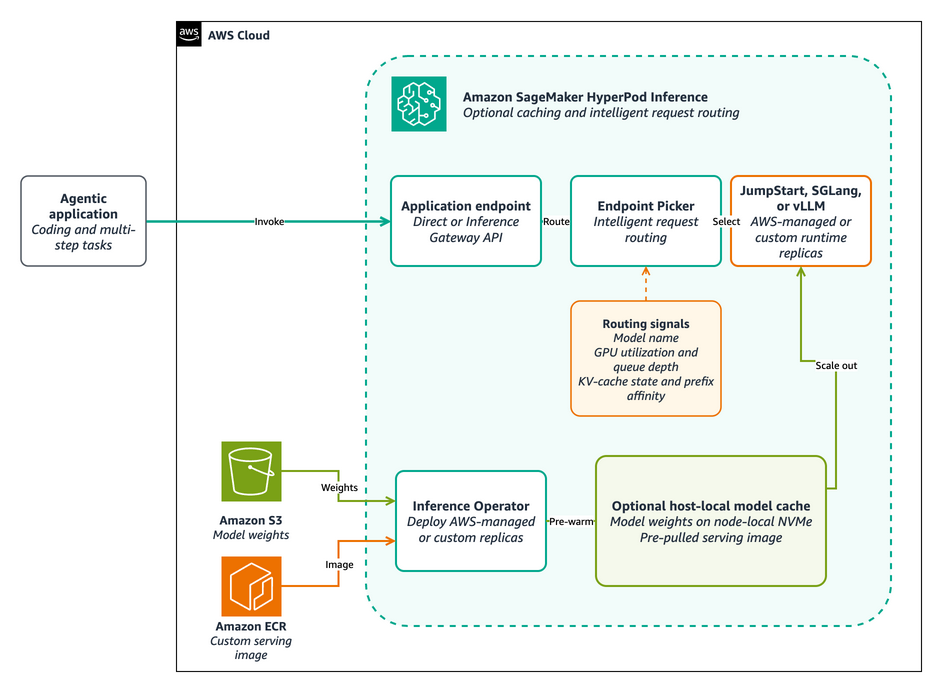
Selon un blog officiel AWS daté du 16 octobre 2026, Reflection AI publie Beam, un modèle à poids ouverts positionné sur le codage agentique et les tâches de longue durée, comme la maintenance de code, l'appel d'outils, l'interprétation de résultats et l'exécution de flux de travail en plusieurs étapes. Le modèle est un mélange d'experts (MoE) clairsemé de 501 milliards de paramètres totaux et 230 milliards de paramètres activés, avec une longueur de contexte effective annoncée par Reflection de 1 million de jetons. Reflection publie les poids de Beam sur Hugging Face sous licence Apache 2.0 ; Beam 1.0 est proposé en trois variantes de points de contrôle, BF16, FP8 et NVFP4, pour s'adapter à différentes empreintes mémoire et à différents matériels. Au moment de la publication, le modèle est disponible dans Amazon SageMaker JumpStart dans deux régions : USA Est (Virginie du Nord) et Ohio. Le blog présente deux voies de déploiement : les points de terminaison temps réel SageMaker JumpStart (entièrement géré) et SageMaker HyperPod Inference (avec le conteneur géré JumpStart ou des solutions personnalisées SGLang, vLLM). Il donne aussi des indications de choix d'instances selon la précision : FP8 sur ml.p5.48xlarge (H100) ou ml.p5e/ml.p5en.48xlarge (H200), NVFP4 sur ml.p6-b200.48xlarge (B200), en soulignant que les poids BF16 demandent le plus de mémoire et nécessitent une planification multi-nœuds. À mettre en parallèle : il s'agit d'une description rapportée par ce blog, et KimiSeek n'a pas vérifié indépendamment les capacités du modèle, la prise en charge des instances ni la disponibilité régionale.
Conséquences pour les développeurs
Conséquence directe pour les développeurs : il s'agit d'une publication de poids ouverts, annoncée sous licence Apache 2.0, ce qui est plus explicite, sur le plan des droits, qu'une simple mise à disposition des poids ; mais les droits de licence doivent toujours être établis à partir du dépôt Hugging Face et du texte des conditions, sans déduire de la disponibilité des poids une autorisation d'usage commercial, de redistribution ou d'entraînement dérivé. Sur le plan technique, la structure clairsemée 501B/A23B signifie que la mémoire et le coût de déploiement dépendent des paramètres totaux, tandis que le calcul par jeton se rapproche de l'échelle des 23B activés : la mémoire des poids, le partitionnement et la disposition du parallélisme sont donc la contrainte première. BF16 exige une mémoire agrégée sur plusieurs nœuds ; FP8 et NVFP4 restreignent le matériel viable à des instances spécifiques H100/H200 et B200. Les formes de déploiement impliquent de vrais compromis : les points de terminaison temps réel JumpStart encapsulent modèle, conteneur et point de terminaison dans un flux géré, adapté à une validation rapide ; HyperPod expose le cluster et le runtime, permet de figer le digest d'image, le commit SHA de Beam et les paramètres de parallélisme, ce qui convient aux équipes devant reproduire des résultats de performance ou personnaliser quantification et parseurs. Le contexte effectif de 1 million de jetons mentionné dans le blog influence le budget de cache KV et la stratégie de traitement par lots ; l'empreinte mémoire en contexte long doit être mesurée, non estimée. Pour l'évaluation, le modèle cible les appels d'outils en plusieurs étapes : les benchmarks de questions-réponses à un seul tour ne suffisent pas à rendre compte de son comportement dans une véritable boucle agentique ; il faut construire la charge avec des requêtes représentatives de codage et d'usage d'outils.
Intégration et évaluation
Voici des recommandations d'évaluation fondées sur ce blog, et non des conclusions vérifiées. Premièrement, décider d'abord entre gestion déléguée et auto-hébergement : si l'objectif est d'intégrer rapidement et que l'équipe n'a pas de compétences Kubernetes, utiliser les points de terminaison temps réel JumpStart sur un cycle de vie borné (déploiement, une requête, nettoyage), avec comme critère de succès une réponse conforme au schéma de requête publié une fois le point de terminaison prêt ; ne passer à SGLang ou vLLM sur HyperPod que si des paramètres de runtime fixes, une quantification ou des parseurs personnalisés sont nécessaires, en retenant comme critère de passage la reproductibilité du digest d'image, de la révision du modèle et de la configuration de parallélisme. Deuxièmement, trancher une fois la capacité selon la précision : estimer la mémoire agrégée à partir des poids d'une réplique, du cache KV et des surcoûts du runtime, puis corriger par des tests de charge ; si le contexte visé approche la limite effective annoncée, vérifier d'abord que le temps p95 jusqu'au premier jeton et le temps par jeton de sortie en contexte long respectent le budget de latence ; en NVFP4 ou FP8, revérifier impérativement l'absence de dégradation de la qualité de sortie. Troisièmement, fixer une ligne d'acceptation mesurable pour les scénarios agentiques : soumettre à répétition des requêtes réelles de correction de code et d'appels d'outils multi-étapes à la concurrence attendue, consigner taux de réussite, temps p50/p95 jusqu'au premier jeton, latence de bout en bout et débit de sortie agrégé, et archiver version du modèle, digest d'image, précision, longueur de contexte et état du cache, faute de quoi les comparaisons entre configurations ne sont pas valables. Quatrièmement, valider à petite échelle avant de monter en charge : vérifier les quotas de service et la capacité régionale du type d'instance choisi, en gardant à l'esprit que le transfert d'image, le téléchargement des poids et le chargement des fragments représentent un temps de démarrage à froid notable ; les stratégies de cache et d'autoscaling doivent reposer sur des mesures, non sur des hypothèses. Cinquièmement, après les tests, nettoyer les points de terminaison, clusters, poids en cache et ressources IAM temporaires conformément aux exemples officiels, afin d'éviter une facturation continue.
Limites et points à confirmer
Le Beam 1.0 (501B/A23B) concerné par cette publication n'est pas proposé sur KimiSeek : les voies de déploiement, modes d'appel et toute disponibilité décrits ici renvoient aux canaux de publication de Reflection AI et d'AWS, non à un service de ce site ; les Kimi K3, GLM, Qwen, DeepSeek et autres disponibles sur KimiSeek sont des modèles différents et ne prouvent pas la disponibilité de cette version. Ce compte rendu repose sur une source unique, le blog AWS ; KimiSeek n'a pas vérifié indépendamment le nombre de paramètres, la longueur de contexte effective, le champ d'application réel de la licence Apache 2.0, la compatibilité matérielle des variantes de points de contrôle, l'état de disponibilité dans les deux régions de l'Est des États-Unis, ni les performances du modèle en benchmark ; le blog ne fournit aucun score public de benchmark de codage ou agentique, et les affirmations de capacité ne doivent pas être considérées comme des faits vérifiés. Des poids ouverts ne signifient pas un logiciel entièrement open source : les conditions de licence, les données d'entraînement et le matériel de reproduction doivent être établis à partir du dépôt Hugging Face et des déclarations officielles de Reflection. Les capacités de cache, de routage et de passerelle HyperPod mentionnées relèvent des fonctionnalités SageMaker de 2026, dont le comportement évolue selon les versions ; il convient de consulter la documentation correspondante, et les types d'instances comme les régions peuvent changer avec le temps. Pour les coûts, se référer aux pages de tarification ou de facturation respectives de Reflection AI, Hugging Face et AWS : prix et quotas évoluent. Enfin, les paramètres d'échantillonnage cités dans le blog (temperature, top-p, par exemple) ne sont que des valeurs de départ indicatives, et non une configuration recommandée.
Illustrations de l’article original