Reflection Beam et Mistral Large 4 présentés en même temps : plus d'options à poids ouverts, mais les poids et les licences restent à venir
Selon un article publié en octobre 2026 par InfoQ édition chinoise, l'américain Reflection a présenté Beam, son premier modèle MoE à poids ouverts, les 5 et 6 octobre, tandis que le français Mistral lançait Mistral Large 4, son plus grand modèle à ce jour. Selon l'article, l'efficacité d'inférence est l'argument de vente de Beam, dont certains résultats de référence approchent GLM-5.2 mais restent en retrait de la dernière génération chinoise ; Large 4 dispose d'un aperçu API ouvert, les poids complets étant annoncés pour fin octobre. Aucune des deux versions n'est actuellement référencée sur KimiSeek.
Ce qui change
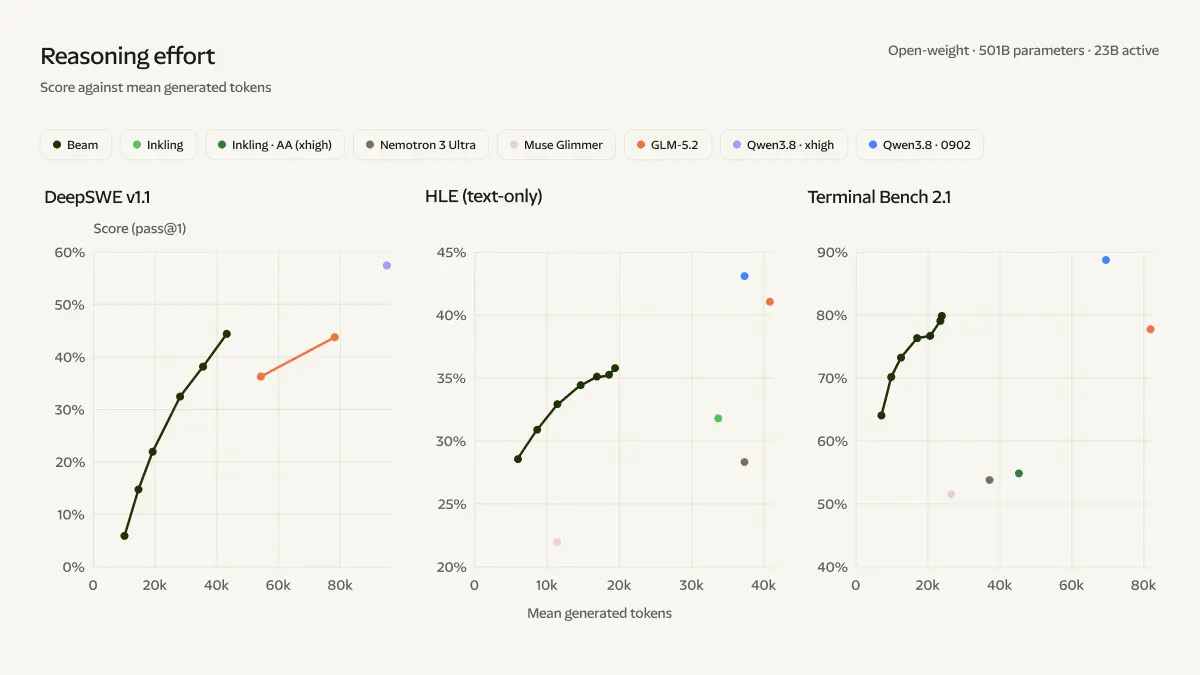
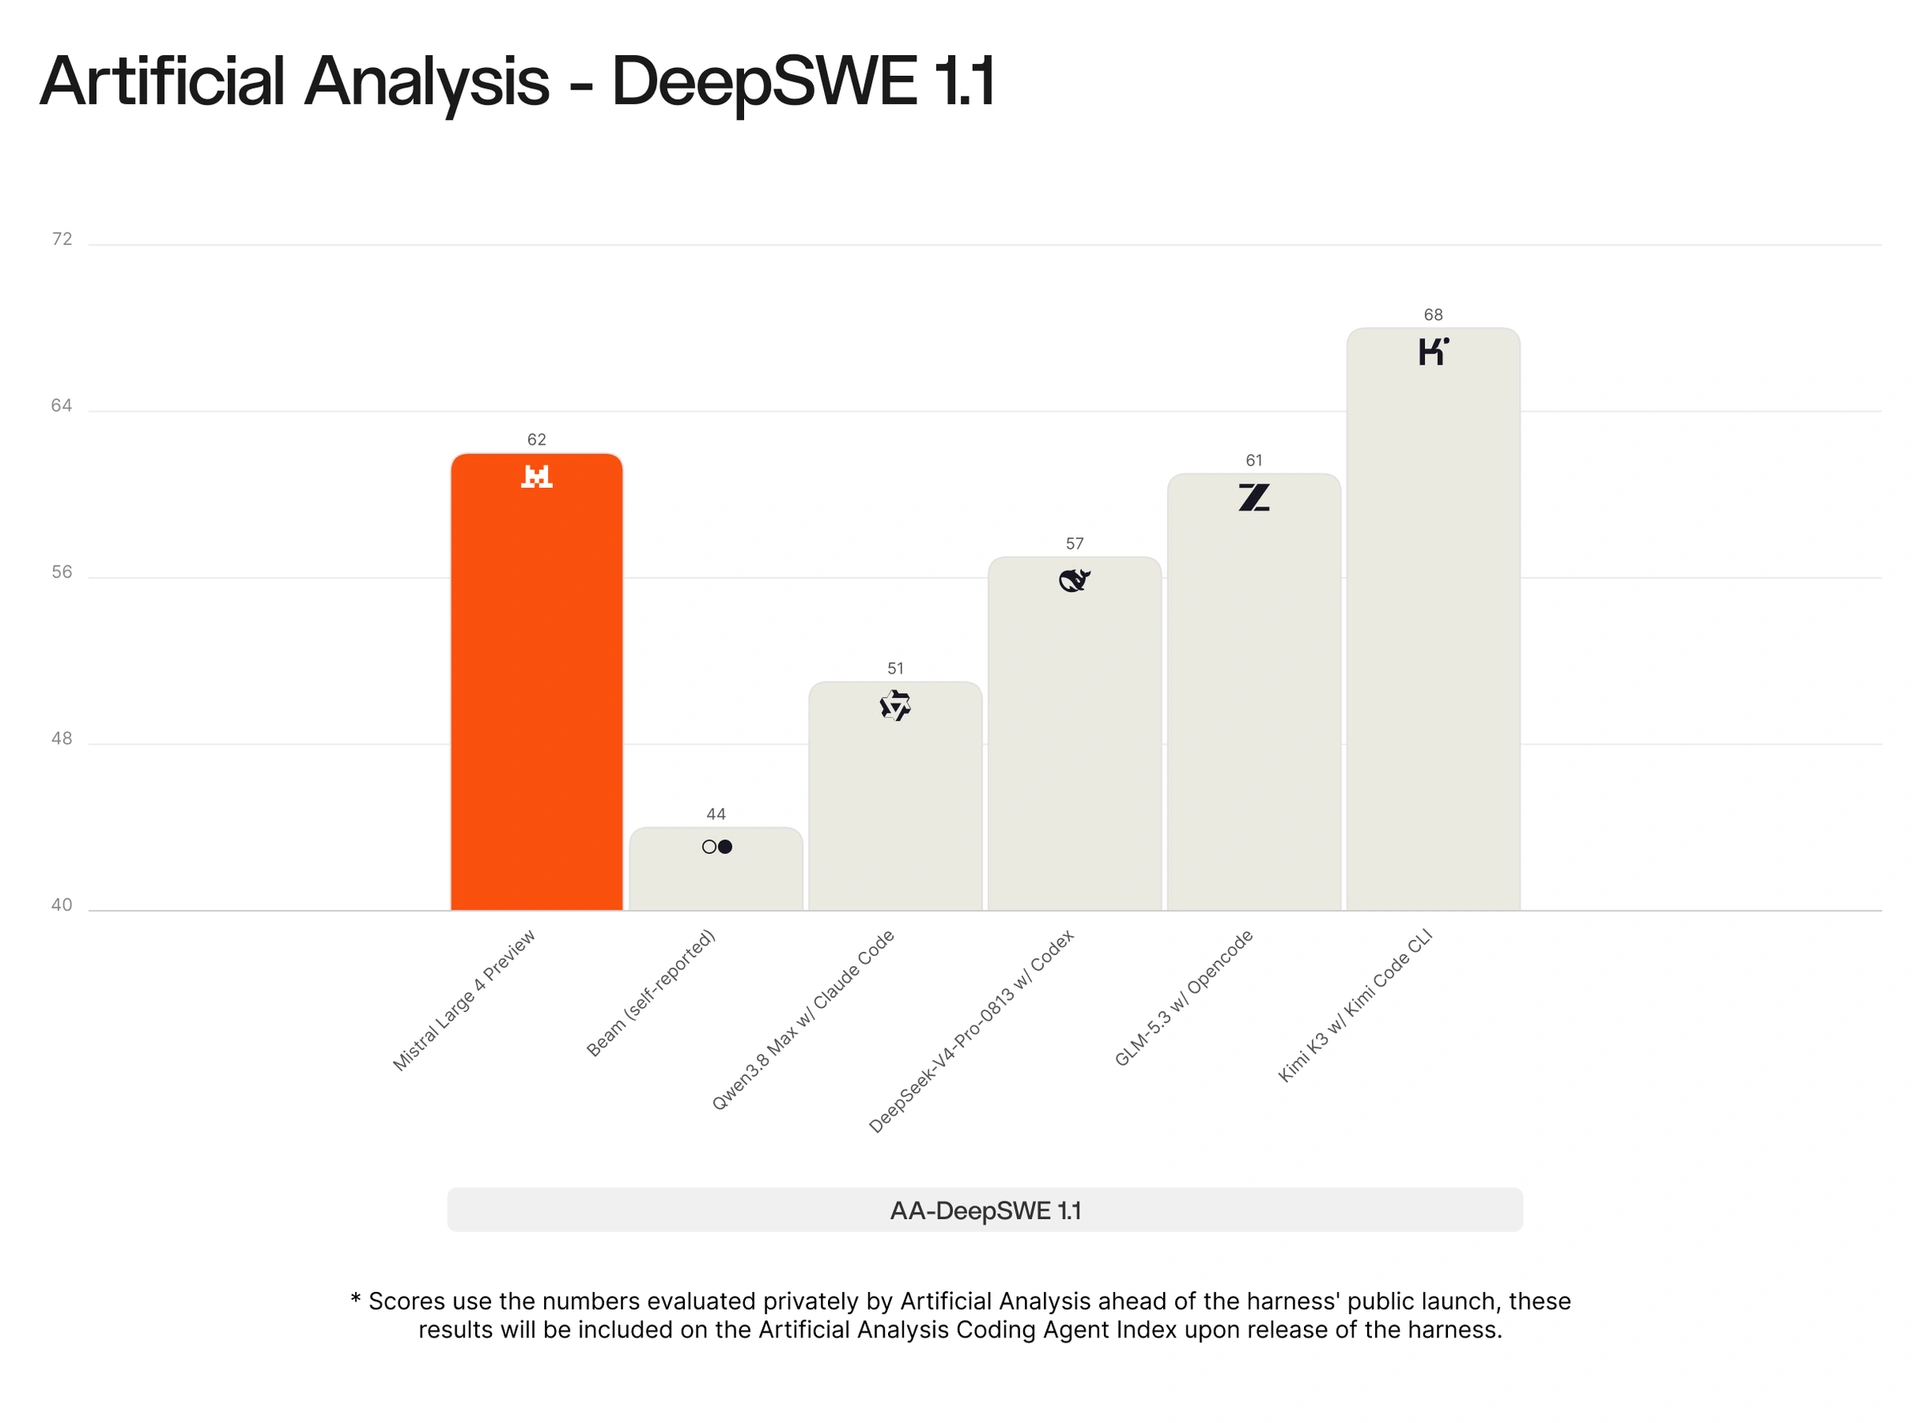
Selon InfoQ édition chinoise (daté du 5 au 6 octobre, heure locale), la start-up américaine Reflection a publié Beam, son premier modèle à poids ouverts, et un jour plus tard Mistral a lancé Mistral Large 4. Selon l'article, Beam est un modèle MoE de 501 milliards de paramètres au total et 23 milliards activés par Token, destiné aux charges de programmation, de raisonnement et d'Agent, pré-entraîné sur 23,8 billions de Tokens et entraîné par apprentissage par renforcement intensif pendant quatre semaines consécutives sur 10 500 GPU Nvidia GB300, générant plus de 100 millions de rollouts ; au moment de la publication, il était encore en phase finale de tests red team, et Reflection prévoyait de publier les poids, le rapport technique et les outils de développement en octobre. Mistral Large 4 est rapporté comme activant 52 milliards de paramètres pour 1,05 billion au total, avec un encodeur visuel de 1,6 milliard de paramètres, nativement multimodal, prenant en charge plus de 160 langues et une fenêtre de contexte de 1 million de Tokens ; il aurait été entraîné de zéro dans des centres de données européens sur environ 3 800 GPU Nvidia Grace Blackwell, avec un aperçu API ouvert au moment de l'article et des poids complets annoncés pour fin octobre. Parmi les chiffres de référence relayés, Beam obtient 44,4 sur DeepSWE v1.1 et 80,1 sur Terminal Bench v2.1, tous deux inférieurs aux résultats cités de GLM-5.3, Kimi K3 et DeepSeek V4.1 Flash ; sur Humanity's Last Exam, Beam obtient 36,2, inférieur aux 42,3 de GLM-5.3 et aux 46,9 de Kimi K3 également cités (l'article ne donne pas le score de DeepSeek V4.1 Flash sur cette épreuve). Côté Mistral, l'article indique que Large 4 dépasse DeepSeek V4 Pro et Qwen 3.8 Max mais reste derrière Kimi K3 sur l'index officiel Coding Agent, et dépasse Kimi K3, MiMo-V2.6-Pro et DeepSeek V4 Pro tout en restant derrière GLM-5.3 sur AutomationBench. Ces scores proviennent d'évaluations revendiquées par les éditeurs ou de tests tiers cités par eux ; ils sont relayés par l'article et n'ont pas été reproduits de façon indépendante.
Conséquences pour les développeurs
Cette série de publications modifie l'ensemble des candidats à poids ouverts et les repères de comparaison, sans changer immédiatement la disponibilité des modèles chinois. L'élément le plus significatif sur le plan technique est que Reflection déplace l'argument de vente de Beam de la capacité absolue vers « combien d'intelligence par unité de calcul d'inférence » : selon l'article, certaines tâches de raisonnement avancé peuvent atteindre des performances proches avec environ un quart à un tiers du calcul de GLM-5.2 ; si cette affirmation se vérifie sur des charges réelles, c'est la structure de coût par tâche des Agents à longue chaîne et de l'inférence par lots qui est concernée. Mais d'après les références relayées, Beam rattrape surtout la génération précédente de modèles chinois : il est inférieur à GLM-5.3, Kimi K3 et DeepSeek V4.1 Flash cités sur DeepSWE v1.1 et Terminal Bench v2.1, et inférieur à GLM-5.3 et Kimi K3 cités sur HLE. « Moins de calcul pour une capacité proche » et « autant de calcul pour une meilleure qualité » sont donc deux voies de remplacement distinctes, non interchangeables. Mistral Large 4 met l'accent ailleurs : contexte de l'ordre du million, multimodalité native et multilingue, plus le déploiement en cloud privé ou local et les politiques de sécurité personnalisées soulignés par l'article, ce qui vise les flux de travail d'entreprise multi-applications et les scénarios exigeant de contrôler les frontières des données, plutôt qu'une compétition pure sur les références de programmation. Une distinction s'impose : les deux sont décrits comme à poids ouverts, mais les dates de disponibilité des poids diffèrent dans l'article, et aucun des deux n'avait réellement ouvert ses poids à la publication ; les poids ouverts désignent des fichiers de modèle téléchargeables, ce qui est une question différente de l'ouverture des données d'entraînement, du code d'entraînement et des termes de licence ; l'article ne fournit pas de détails de licence, et l'on ne peut en déduire des droits d'usage commercial, de redistribution ou de fine-tuning. Par ailleurs, une vérification du catalogue actuel montre qu'aucune entrée ne correspond à Beam ni à Mistral Large 4 sur KimiSeek ; l'aperçu API et la disponibilité décrits renvoient aux canaux propres des éditeurs.
Intégration et évaluation
Ce qui suit relève d'une analyse ou de recommandations conditionnelles, non de faits rapportés. Premièrement, si la charge principale est la programmation d'Agents à longue chaîne et que le coût est sensible : l'article indique que Beam peut approcher les performances de GLM-5.2 avec environ un quart à un tiers de son calcul d'inférence, et les options comparables actuellement disponibles incluent GLM-5.2 et DeepSeek V4.1 Flash ; on peut d'abord mener une comparaison sur petit échantillon à partir de ses propres trajectoires d'appels d'outils multi-tours, en mesurant le « nombre total de Tokens et la latence de bout en bout par tâche accomplie », à condition d'accepter un niveau inférieur à la dernière génération chinoise dans les références citées ; si la hausse du taux d'échec déclenche des reprises, l'économie de calcul est annulée et le remplacement n'est pas indiqué, le critère d'évaluation pouvant être une baisse du taux de réussite de bout en bout sur le même ensemble de tâches ne dépassant pas un seuil prédéfini. Deuxièmement, si la charge exige un contexte de l'ordre du million, des entrées multimodales ou le multilingue : Mistral Large 4 est rapporté comme prenant en charge un contexte de 1 million de Tokens et plus de 160 langues, mais les poids et les termes définitifs ne sont pas fixés ; il faut d'abord, pendant la phase d'aperçu API, vérifier la précision de la recherche sur contexte long et le comportement de l'encodeur visuel sur ses propres documents, en mesurant la précision des questions-réponses à contexte long et le coût par requête, à condition de ne pas assimiler le comportement de la version d'aperçu à celui des futurs poids ouverts et de conserver le modèle principal actuel comme repli. Ces deux règles devraient être revues une fois les poids officiellement publiés et la licence précisée.
Limites et points à confirmer
Le contenu de l'article provient principalement de déclarations des éditeurs et de tests tiers cités par eux ; les scores de référence n'ont pas été reproduits de façon indépendante et ne doivent pas être considérés comme des conclusions vérifiées. Il faut souligner en particulier que l'article ne donne, sur Humanity's Last Exam, que Beam 36,2, GLM-5.3 42,3 et Kimi K3 46,9, sans indiquer le score HLE de DeepSeek V4.1 Flash ; la comparaison sur HLE doit donc se limiter à GLM-5.3 et Kimi K3 effectivement cités, et fusionner les trois références en un « inférieur aux trois » constituerait une comparaison inter-références non étayée par l'article. En outre, ni Beam ni Mistral Large 4 n'ont d'entrée correspondante dans les modèles actuels de KimiSeek, c'est-à-dire que ces deux versions ne sont pas référencées sur KimiSeek ; l'aperçu API et le calendrier de publication des poids décrits concernent la disponibilité via les canaux propres des éditeurs, indépendamment de leur présence sur KimiSeek. La disponibilité des poids n'équivaut pas à une licence open source : l'article ne donne pas les termes de licence, et les droits d'usage commercial et de redistribution dépendent de la licence effectivement publiée par les éditeurs. Selon l'article, les poids de Beam doivent être publiés en octobre et les poids complets de Large 4 fin octobre ; aucun des deux n'avait réellement ouvert ses poids à la publication, et l'on ignore s'ils respecteront ce calendrier et comment les termes évolueront. L'affirmation d'« environ un quart à un tiers du calcul » est une déclaration de Reflection, sans méthode de mesure indépendante ; l'effet réel d'un remplacement doit être vérifié sur ses propres charges. Ce brief ne juge pas si les deux entreprises tiendront leurs feuilles de route ou leurs engagements commerciaux.
Illustrations de l’article original