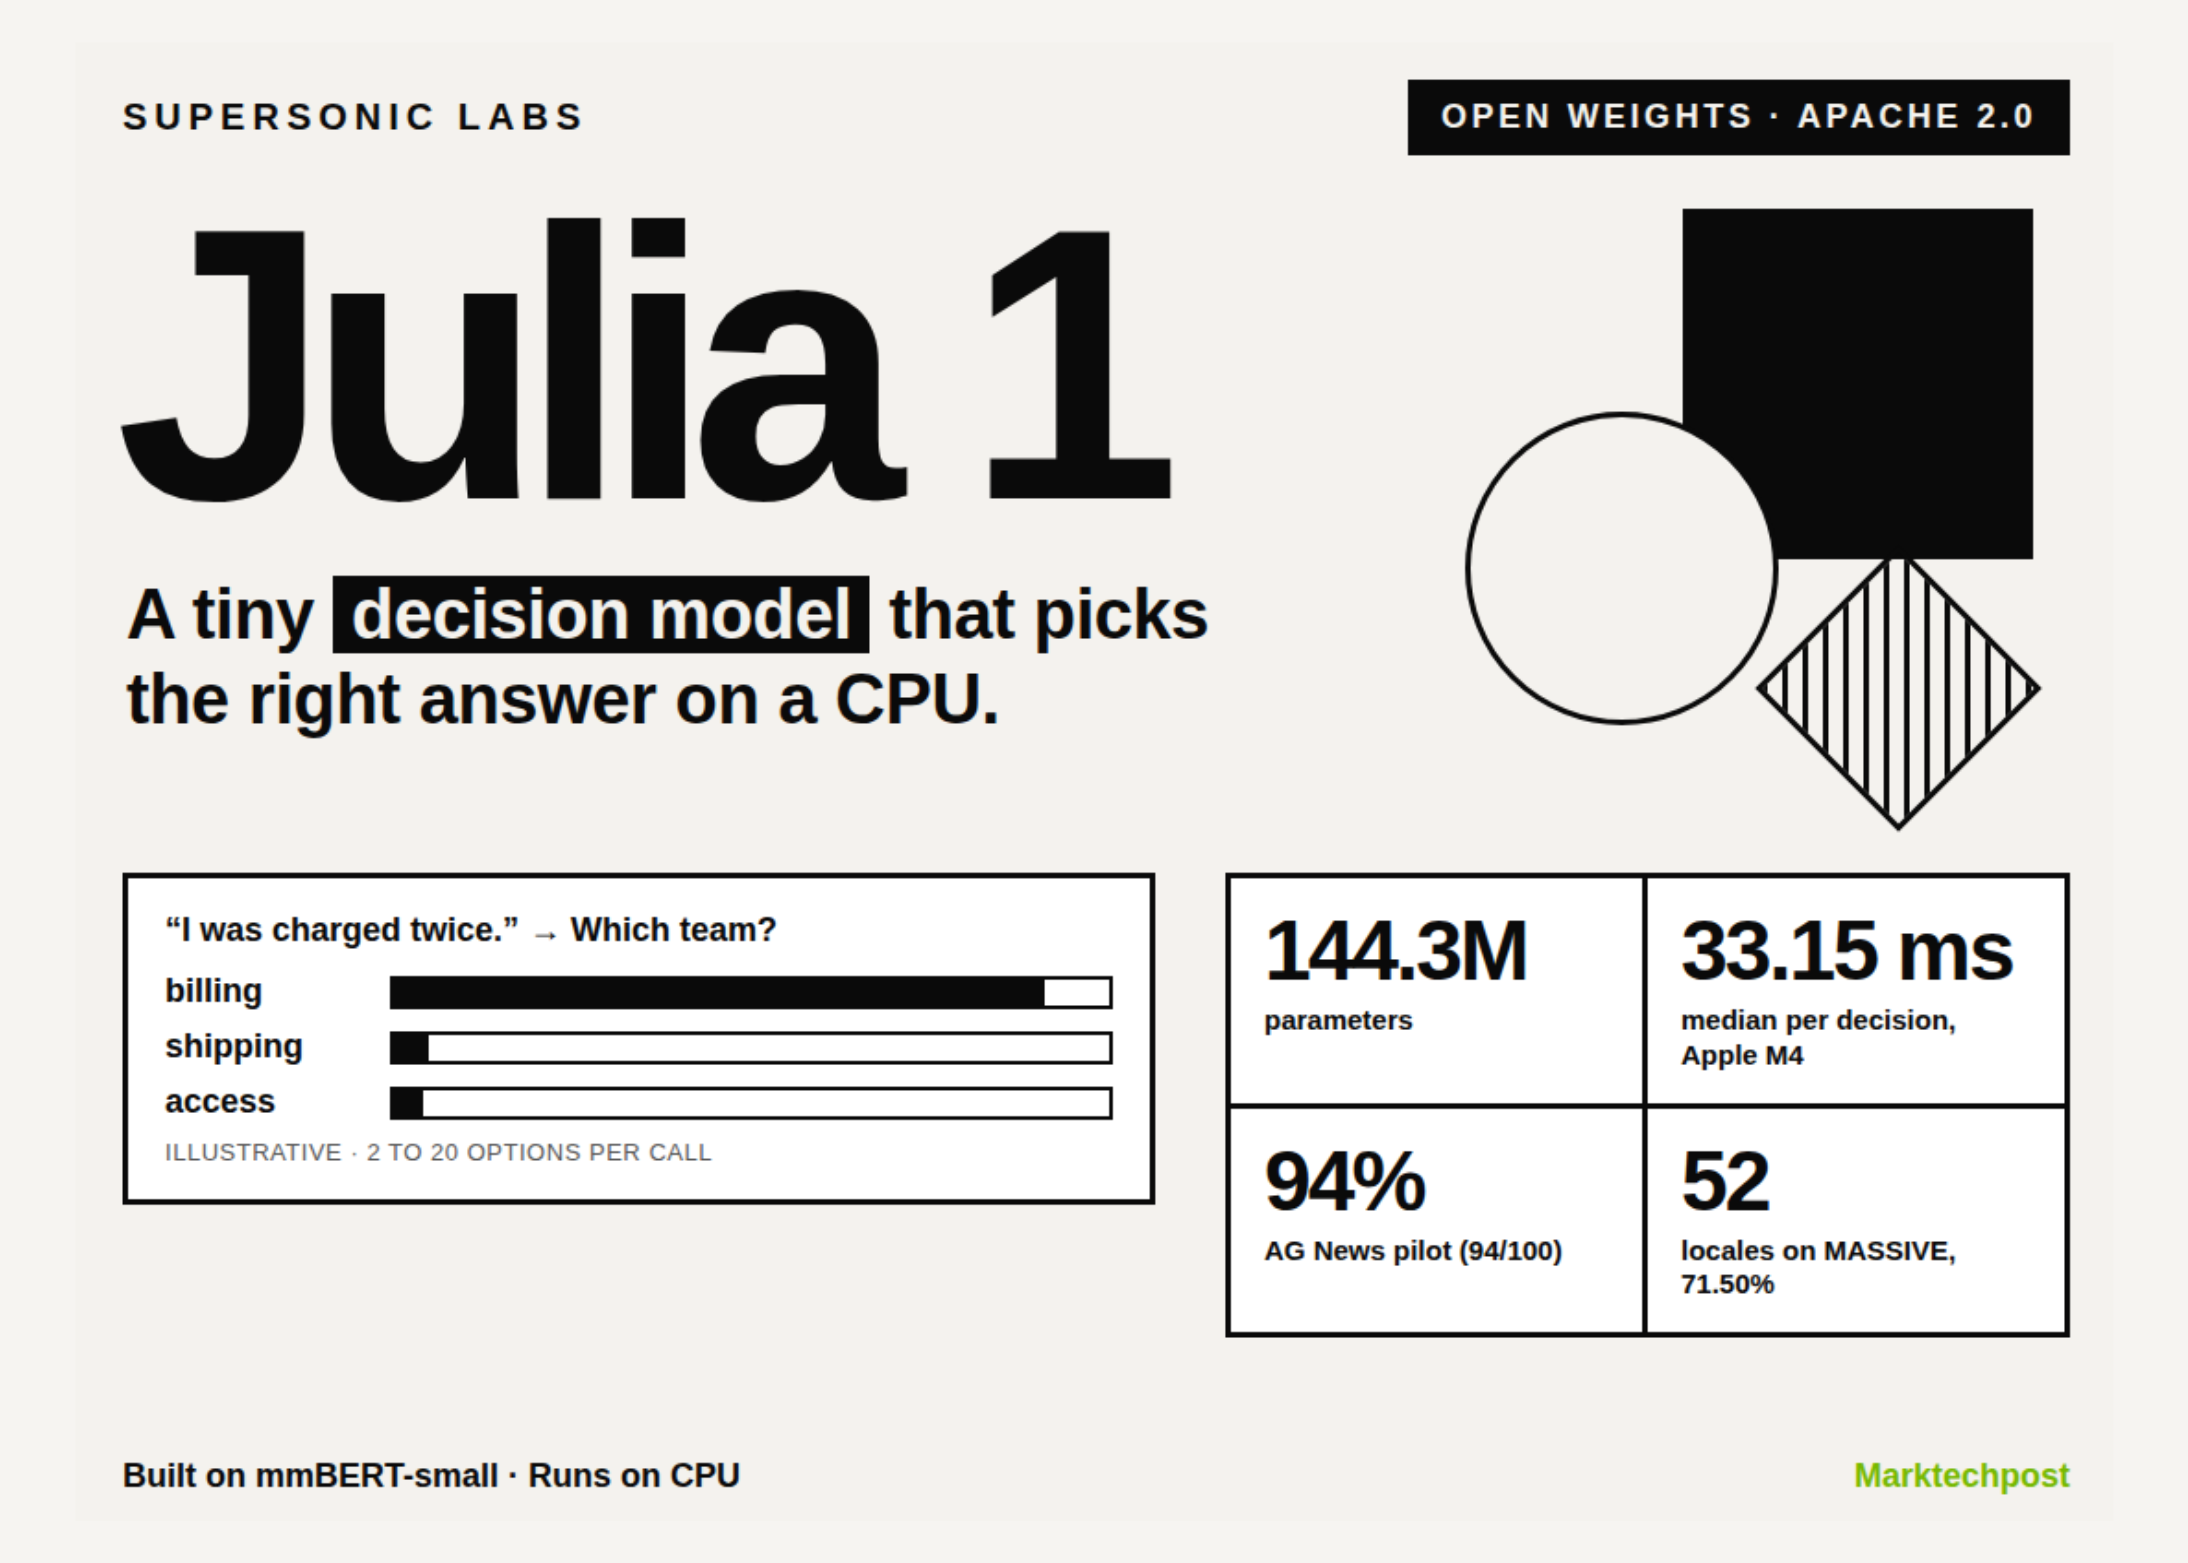
Supersonic Labs publie Julia 1 : un modèle de décision de 144,3 millions de paramètres sous Apache 2.0, exécutable sur CPU en local
Selon un article de MarkTechPost du 26 septembre 2026, le petit laboratoire brésilien Supersonic Labs publie Julia 1, un modèle de décision de 144,3 millions de paramètres dérivé de mmBERT-small, dont les poids sont diffusés sous Apache 2.0 et qui prend en charge trois types d'appels, choice, score et noul, avec une exécution locale sur CPU. Ses essais dépassent les valeurs de référence Jev sur Typed Decisions, AG News et DAIR Emotion, mais restent nettement en retrait sur Banking77 à 72 étiquettes ; l'API hébergée est annoncée mais pas encore ouverte.

Ce qui change
Selon un article de MarkTechPost du 26 septembre 2026, le petit laboratoire brésilien Supersonic Labs publie Julia 1 (à noter : cette version n'est pas listée dans le catalogue KimiSeek, et la disponibilité d'API mentionnée dans l'article renvoie au côté fournisseur). Il s'agit d'un modèle de décision et non d'un modèle de conversation : l'appelant fournit un contexte, une question et 2 à 20 réponses candidates accompagnées de descriptions ; le modèle renvoie l'élément choisi dans l'ordre donné avec l'ensemble des probabilités softmax, l'identifiant de l'appelant est retransmis tel quel, et aucun texte libre n'est généré. Les poids sont publiés sous Apache 2.0 sur Hugging Face (la disponibilité des poids n'équivaut pas à une licence open source ; ici la source indique explicitement Apache 2.0), et le modèle s'exécute sous Python 3.11+ sur CPU ou sur GPU compatible BF16 ; une construction ONNX permet aussi de l'exécuter dans un navigateur via WebGPU ; l'API hébergée est annoncée mais pas encore ouverte. Le modèle repose sur l'encodeur mmBERT-small du JHU CLSP complété par une tête de décision, et le laboratoire indique explicitement qu'il ne s'agit pas d'un fine-tuning de Qwen. La limite de tokens fusionnés à l'exécution est de 8 192, les benchmarks publics utilisant 1 024. Les trois types d'appels sont choice (classification, routage), score (notation ordonnée renvoyant l'indice attendu) et noul (probabilité qu'une proposition soit vraie ou fausse). L'évaluation du 24 septembre 2026 rapportée dans l'article a été exécutée sur H200 en BF16 avec un encodage strict, et la comparaison porte sur les valeurs de référence du protocole de benchmark TypeSafe Jev, non sur une réexécution de Jev : Typed Decisions 73,15 % (référence 72,70 %), AG News 94/100 (référence 91 %), DAIR Emotion 86/100 (référence 48 %), Banking77 seulement 64/100 (référence 87 %), MASSIVE avec une moyenne macro de 71,50 % sur 52 régions linguistiques, pt-PT 86,25 %, en-US 86,75 %. Les essais de classification ne portent que sur 100 échantillons chacun. Une exécution sur CPU du 25 septembre a reproduit Typed Decisions à 72,55 %, Banking77 à 60/100, avec 3 abandons de réponse. En matière de latence, l'article rapporte une médiane de 33,15 ms par décision sur Apple M4, une médiane de 203 ms et un RSS maximal de 393,1 Mo sur une tablette Samsung SM-X510 via ONNX Runtime, une médiane de 107,83 ms sur AG News sur Intel Core i5-1235U, tandis que Banking77, qui doit d'abord réduire 72 étiquettes, demande 3 713,54 ms.
Conséquences pour les développeurs
L'effet direct pour les développeurs est l'apparition d'une voie optionnelle consistant à sortir la classification, le routage et la notation des grands modèles pour les placer sur un petit modèle embarqué. Avec 144,3 millions de paramètres et environ 550,5 MiB de poids en FP32, il peut tenir dans un téléphone, une tablette, un ordinateur portable voire un navigateur, sans payer ni se connecter à chaque appel de classification ; le tarif d'API annoncé dans l'article est de 0,025 dollar par million de tokens d'entrée, mais cette API n'est pas encore ouverte et ce tarif provient d'un article de septembre 2026 : les lecteurs doivent vérifier le prix courant sur la page la plus récente du fournisseur, et non dans cet article. Il faut aussi bien voir les limites de capacité : le modèle compare uniquement les candidats fournis, ne comble pas de faits manquants et ne fait ni algèbre ni calcul à plusieurs étapes ; le Router peut écarter la bonne étiquette lors de la réduction, et il ne s'agit pas d'un composant directement substituable aux pipelines Transformers existants, l'article indiquant qu'aucun fournisseur d'inférence Hugging Face ne l'héberge. Sur le plan des benchmarks, le signal le plus important n'est pas les trois scores supérieurs à Jev, mais la dégradation brutale lorsque l'espace d'étiquettes passe de 4 ou 6 à 72 : AG News 94/100 contre Banking77 64/100, et seulement 60/100 lors de la reproduction sur CPU ; il convient donc mieux aux jugements grossiers à peu d'étiquettes qu'à une classification fine multi-classes. Par ailleurs, l'affirmation d'une vitesse cinq fois supérieure à Jev vient d'un post X du fournisseur, tandis que l'essai Jev a mesuré Jev comme service hébergé appelé depuis la France ; les latences ne sont pas comparées à conditions égales et ne doivent pas être reprises telles quelles.
Intégration et évaluation
Ce qui suit est une analyse conditionnelle et des recommandations fondées sur l'article, et non des faits vérifiés. Première décision : faut-il utiliser directement la sortie du modèle pour le routage automatique en production. L'article rapporte deux phénomènes distincts à traiter séparément : la dégradation à mesure que le nombre d'étiquettes augmente (Banking77 64/100, 60/100 sur CPU) et le risque que le Router écarte des étiquettes. Si votre scénario dépasse une vingtaine d'étiquettes et qu'une erreur déclenche des actions irréversibles comme un débit, une autorisation ou un remboursement, il est conseillé de ne pas exécuter directement la sortie du modèle et d'ajouter une seconde vérification ou une relecture humaine ; si les étiquettes sont peu nombreuses (par exemple une classification grossière en 4 classes au plus) et que les actions sont réversibles, un déploiement progressif est envisageable. Critère d'évaluation mesurable : sur au moins 200 requêtes réelles échantillonnées par vous-même, comparez le taux de concordance entre l'élément choisi par le modèle et l'annotation humaine, en comptant séparément la proportion de bonnes réponses écartées lors de la phase de réduction du Router. Deuxième décision : remplacer les appels de classification hébergés existants par un déploiement embarqué. Les mesures d'appareils rapportées sont une médiane de 33,15 ms sur M4, 203 ms sur SM-X510 et 107,83 ms sur AG News sur i5-1235U, tandis que Banking77 atteint 3 713,54 ms : le nombre de candidats ou la taille de l'espace d'étiquettes est donc une condition préalable de faisabilité ; lorsque vos requêtes sont surtout des textes courts à peu d'étiquettes et qu'une inférence locale de l'ordre de la centaine de millisecondes sans réseau est acceptable, l'embarqué est plus avantageux ; lorsque l'espace d'étiquettes est vaste ou qu'il faut une faible latence et une forte concurrence, la voie CPU embarquée peut ne pas tenir. Critère d'évaluation mesurable : sur vos appareils cibles, à longueur d'entrée fixe, mesurez en charge les latences P50 et P95 de chaque type de décision ainsi que la mémoire maximale (valeur de référence rapportée : RSS 393,1 Mo), et comparez sur la même machine avec la solution existante. Troisième décision : migrer dès maintenant l'activité vers l'API hébergée. L'article indique clairement que cette API est annoncée mais pas encore ouverte : à ce stade, seul l'auto-hébergement est possible ; il est conseillé de valider d'abord à petite échelle avec les poids locaux, puis de vérifier la disponibilité, la limitation de débit et la facturation côté API avant de décider d'un basculement, sans planifier les capacités sur la base du tarif annoncé dans l'article. Pour la démarche d'évaluation, il est conseillé de fixer d'abord une entrée de 1 024 tokens au plus, de construire les candidats selon les modalités du rapport, d'effectuer un test hors ligne de concordance, puis un test de charge sur appareil, et de ne passer en déploiement progressif que si les deux sont satisfaisants.
Limites et points à confirmer
La principale limite de cet article tient aux échantillons et aux modalités de comparaison. Les essais de classification ne portent que sur 100 échantillons chacun ; Typed Decisions en compte 2 000, mais les intervalles de confiance des autres items sont larges et ne suffisent pas à tirer des conclusions fortes ; la base de comparaison utilise les valeurs de référence du protocole Jev et non une réexécution de Jev dans le même environnement, et la latence de Jev a été mesurée via un appel transfrontalier à un service hébergé, ce qui n'est pas comparable à une exécution locale de ce modèle : l'affirmation du fournisseur sur une vitesse cinq fois supérieure doit donc être vérifiée indépendamment. Le pipeline d'entraînement privé du modèle n'est pas public, ce qui empêche de contrôler la composition des données et les biais potentiels. Une reproduction sur CPU du 25 septembre a produit 3 abandons de réponse, signe d'une possible dégradation du comportement en environnement peu puissant. L'API hébergée annoncée dans l'article n'était pas ouverte au moment de la rédaction, et le tarif prévu de 0,025 dollar par million de tokens d'entrée provient d'un article de septembre 2026 : les prix changent, il faut se référer à la page tarifaire du fournisseur. Il faut préciser en particulier que la version Julia 1 n'est pas listée dans le catalogue KimiSeek et que la disponibilité d'API mentionnée dans l'article renvoie aux dispositions du côté fournisseur, sans lien avec la plateforme KimiSeek. En outre, l'article ne donne pas de détails sur la formulation des réponses candidates, la sensibilité à l'ordre ou la stabilité multilingue (MASSIVE ne rapporte qu'une moyenne macro et deux régions linguistiques), autant d'éléments susceptibles d'affecter les performances réelles et que les lecteurs doivent tester eux-mêmes pour confirmer.
Illustrations de l’article original