Underdog publie Saluki 27B : un Qwen3.8-27B 2-bit de 7,89 Go qui dépasse l'original en appels d'outils
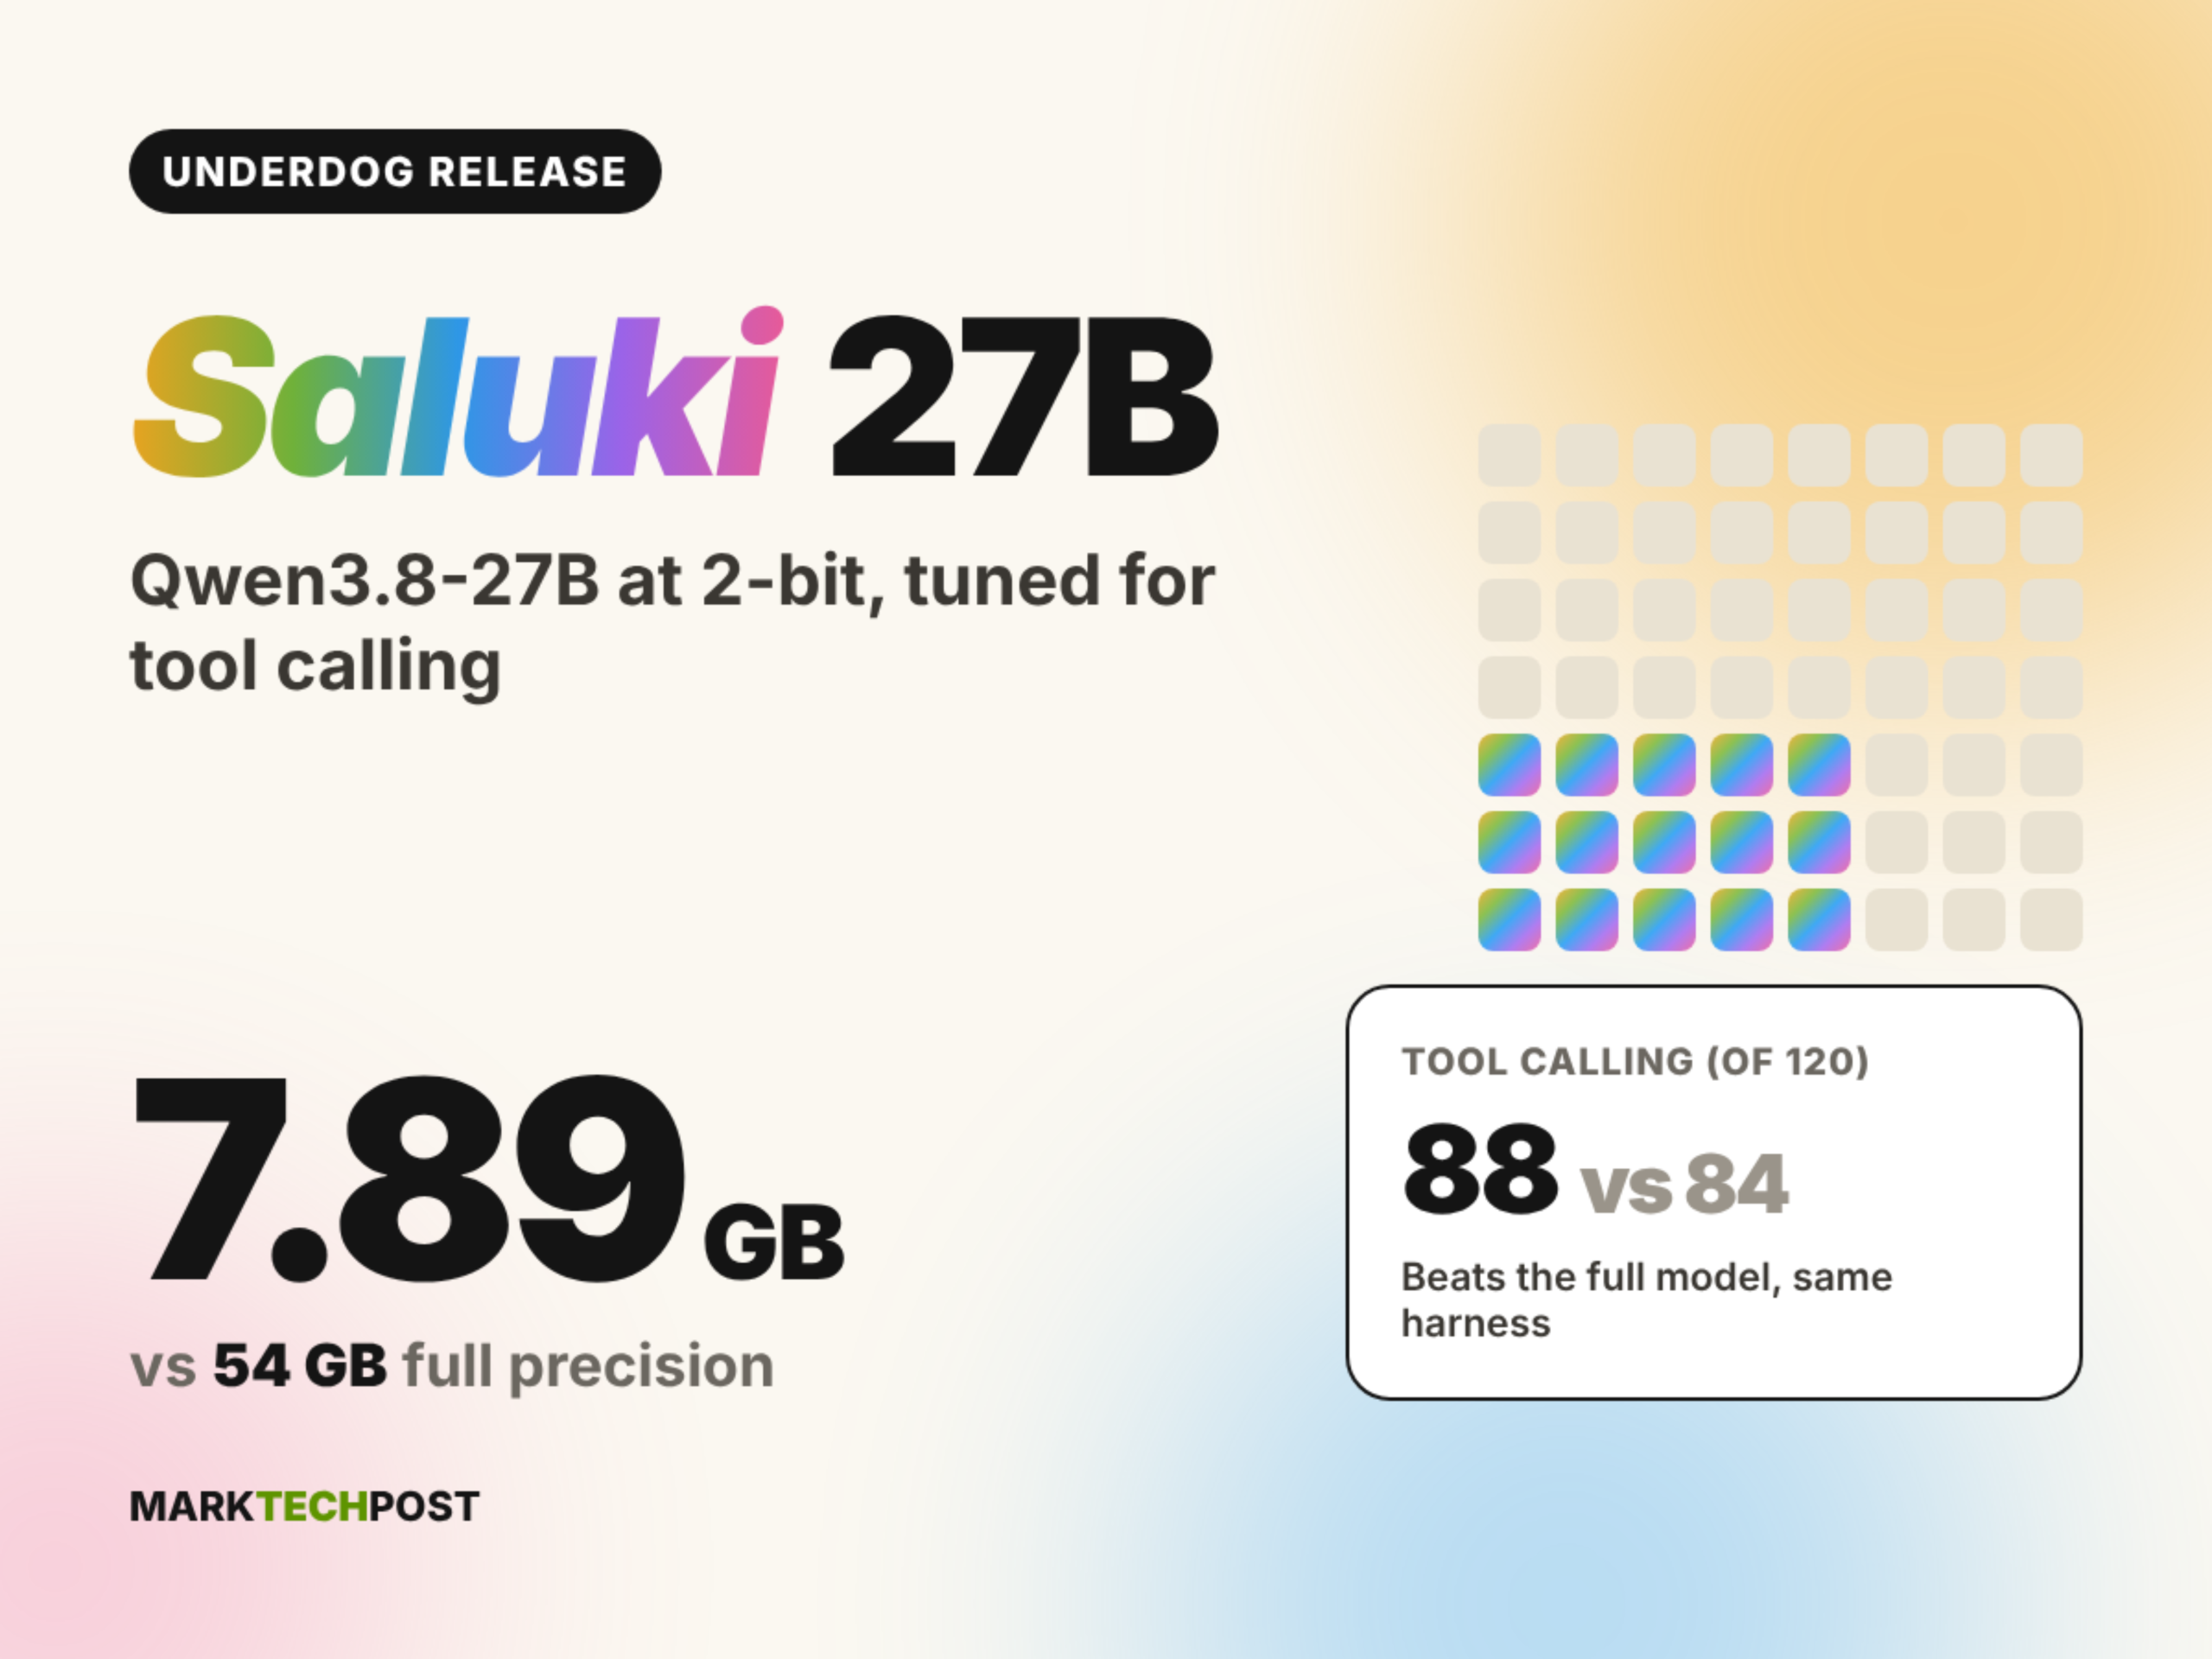
Selon MarkTechPost du 9 octobre 2026, Underdog, projet de Conway Research, publie Saluki 27B sous Apache 2.0, compressant le Qwen3.8-27B de 54 Go en un GGUF mixte 2-bit de 7,89 Go exécutable sur llama.cpp original ; son score d'appels d'outils dépasse l'original, mais les mathématiques de compétition et le raisonnement multi-étapes baissent de 12 à 18 points.
Ce qui change
Selon MarkTechPost du 9 octobre 2026, Underdog, projet d'assistant embarqué de Conway Research, a publié Saluki 27B sous licence Apache 2.0. Ce modèle est une version GGUF en précision mixte 2-bit de Qwen3.8-27B, avec un fichier de 7,89 Go, contre 54 Go pour le modèle BF16 complet. Le rapport indique que sa construction superpose trois couches de travail : la base est le modèle dense 27B de l'équipe Qwen, Qwen3.8-27B (64 couches, attention linéaire Gated DeltaNet hybride et attention à porte, 262 144 tokens natifs) ; au-dessus, le GGUF GSQ-RCO d'ISTA-DASLab, dont le plus petit fichier IQ2_XS fait 8,4 Go, soit 2,50 bits par poids en moyenne ; Underdog applique ensuite sa propre compression et ses optimisations d'appels d'outils, produisant des fichiers nommés IQ2-mix marqués imatrix, mais le rapport note qu'Underdog n'a pas publié la recette complète de cette étape. Sur le plan de l'exécution, le rapport indique que le modèle tourne directement dans llama.cpp original et les applications qui en dérivent, avec support complet du déport GPU, ainsi qu'un module visuel optionnel de 629 Mo ou 928 Mo. Côté benchmarks, le rapport donne deux séries de résultats auto-déclarés par Underdog : dans la comparaison à cadre identique avec le modèle complet, Underdog Bench (120 tâches de BFCL v4, mode réflexion désactivé, température 0) donne 88 pour Saluki contre 84 pour le modèle complet ; appels d'outils parallèles 42 contre 35 ; SWE-bench Verified, 30 problèmes corrigés sur 50 contre 33. Dans la comparaison avec les scores publics pleine taille : IFEval 93,5 contre 91,5, IFBench 72,7 contre 71,0, MBPP+ 78,0 contre 83,9, MuSR 67,5 contre 79,6, AIME 2025 79,2 contre 96,7, AIME 2026 80,0 contre 94,6. Le rapport cite aussi ISTA GSQ-RCO IQ2_XS et PrismML Bonsai 2 27B comme points de comparaison, et souligne que chaque éditeur utilise son propre cadre de test, les scores inter-éditeurs n'étant pas directement comparables ; Bonsai 2 est plus petit mais nécessite la branche llama.cpp de PrismML.
Conséquences pour les développeurs
Pour les développeurs qui ont besoin d'agents locaux, le changement concret de cette annonce est qu'un modèle d'appels d'outils de niveau 27B voit ses poids quantifiés sous 8 Go, sans nécessiter de branche llama.cpp tierce pour le charger. Cela modifie directement l'évaluation du seuil de mémoire vidéo et de déploiement : le déport complet sur un GPU grand public monocarte, voire sur une machine à grande mémoire, devient réaliste, et l'architecture hybride « boucle d'agent locale + modèle distant en secours » devient plus calculable en coût. Mais il faut distinguer les poids ouverts du droit de licence : le rapport indique que le fichier est publié sous Apache 2.0, ce qui relève d'une déclaration de licence, et l'usage commercial doit être vérifié dans la carte du modèle et le texte de la licence ; la disponibilité des poids ne signifie pas en soi l'étendue des droits accordés. Il faut aussi noter que la distribution des capacités est inégale : le rapport indique que les indicateurs d'appels d'outils et de suivi d'instructions sont proches ou légèrement supérieurs à l'original, tandis que les indicateurs de mathématiques et de raisonnement multi-étapes comme AIME et MuSR baissent de 12 à 18 points. Cela signifie que cette version quantifiée convient aux charges d'orchestration d'outils, de sélection de fonctions et de contraintes de format, mais pas comme moteur de raisonnement principal. De plus, tous les scores proviennent d'Underdog ou des auto-tests d'éditeurs qu'il cite, avec des cadres de test différents selon les éditeurs : ce sont des déclarations rapportées, non des reproductions indépendantes, et les classements inter-modèles doivent être considérés comme non comparables. Le rapport ne publie pas le nombre de bits par poids, la longueur de contexte ni la recette de compression, ces inconnues affectant les performances réelles en contexte long et en concurrence par lots.
Intégration et évaluation
Recommandation 1 (routage des appels d'outils) : utiliser ou non Saluki 27B comme couche de sélection de fonctions et de génération de paramètres pour un agent local dépend de si votre charge repose principalement sur des appels d'outils parallèles et des sorties structurées. Si votre scénario est un appel unique ou peu de parallélisme, avec un format de réponse strict, le rapport indique que ses indicateurs d'appels parallèles et de suivi d'instructions approchent ou dépassent l'original, et vous pouvez le privilégier en local ; si votre charge dépend d'une planification multi-étapes à longue chaîne, le rapport indique une baisse nette de MuSR et AIME, et il faut conserver l'original ou un modèle plus fort en secours. Critère d'évaluation mesurable : exécuter le même lot de tâches gelées sur votre propre schéma d'outils, comparer le taux d'exactitude de sélection des noms d'outils et le taux de validité JSON des paramètres entre Saluki et l'original (ou le modèle en ligne actuel), ainsi que le taux d'achèvement des tâches en appels parallèles. Recommandation 2 (choix de la méthode de compression) : choisir parmi des candidats en 2-bit dépend de votre volonté de maintenir un runtime non original. Le rapport indique que Saluki tourne sur llama.cpp original, tandis que PrismML Bonsai 2 nécessite sa branche llama.cpp, ce qui affecte directement la complexité de build, de mise à niveau et de CI ; le rapport indique aussi que Saluki ne publie pas les bits par poids ni le contexte, alors que la solution de comparaison publie 2,50 bits par poids et la taille du fichier. Si votre équipe ne veut pas bifurquer sur le cadre d'inférence, vous pouvez poser « chargeable par llama.cpp original » comme prérequis strict, puis comparer taille et précision ; si la taille est la contrainte première, il faut accepter le coût de maintenance de la branche. Critère mesurable : sur la même machine cible, enregistrer la latence du premier token, le pic de mémoire vidéo et la stabilité en contexte long (proche de votre longueur d'entrée maximale réelle), et vérifier la version de llama.cpp requise pour charger le fichier. Recommandation 3 (acceptation après quantification) : quel que soit le choix, prendre comme seuil de mise en production la capacité à accomplir des tâches de bout en bout après quantification, plutôt que les scores de benchmark. Critère mesurable : sur un échantillon de votre trafic réel en ligne, comparer le nombre de tâches de correction réussies, le nombre de tours d'appels d'outils et le taux de nouvelles tentatives en échec, et fixer un seuil de repli explicite, par exemple un repli automatique lorsque le taux de réussite de bout en bout tombe sous une proportion acceptable de celui de l'original. Ce qui précède est une analyse et des recommandations conditionnelles, non des faits rapportés dans la source.
Limites et points à confirmer
Il faut d'abord préciser : le Saluki 27B du rapport (version dérivée GGUF 2-bit de Qwen3.8-27B) n'apparaît pas actuellement dans le catalogue de modèles de KimiSeek ; la distribution décrite consiste à obtenir les poids GGUF sur Hugging Face et autres canaux et à les exécuter localement dans llama.cpp original, sans lien avec une disponibilité API sur la plateforme KimiSeek, toute mention de disponibilité API renvoyant aux canaux propres de l'éditeur. Ensuite, tous les chiffres de benchmark cités proviennent des auto-tests d'Underdog et des scores publics qu'il cite : ce sont des déclarations de l'éditeur, non reproduites indépendamment ici ; le rapport lui-même rappelle que chaque éditeur utilise son propre cadre de test et que les scores inter-éditeurs ne sont pas directement comparables. Troisièmement, le rapport ne publie pas le nombre de bits par poids du fichier, la longueur de contexte ni la recette complète de la troisième couche de compression ; les performances en contexte long, en concurrence par lots et sur différents matériels restent donc inconnues. Quatrièmement, la publication des poids sous Apache 2.0 est une déclaration de licence issue du rapport ; le respect de conditions commerciales précises doit être vérifié dans la carte du modèle et le texte de la licence, la disponibilité des poids n'équivalant pas à une étendue de droits claire. Enfin, les caractéristiques de la base Qwen3.8-27B (64 couches, attention hybride, contexte natif de 262 144) proviennent également de ce rapport et n'ont pas été vérifiées ici.