Aleph Alpha、オープンウェイトのKolibriを公開:781億パラメータMoE、トークンあたり34.6億のみ活性化
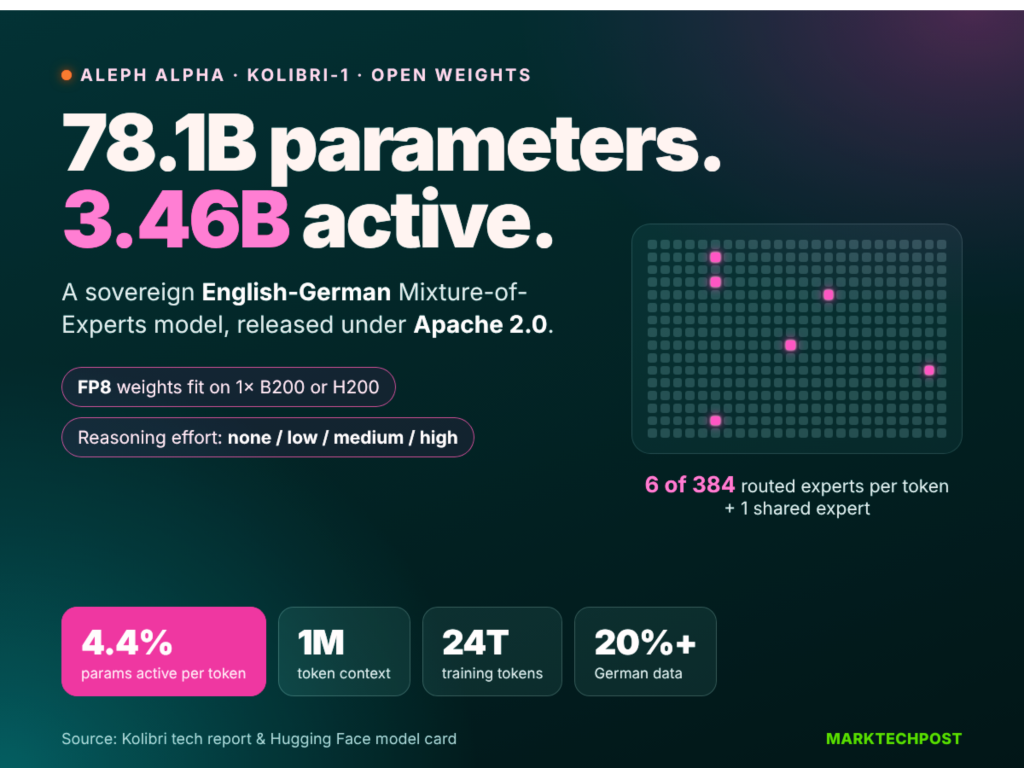
MarkTechPostの2026年10月4日の報道によると、Aleph Alphaは英独二言語のオープンウェイトMoEモデルKolibri-1を公開した。総パラメータは781億、トークンあたりの活性化は34.6億のみで、最大1,048,576トークンのコンテキストと4段階の推論強度をサポートし、Apache 2.0ライセンスでHugging Faceに公開され、FP8チェックポイントは約78GBで、vLLMにより単一のB200またはH200上でサービス提供できる。
主な変更
MarkTechPostの2026年10月4日の報道によると、ドイツのチームAleph AlphaはオープンウェイトモデルKolibri(Kolibri-1)を公開した。英語とドイツ語の二言語混合エキスパート(MoE)言語モデルと位置づけられ、公共管理、産業、航空宇宙などの規制対象領域における主権的デプロイを目標としている。報道によれば総パラメータ数は781億、各トークンで活性化されるのは34.6億のみ(約4.4%)。各MoE層ではsigmoidルーターが384個のルーティングエキスパートからtop 6を選び、さらに1個の共有エキスパートを加える。負荷分散にはExact Quantile BalancingとLoad-Error Injectionを採用する。モデルは50個のTransformerブロックを積層し、幅は2560、グループ化クエリアテンションは48個のクエリヘッドと4個のKVヘッドを持つ。5ブロックごとに位置エンコーディングなしの全注意で、残りの40ブロックは先頭512トークンをカバーするスライディングウィンドウ注意とRoPEを組み合わせるため、KVキャッシュがコンテキストとともに増大するのは10層のみである。コンテキスト上限は1,048,576トークンと報じられ、推論強度はリクエストごとに無、低、中、高に設定できる。訓練面では、事前訓練は768枚のNVIDIA B200上で20Tトークンをカバーし、中期訓練は3.44Tトークン(系列長65,536)、長コンテキスト段階は201Bトークン(系列長262,144)で、さらに2T超のドイツ語トークンを追加したと報じられている。事後訓練は教師あり微調整と、120万件超の内部タスクでの強化学習を組み合わせる。ライセンスはApache 2.0で、重みはHugging Faceに公開されている。FP8チェックポイントは約78GBで、単一のB200、B300、H200、または2枚のH100 SXM5で、専用推論パーサーとツール呼び出しパーサーを備えたvLLMによりサービス提供できる。報道のベンチマーク比較では英語総合75.5、ドイツ語総合70.8、BFCL v4は61.4で比較対象のQwen3.5を下回った。これらのパラメータ、ベンチマーク、デプロイの詳細はすべて元報道と技術報告の伝聞であり、独立した再現はまだ行われていない。
開発者への影響
開発者の視点では、このニュースの価値は3点に集約される。第1はライセンスとセルフホストの組み合わせである。報道では重みがApache 2.0ライセンスで公開されるとされ、これは「オープンウェイトだが商用利用を制限」という一般的な手法よりも明確な許諾範囲を与えるが、ライセンス条項はHugging Faceのモデルカードとリポジトリのライセンス原文で確認すべきで、報道の伝聞だけで権利を推定してはならない。同時に、重みが利用可能であることが、訓練データ、トークナイザ、推論パッケージも同じライセンスに拘束されることを意味しない点に注意が必要である。第2はスパース性がもたらすコスト構造である。781億の総パラメータ、34.6億の活性化は、メモリ使用量は総パラメータで、計算コストは活性化パラメータで計上されることを意味する。報道によればFP8チェックポイントは約78GBで単一のB200/H200上で動作し、これは単一カードの大容量メモリノードを既に持つチームにとって実行可能なセルフホストの出発点となるが、実際のスループットと同時実行数は依然としてメモリ帯域幅、KVキャッシュ精度、バッチサイズに依存し、自己検証が必要である。第3はハイブリッド注意と百万コンテキストである。スライディングウィンドウ層は固定のKVキャッシュを保ち、コンテキストとともに増大するのは10層のみで、チームは同一計算量でサポートできる系列長が全注意方式の4倍としている。もし事実なら、長文書や産業用RAGのコンテキスト経済性は同規模の稠密モデルより明らかに優れるだろう。しかしこれはベンダーの主張であり、上限の数字だけでなく自身の文書分布で有効コンテキストを検証する必要がある。さらに、英独二言語の位置づけとドイツ語向けに最適化されたトークナイザ(報道ではドイツ語は1トークンあたり4.90バイトで、比較対象のトークナイザより約11.2%トークン使用が少ない)は、その強みがドイツ語圏にあることを示す。中国語中心の業務はこれに基づいて中国語能力を推定すべきではなく、報道には中国語評価が示されていない。明確にすべきは、今回のカタログ確認時点で、Kolibri-1というバージョンはKimiSeekのリアルタイムモデルカタログに存在しない。したがって報道中の重みと推論サービスの可用性はAleph AlphaおよびHugging Face側のリリースを指し、本サイトで既に提供されているわけではない。
導入と評価の提案
以下は提案と条件付き分析であり、実証された事実ではない。提案1:まずライセンスとコンプライアンスの前提で判断し、その後性能で判断する。実際の選択は、Hugging FaceリポジトリのLICENSEファイル、モデルカードの用途制限、aleph-alpha-inference推論パッケージ自体のライセンスを確認した上で、本番依存に含めるかを決めることである。ワークロードが規制対象データのローカル処理を伴い、チームが単一のB200/H200級メモリノードを持つ場合、セルフホストは外部API呼び出しより価値がある。この前提を満たさない場合(例えばコンシューマ級または複数の中小メモリカードのみ)、定量基準で断念すべきである。目標ハードウェアでFP8チェックポイントを正常にロードし安定出力することを合格基準とし、ロード失敗または予算を超えるメモリ拡張が必要なら次のラウンドに進めない。提案2:切り替えや導入前に、自社のドイツ語または英独混合コーパスで既存モデルとの対照評価を行う。選択可能な主要変数は推論強度の段階(無/低/中/高)とKVキャッシュ精度で、これは単一リクエストのコストと遅延を直接変える。タスクが長文書抽出で、回答遅延の許容度が高い場合は推論強度を上げることで品質向上が期待できる。高同時実行の短い問答の場合は、低強度と長いバッチ処理の組み合わせが有利である。評価基準は測定可能にする。固定の200〜500件のドイツ語長文書問答セットで各段階の精度と1,000トークンあたりのエンドツーエンド遅延を比較し、精度向上が遅延とコスト増を上回る場合にのみ高い段階を採用する。提案3:長コンテキスト能力は上限ではなく「有効ウィンドウ」で検証する必要がある。実際の選択は、まずデフォルトの262,144コンテキストで稼働させ、その後max-model-lenを設定しmax_position_embeddingsを上書きして段階的に大きなウィンドウに広げる。前提は、タスクが本当に百万トークンにまたがる連続依存を必要とすることである。検索結果がそもそも10万トークン未満なら、上限を広げるだけKVキャッシュコストが上がる。定量基準は、長さ勾配(例:32k、128k、512k)で重要情報の再現率を測定し、ある長さで明らかな低下があれば、その長さ以下を実質的な上限として使うことである。提案4:ツール呼び出しとエージェントのシナリオは個別に負荷試験すべきである。報道ではBFCL v4のスコアが比較対象のQwenモデルより低く、エージェント平均スコアは相手に近いとされ、エージェントのサブタスクによって差が大きい可能性を示す。実際の選択は、既存モデルをツール呼び出しの主経路として維持しKolibriをドイツ語の検索と生成に使う、またはその逆とする。前提は、チームが回帰可能なツール呼び出しテストセットを既に持つことである。定量基準は、自社のツールスキーマでの呼び出し成功率とパラメータ正確率で、現用モデルより著しく低ければ主経路を移行しない。
制限と未確認事項
まず明確にすべきは、今回のカタログ確認時点でKolibri-1はKimiSeekのリアルタイムモデルカタログに存在しない。本文に述べた重み、推論パッケージ、デプロイ方式はAleph AlphaおよびHugging Faceのリリースを指し、本サイトが同モデルを提供していることを意味しない。報道中のAPI可用性の表現もベンダー側のみを対象とし、本サイトのサービスと解釈すべきではない。次に、本文のアーキテクチャ、訓練、ベンチマーク、デプロイの数値はすべてMarkTechPostの2026年10月4日の報道と、それが伝えた技術報告およびモデルカードに由来し、独立した再現は行われていない。ベンチマーク比較はベンダー独自の評価設定であり、モデル間の横比較の比較可能性は限定的で、選定の唯一の根拠にすべきではない。第3に、報道は中国語、コード、長コンテキストのシナリオに関する独立検証の詳細を示しておらず、英独二言語の位置づけ以外の言語能力は不明である。「同一計算量で4倍の系列長」という主張はチームの声明であり、自身で検証する必要がある。第4に、Apache 2.0は公開された重みに対するライセンス宣言であり、具体的な適用範囲(重み、トークナイザ、推論パッケージ、訓練データ)は原文のライセンスとモデルカードで項目ごとに確認すべきで、「オープンウェイト」から全コンポーネントの許諾範囲を直接導出してはならない。第5に、単一カードで動作することと本番利用可能であることは別であり、ピーク同時実行数、メモリ余裕、推論強度段階のコストへの影響は目標ハードウェアで実測する必要がある。第6に、報道中の価格、上限、推奨サンプリングパラメータはすべて発表時点の情報であり、後続バージョンで変わりうるため、ベンダーおよびHugging Faceページの最新内容を基準とすべきである。