Deep Principle、科学向け753BモデルHydrogen-1.0の重みを公開 8GPUのSGLangで提供可能
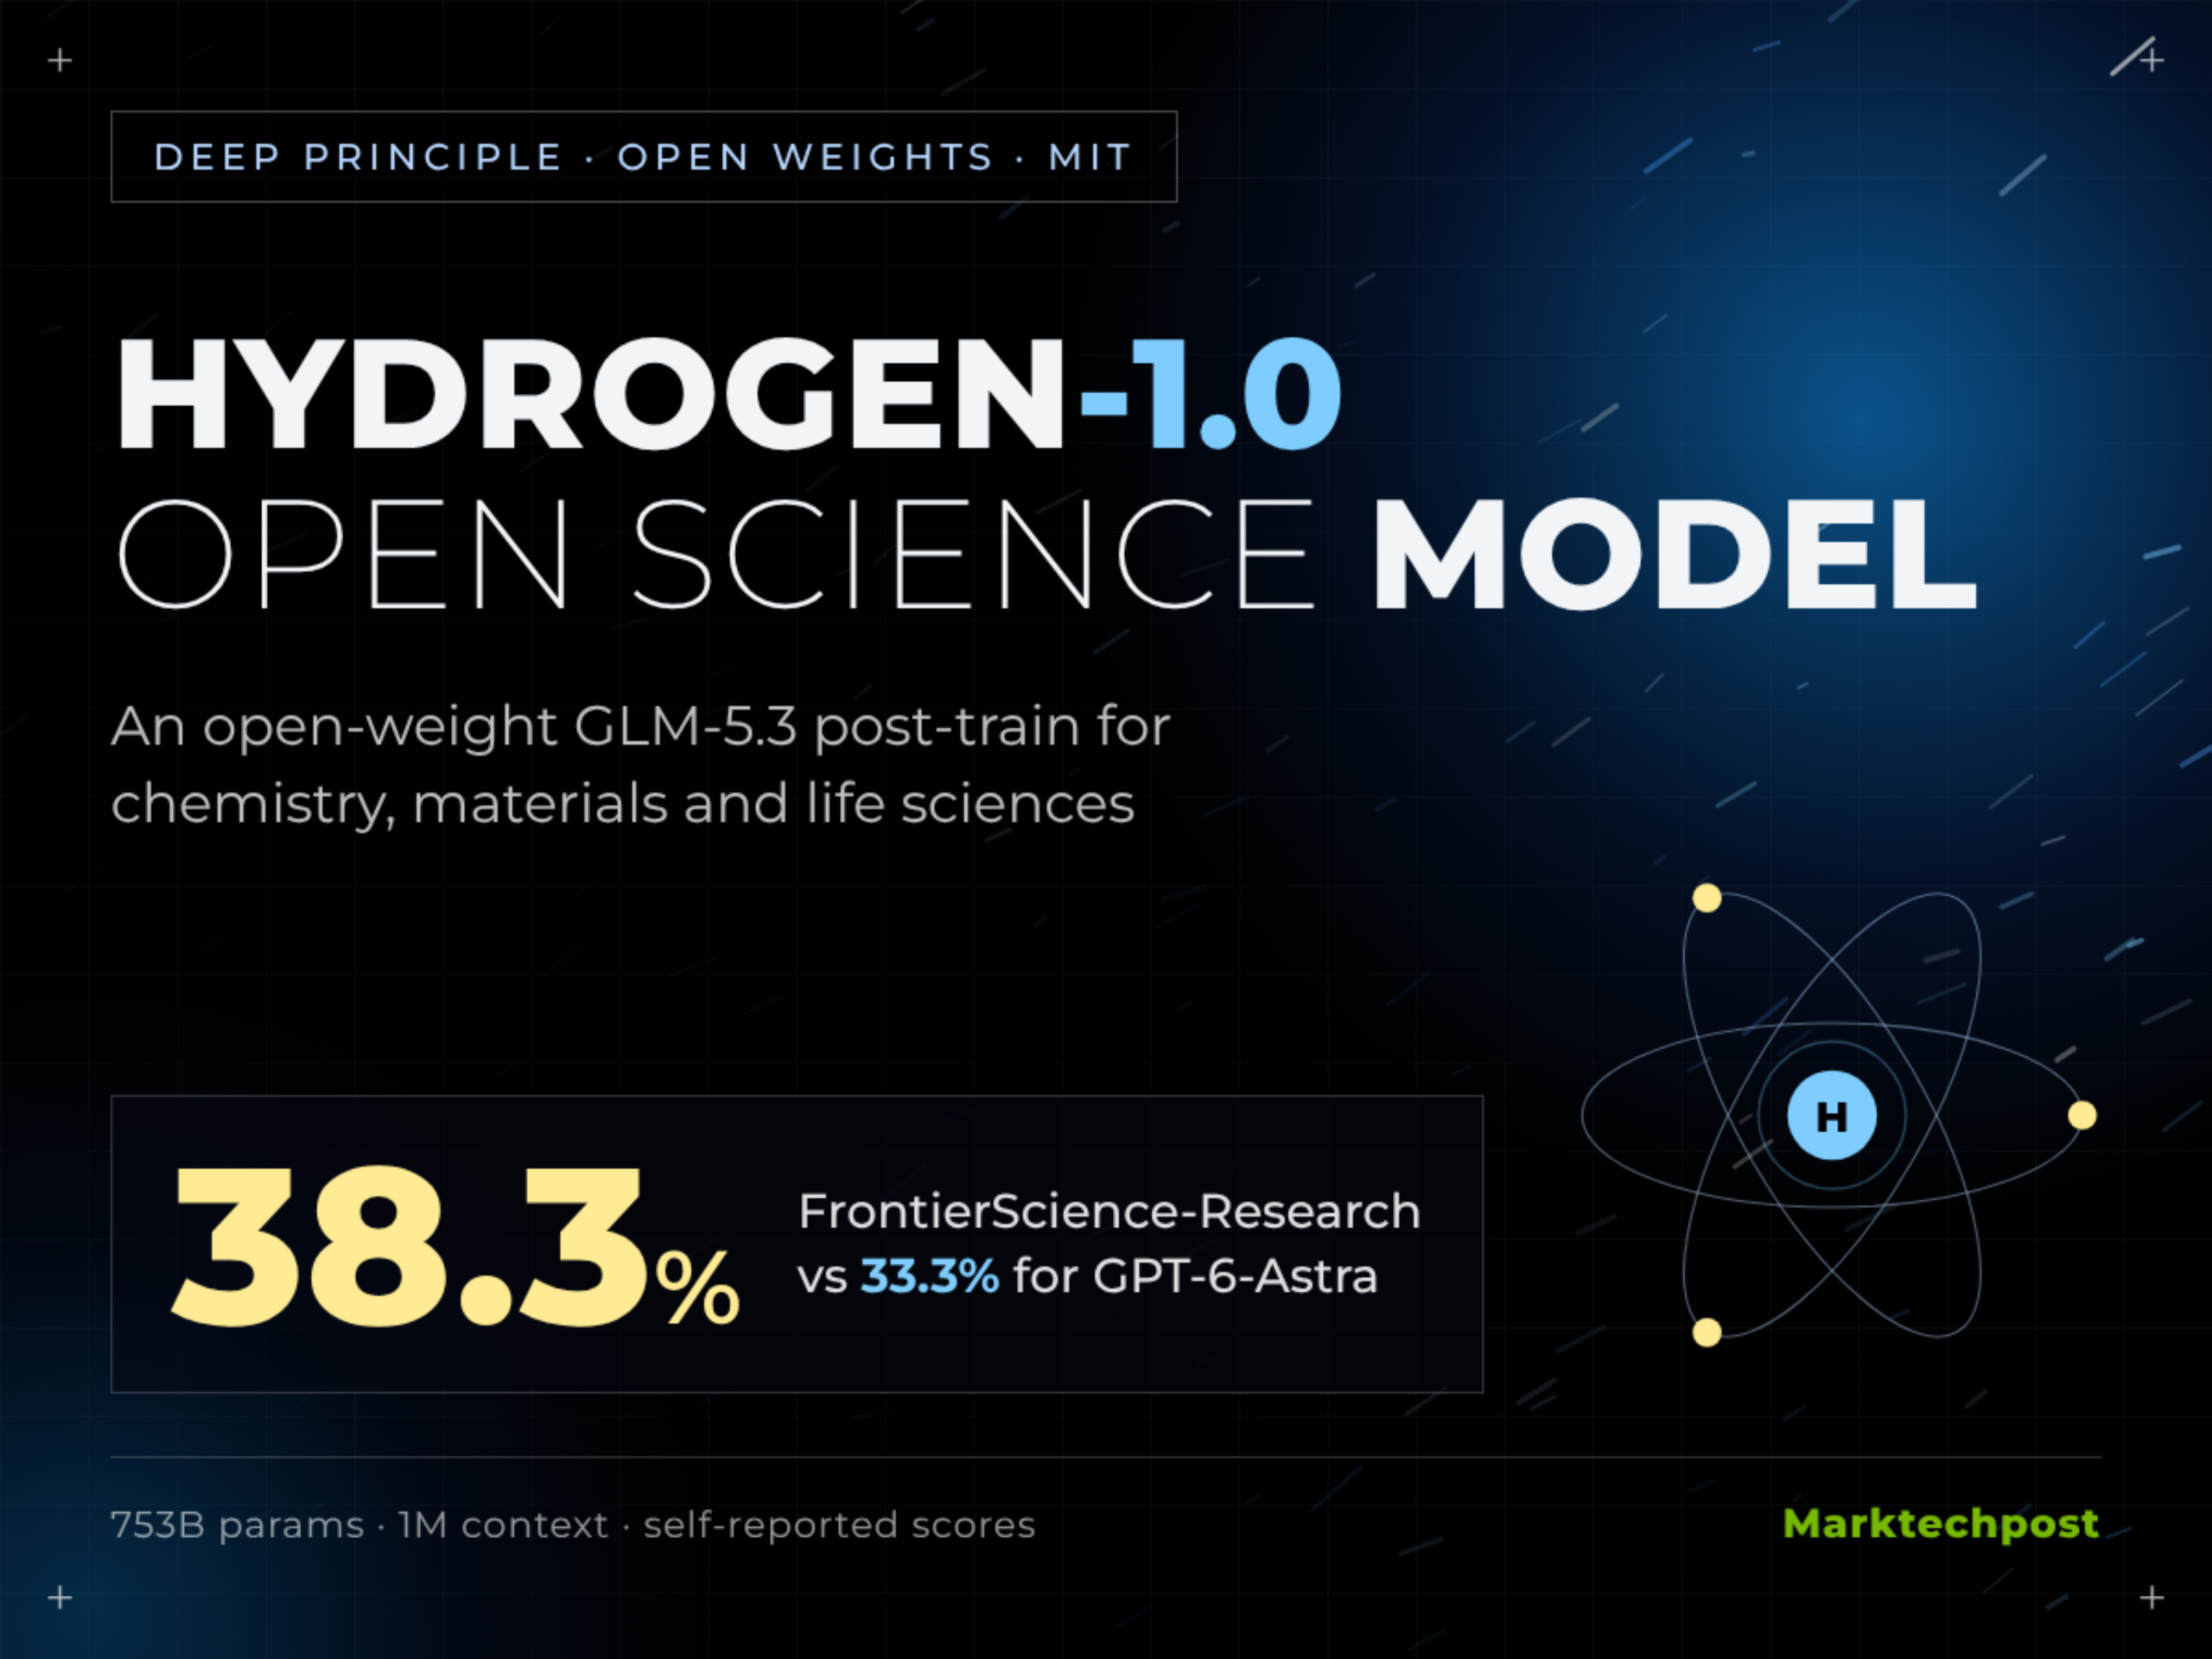
MarkTechPostの2026年11月2日の報道によると、杭州のDeep PrincipleはGLM-5.3から事後訓練したHydrogen-1.0を発表した。総パラメータ数753B、コンテキスト1M。重みはMITライセンスで公開されたと報じられている。自己評価のFrontierScience-Researchは38.3%でGPT-6-Astraの33.3%を上回る一方、NMR構造解析は3.33ポイント劣る。
主な変更
MarkTechPostの2026年11月2日の報道によると、杭州に拠点を置くAI for Materials企業のDeep PrincipleがHydrogen-1.0を発表し、重みはHugging FaceとModelScopeにアップロード済みで、MITライセンスで公開されたと報じられている。モデルカードではZ.aiのGLM-5.3派生モデルと説明され、問題設定、実験計画、結果分析、オープンエンドな発見を用途とする。チームは、これまで非公開だったプロプライエタリな科学モデルに対する再現可能で監査可能な代替だと主張している。 仕様は、総パラメータ753B、約40BアクティブのMoE(アクティブ規模はGLM-5.3のベースから継承)、1Mトークンのコンテキスト、最大128Kの出力、テキスト専用モダリティ。学習は教師あり微調整と強化学習を組み合わせ、データは4種類。化学・材料・生命科学の領域知識、Deep Principleの科学者によるタスクフィードバック、Mira経由で収集した全サイクルの電子実験記録、失敗した試行を含む選択とフィードバックの系列である。基盤はMegatronとSGLangで、NVIDIA CUDAとAMD ROCmをカバーする。学習チェックポイントはレイアウトアダプターでBF16と128×128ブロックFP8の推論重みに変換される。完全なデータセットと学習レシピは非公開だと明記されている。 ベンチマークはすべてベンダー自己評価である。FrontierScience-ResearchでHydrogen-1.0は38.3%、報道ではGPT-6-Astraが33.3%。GPQA-Diamondの93.0%は創業者のツイートスレッドによる。「GLM-5.3を上回り、Kimi-K3とほぼ同等」というのはブログの主張で、報道の比較表では両者の同項目のスコアは未開示と注記されている。表中のGPT-6-Astraの96.0%はOpenAIの報告と注記される。内部研究タスク評価は最大思考モードのGPT-6-Astraを参照し、科学計算が5.13ポイント、順方向反応予測が4.76ポイント上回り、NMR構造解析は3.33ポイント劣る。遷移金属錯体設計タスクでは、モデルは5ラウンド以内でより大きなHOMO-LUMOギャップを追い、第5ラウンドの平均ベストは4.318 eV。報道はGPT-6-Astra 3.689 eV、Kimi-K3 3.353 eVを挙げる。117問の実験計画ではHydrogen-1.0はKimi-K3より高得点で、GPT-6-AstraとOpus-5.5はリクエストの半数超を拒否したため当該比較から除外された。 デモは4つ。ポリエチレン融液をPythonで構築してGROMACSを実行し、トポロジーエラーを見つけて修正し、修正後の40 nsトラジェクトリを解析した。30個の妥当な反応で27構造を含むIreland-Claisen反応ネットワークに拡張した。1H NMRスペクトルから2-ブロモナフタレンの7つの候補モノホルミル化生成物を順位付けした。12本のバイアルで行うSuzukiカップリング研究のJSONプロトコルを作成した。仮想実験室のコンパイル手順は、実行前にピペットチップを交換せずに行う吸引操作を一度阻止した。 デプロイ側では、チームはSGLangで8基のGPU、テンソル並列度8のBF16サービスを検証済み。ほかにNVIDIA B200/B300向けNVFP4版、AMD Instinct MI350X/MI355X向けMXFP4版があり、サーバーはOpenAI互換インターフェースとreasoning_effort設定を備える。報道はHydrogen-1.0のAPI価格もホスト型サービスも明らかにしていない。
開発者への影響
開発者にとって最初の壁はハードウェアであり、接続ではない。総パラメータ753B、約40Bアクティブは自社構築の推論が8基のGPU規模のエンジニアリングであることを意味し、報道で試験済みなのはBF16、TP=8の1構成だけだ。より少ないGPUに規模を抑えたい場合、頼れるのはNVFP4かMXFP4のチェックポイントだけで、それぞれBlackwell(B200/B300)とMI350X/MI355Xに固定される。H100/H200やMI300を持つチーム向けの経路は報道にない。これはコンテナをすぐ立ち上げる選択肢というより、「資源があれば自前で運用できる」選択肢だ。1Mコンテキストでは特にそうで、prefill時間とVRAM使用量は長いリクエストごとに測る必要があり、短いプロンプトのスループットから外挿できない。 インターフェースの形は移行コストを下げる。SGLangサーバーはOpenAI互換インターフェースを公開するため、既存のクライアントやプロンプト編成層の多くは直接接続できる。reasoning_effortは思考予算をリクエストパラメータにするが、報道は値域、既定値、出力トークンとの対応を説明していない。自社ゲートウェイで先に確認しないと、本番の遅延が既定の設定に応じて変動する。 ライセンスは二つを分けて考える必要がある。報道で公開されたとされる重みはMITライセンスで、これは「重みだけの公開」より緩やかな条件だ。しかし同じ報道の比較表では、ベースのGLM-5.3は別のGLM-5.3ライセンスと記されている。独自ライセンスのベースから事後訓練したモデルを、派生側がMITで再配布できるかは、ライセンス原文とモデルカードを直接読む必要があり、「重みがダウンロードできる」ことから推測してはいけない。データセットと学習レシピは非公開で、チームの言う再現可能・監査可能は現時点で重みの層に限られ、実験記録や発見の軌跡は公開範囲外だ。 能力の全体像には非対称がある。報道自身が、モデルはNMR構造解析でGPT-6-Astraに3.33ポイント劣ると認めており、これは内部研究タスク上の一比較だ。同じ報道には、1H NMRスペクトルから7つの候補モノホルミル化生成物を順位付けするデモもある。両者は別のタスクで、前者は報道が指摘した短所、後者はあくまでデモだ。自社業務がこの短所に当たるかは、解析系タスクがリクエストに占める割合で決まり、チケットに含まれるデモの数で代用できない。 方法論上の細部も留意に値する。実験計画の項目では、2つの相手が拒否率50%超で除外された。つまり比較はモデルが回答することを選んだリクエストだけで行われている。本番プロンプトが境界曖昧だったりセンシティブな情報を扱ったりするなら、拒否率を精度と一緒に評価表へ入れるべきだ。そうしないと、より正確なモデルではなく、より多くの依頼を引き受けるモデルを選んでしまう可能性がある。
導入と評価の提案
以下は報道に基づく条件付き分析であり、検証済みの事実ではない。 判断1:精度版はBF16かFP4か。報道が示す変化は、同一モデルに3つの推論経路があることだ。試験済みのBF16(8基のGPU、TP=8)、B200/B300向けNVFP4、MI350X/MI355X向けMXFP4である。すべきことは「新しい形式のほうが速い」と即断してFP4を選ばず、受け入れ試験が必要な代替品として扱うことだ。判断のトリガーはまずアクセラレータ世代で、対応するハードウェアにしかFP4チェックポイントはなく、他のマシンはBF16に戻るしかない。次にBF16を載せられるVRAMの余裕があるか。試験可能な判断基準は、自社で用意した問題群(例えばスペクトル生成物の順位付け、順方向反応予測)をBF16とFP4で走らせ、top-1一致率と1リクエスト当たりの出力遅延を比べること。一致率の低下が業務閾値を超え、BF16も動くならBF16に残す。 判断2:全体を置き換えるか、タスク別にルーティングするか。報道の変化点は、Hydrogen-1.0がGLM-5.3の上で科学向け事後訓練を行ったこと、報道がベースGLM-5.3の重点をコーディングとエージェントと書いていることだ。すべきことはモデルを丸ごと交換せず、リクエスト種別で振り分けること。化学・材料・生命科学の推論と実験計画はHydrogen-1.0へ、汎用コーディングとツール編成はベースか他モデルに残す。前提は2種類の流量を分けて集計できる十分なリクエスト量で、なければルーティングは運用面を増やすだけだ。判断基準はタスク種別ごとのホールドアウトを用意し、通過率と成功タスク当たりの実コストを記録すること。科学系タスクの改善が、もう1セットのデプロイを維持するコストを覆う場合にだけ分流する。 判断3:reasoning_effortの既定値。報道はサーバーがこの設定を公開していること、GPT-6-Astraとの比較が最大思考モードで行われたことを確認している。すべきことは相手の設定をそのまま移さず、自分でパラメータを振って曲線を取ること。前提はリクエストごとの出力トークンとエンドツーエンド遅延を記録できること。判断基準は精度対出力トークンの曲線で、限界便益が明らかに平坦になる屈曲点を既定値にし、遅延に敏感なオンラインAPIには低い段階を別に設定する。 付随する評価手順は、報道が自ら述べる強み・弱みの順に並べられる。まず自社データでNMR構造解析の短所を再現し、誤りの型が報道の劣る方向と一致するか見る。次に、より大きなギャップを多ラウンドで追う反復最適化など、主張された強みを再現し、第5ラウンドの収束傾向が報道の数値の流れに近いか見る。最後に拒否率と形式遵守率を集計する。報道では2つの相手がまさに拒否率で篩い落とされているからだ。
制限と未確認事項
Hydrogen-1.0は現在KimiSeekのモデルカタログになく、本サイトは同モデルを掲載しておらず、呼び出し口も提供していない。報道の重みダウンロード先とOpenAI互換インターフェースは、いずれもベンダー側が自ら構築したデプロイを指す。ホスト型の可用性、価格、レート制限はDeep Principleまたは実際のホスト事業者による。本サイトのカタログにあるGLM-5.3はベースであり、両者は同一モデルではない。 報道のベンチマークはすべてDeep Principleの自己評価で、FrontierScience-Researchと内部タスク評価の第三者再現については報道は触れていない。GPT-6-Astraの33.3%はDeep Principleの数字を引用したもの、GPQA-Diamondの93.0%は創業者のツイートスレッドによる。また「GLM-5.3を上回り、Kimi-K3とほぼ同等」は報道の表に対応する数値の裏付けがない。データセットと学習レシピは非公開で、MITライセンスは報道によれば公開された重みのみを対象とし、ベースは比較表で別のライセンスを使う。派生重みをMITで再配布できるかはライセンスファイルを直接確認する必要がある。4つのデモはワークフローが動くことを示すだけで、精度や安全性の検証にはならない。報道は同モデルのAPI価格やホスト型サービスを明らかにしていない。今後ホスト事業者が現れた場合、価格と割当はその料金ページを確認すべきだ。