EmbeddingGemma 2 のオープンウェイト公開:7.4億パラメータで768次元空間を共有、コードと音声検索が新たな変数に
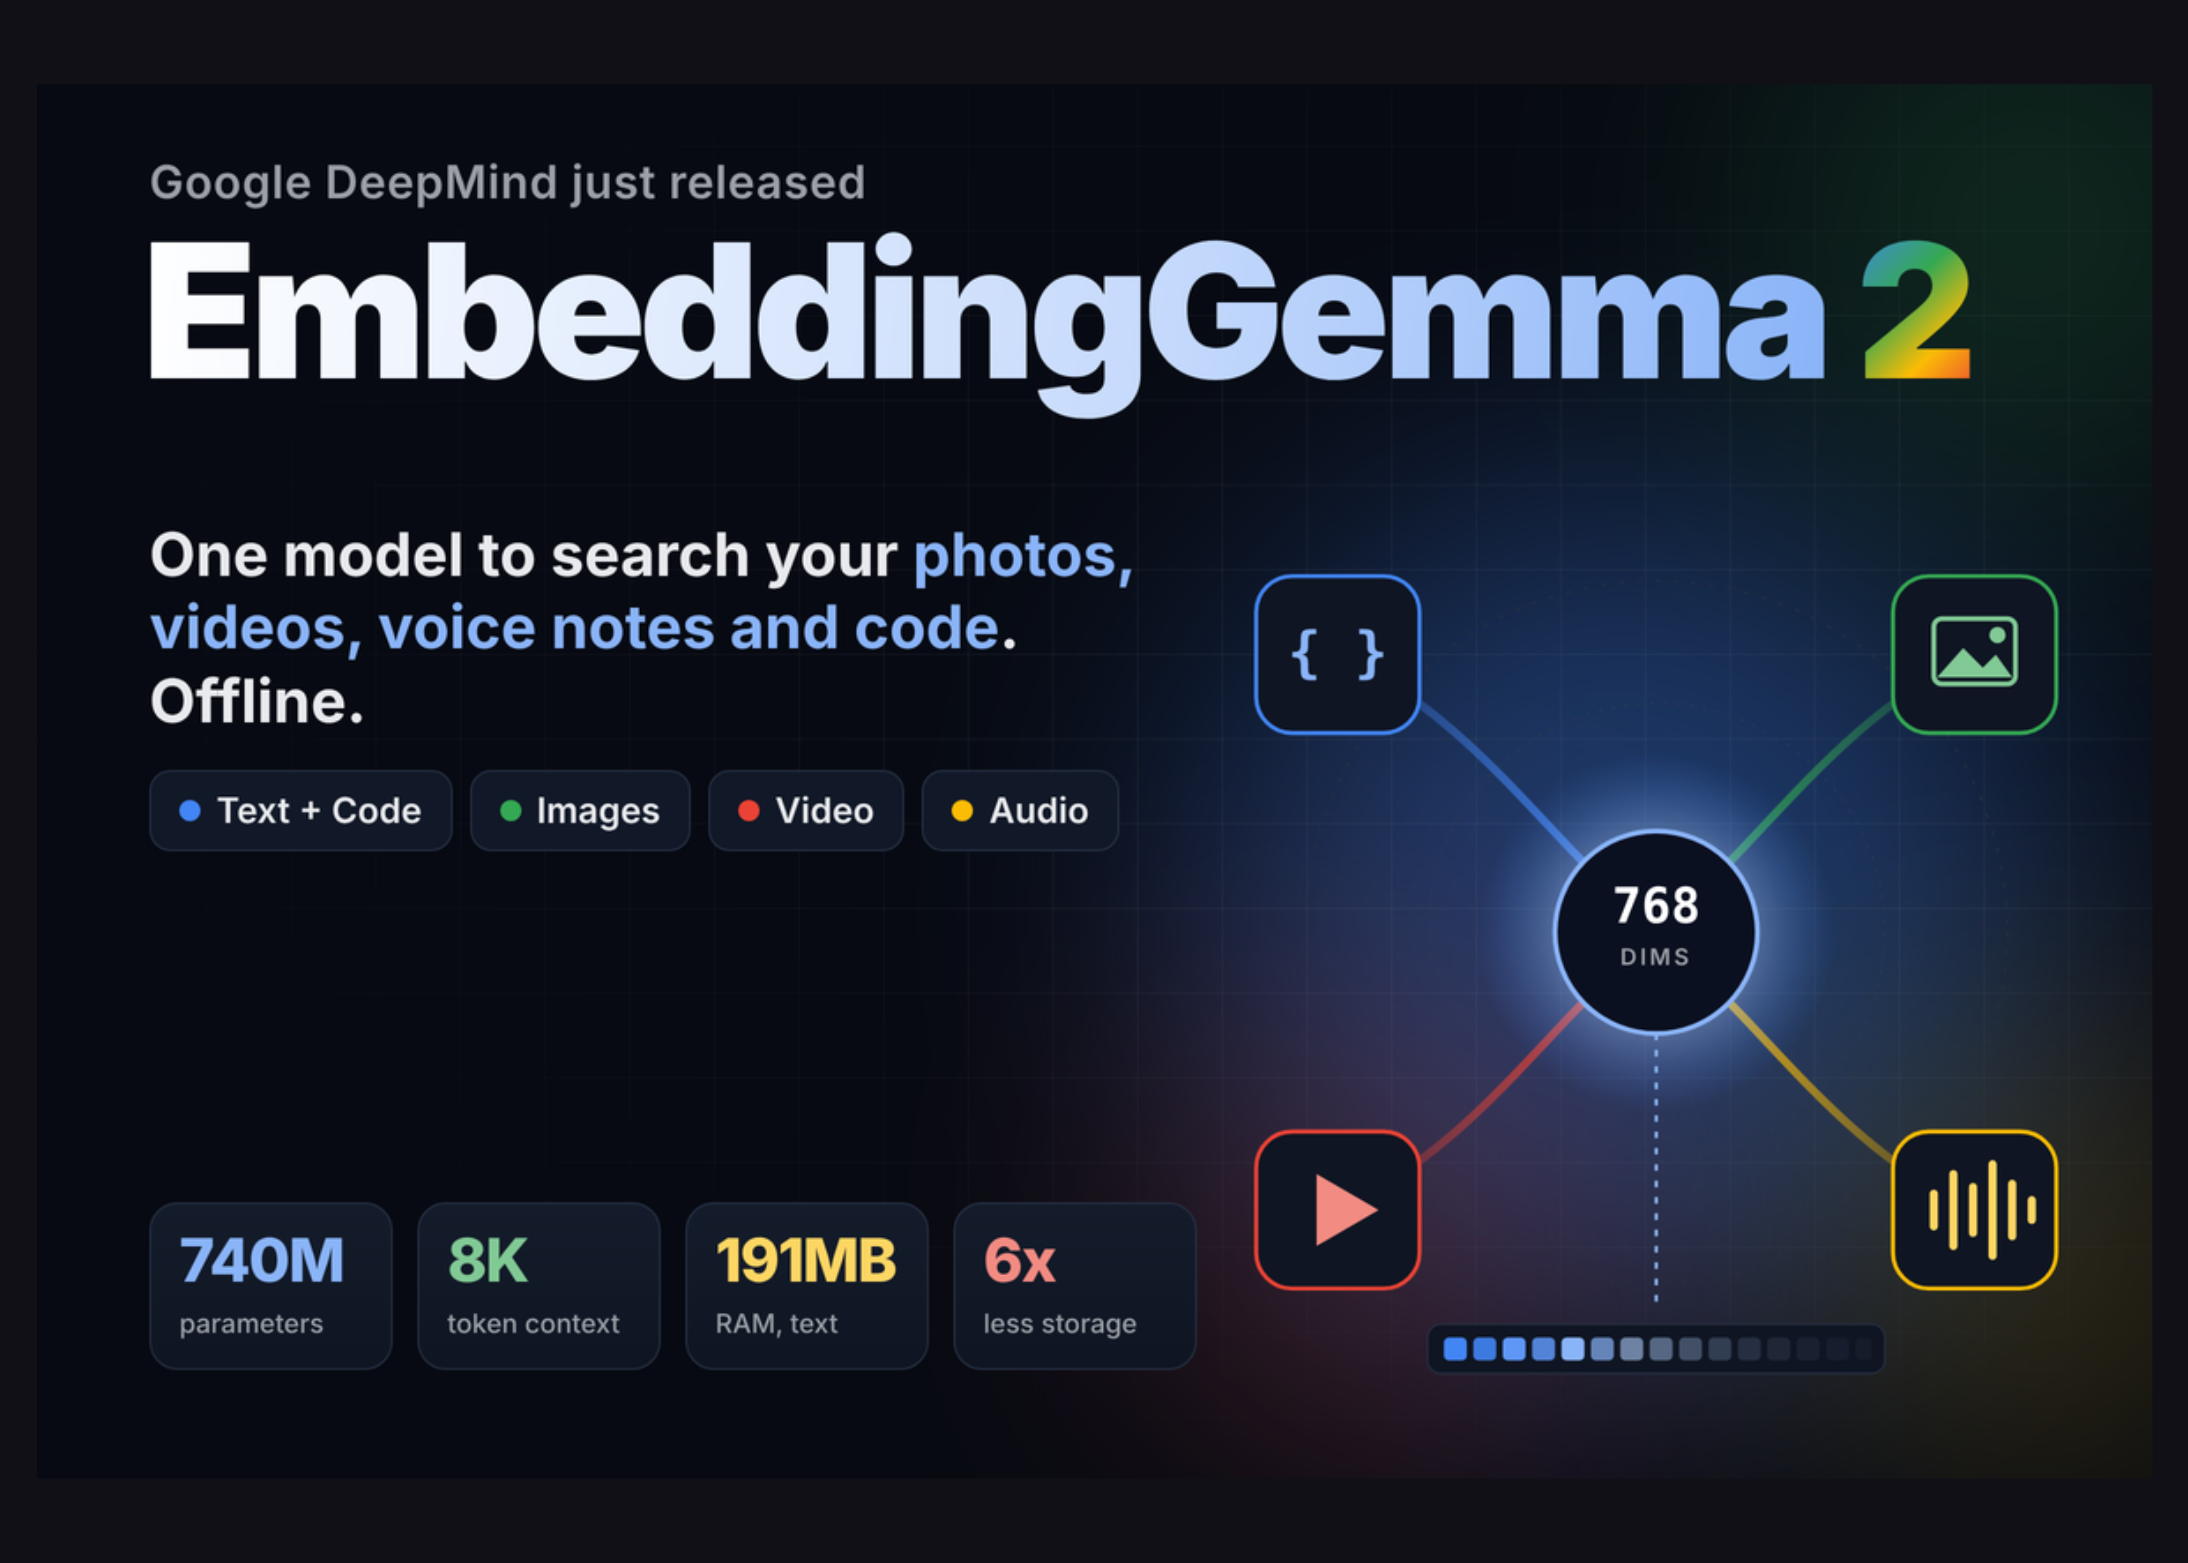
MarkTechPost の2026年10月6日の報道によると、Google DeepMind は EmbeddingGemma 2 を公開した。7.4億パラメータ、8Kコンテキスト、Apache 2.0 ライセンスのオープンウェイトなマルチモーダル埋め込みモデルで、テキスト、コード、画像、動画、音声を同一の768次元空間にマッピングする。テキスト主幹は2.7億パラメータで単独ロード可能。
主な変更
MarkTechPost の2026年10月6日の報道によると、Google DeepMind は EmbeddingGemma 2 を公開した。Gemma 4 アーキテクチャに基づくオープンウェイトなマルチモーダル埋め込みモデルで、Apache 2.0 ライセンスを採用する。モジュール式エンコーダで異なるモダリティを同一の768次元ベクトル空間にマッピングする。テキストとコードの主幹は約2.7億パラメータ(1.3億の transformer と1.4億の embedder)、視覚エンコーダは1.7億パラメータでオプション、音声エンコーダは3億パラメータでオプション、すべてロードすると合計約7.4億パラメータとなり、開発者は必要な部分だけをロードできる。コンテキストウィンドウは8192トークンで、報道によれば第一世代の4倍であり、約29枚の画像、58フレームの動画、または5.5分の音声を収容できる。モデルカードによれば、MTEB Code v1 は前世代の68.76から78.68に向上し、MTEB multilingual v2 は61.15から61.36となり、新たに MIEB lite 画像64.64、MMEB v2 総合59.01、MAEB 音声49.39 などの指標が追加された。報道によると、重みは Hugging Face と Kaggle で公開済みで、Ollama、llama.cpp GGUF、LiteRT、sentence-transformers v6.1.0+、vLLM、SGLang、MLX、LM Studio、MediaPipe などの実行方法が提供され、ベクトルストアは Qdrant が対応し、微調整は Unsloth が対応する。MRL はベクトルを512、256、128次元に切り詰めることをサポートする。
開発者への影響
開発者にとって、今回の公開の重要な変化はパラメータ数ではなく、同一のベクトル空間がコードと音声を同時にカバーし、テキスト主幹のみをロードできる点である。これは3種類の選定判断を直接変える。第一に、マルチモーダル RAG の検索層はこれまでテキストと画像で2つの埋め込みモデル、2つのインデックス、スコア正規化ロジックが必要になることが多かった。報道によれば、純テキスト構成で生成したクエリベクトルが完全モデルで生成した文書ベクトルと一致する可能性があり、もし再現できれば、まず2.7億パラメータの主幹でインデックスを構築し、必要に応じて視覚や音声エンコーダを追加してもライブラリを再構築せずに済むことを意味する。第二に、コード検索ベンチマークの向上幅(報道では約9.92ポイント、約14%)により、コードベースのセマンティック検索シナリオの候補リストに入るが、これはベンダーのモデルカードの数値であり、自社リポジトリでの性能を意味しない。第三に、アリババの Qwen3-VL-Embedding-2B とは異なるトレードオフを形成する。報道によれば後者は自身の MMEB v2 テストで73.2点を報告し、パラメータ数は約2.7倍で音声をサポートしない。一方 EmbeddingGemma 2 は8Kコンテキスト、端末側メモリ、音声サポートを強調する。オープンウェイトは無制約のオープンソースライセンスと等しくないことに注意が必要だ。Apache 2.0 は寛容なライセンスだが、モデルレポートの訓練データの出所と下流のコンプライアンス要件は自分で確認する必要がある。また、KimiSeek の現在のモデルカタログには EmbeddingGemma 2 という名前のエントリはなく、このバージョンは現時点で KimiSeek に掲載されていない。報道で言及された利用可能性は Hugging Face、Kaggle、Ollama などの外部チャネルを指し、将来 API 形式で提供される場合もそのベンダーのページを基準にすべきである。
導入と評価の提案
以下は提案と条件分析であり、報道された事実ではない。提案一:まずクロスモーダル検索が必要かどうかを判断する。中国語テキストとコードのみで、すでに成熟したテキスト埋め込みモデルを使用している場合は、EmbeddingGemma 2 を即時置き換えではなく A/B 候補として扱い、同一の自社クエリと文書で再現率実験を先に行い、評価指標は Recall@10 と nDCG@10 を使い、MTEB スコアだけを見ないこと。ワークロードに図文混在や音声メモ検索が実際に含まれる場合は、その共有ベクトル空間仮説を優先的に検証する価値がある。2.7億のテキスト主幹でライブラリを構築し、次に完全モデルで同じ図文文書を埋め込み、構成間の類似度一貫性を測定し、関連性ランキングが明らかに漂う場合は構成ごとにインデックスを分ける必要がある。提案二:次元とストレージのトレードオフ。報道によれば256次元では MTEB multilingual は61.36から60.41へわずかに低下するのみだが、128次元では MMEB が45.65に下がり、公式は128次元を主に純テキスト用と推奨している。ボトルネックがベクトルストアのストレージコストでシナリオが純テキストなら、まず256次元に切り替えて検証できる。画像や動画検索を含む場合は768次元を維持し、自社データで256次元と768次元の再現率の差を比較し、許容できる再現率損失の閾値を設定してから決定する。提案三:デプロイスタックのロックインリスク。実行可能なスタックが多いため、選択時はサーバー側か端末側かの目標を基準にし、ベクトル次元、プロンプトテンプレート(報道の SearchQuery と Document のプロンプト名)、量子化方式を設定に含め、固定回帰セットで量子化前後を各1回実行し再現率の差を比較する。評価時は公開ベンチマークではなく企業自社データを必ず使用すること。報道では多言語品質はほぼ横ばいで、向上はコードと新規モダリティに集中している。
制限と未確認事項
上記のベンチマーク、メモリ使用量、レイテンシの数値はすべて Google のモデルカードまたは研究チームの自己申告に由来し、ベンダー報告であって独立した第三者による再現はない。端末側の191MBと567MBは特定デバイス(Pixel 11 Pro)で量子化後のアクティブメモリであり、他のハードウェアに直接外挿できない。報道では訓練データの構成と言語分布の詳細は開示されておらず、中国語シナリオの実際の性能は自分で検証する必要がある。クロスモデル比較における Qwen3-VL-Embedding-2B の73.2点は自身の MMEB v2 自己申告口径であり、部分的な比較や異なるベンチマークのスコアを直接横並び比較することはできない。さらに、EmbeddingGemma 2 というバージョンは現在 KimiSeek のモデルカタログに存在しないため、本記事では KimiSeek で利用可能なモデルとは見なさない。報道で言及された重みの公開、Ollama のプル、各種ランタイムサポートはいずれも外部チャネルのベンダーまたはコミュニティリリースを指し、関連する可用性と将来の価格は対応するプラットフォームの公式ページを基準にすべきである。報道では Android 向け ML Kit サポートが数週間以内に提供されると言及されているが、これは計画であり既成事実ではないため、これに基づいてスケジュールを組むべきではない。
元の報道の図版