EmbeddingGemma 2 発表:7.4億パラメータのマルチモーダル埋め込みモデル、Apache 2.0 でオープンウェイト
Google DeepMind の 2026 年 10 月 6 日付公式ブログによると、EmbeddingGemma 2 は Apache 2.0 ライセンスで公開され、7.4 億パラメータを持ち、テキスト・コード・画像・音声・動画を統一埋め込み空間にマッピングでき、8K コンテキストと切り詰め可能なベクトル次元に対応する。

主な変更
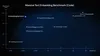
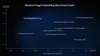
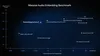
Google DeepMind が 2026 年 10 月 6 日に公開した公式ブログによれば、同社はオンデバイス推論向けのマルチモーダル埋め込みモデル EmbeddingGemma 2 を発表した。このモデルは Gemma 4 アーキテクチャを基に構築され、パラメータ数は 7.4 億で、Apache 2.0 ライセンスで公開されている。ソースによると、テキスト・コード・画像・音声・動画の組み合わせをネイティブに統一埋め込み空間へマッピングでき、Gemini Embedding と同源の技術を採用している。ソースが報告する設計上の要点は次の通り。テキストのみの用途では最小約 2.7 億パラメータ、視覚エンコーダ約 1.7 億、音声エンコーダ約 3 億はオプションモジュールである。Matryoshka 表現学習により、出力ベクトルを 768 次元から 512、256、128 次元へ切り詰められ、ソースは最大約 6 倍のストレージ削減をもたらすとしている。コンテキストウィンドウは 8K トークンで、ソースによれば EmbeddingGemma 1 の 4 倍であり、約 5.5 分の音声、29 枚の画像、58 フレームの動画を処理できる。ソースが示すベンチマークデータには、MTEB Code が 68.76 から 78.68 へ向上、つまりコードタスクで 9.92 ポイント改善したことや、10 億パラメータ未満のマルチモーダル埋め込みモデルの中で先行する成績を得たとの主張が含まれる。またソースは、量子化後に Google Pixel 11 Pro 上でテキストのみの重みは約 191MB のアクティブメモリ、完全なマルチモーダルモデルは約 567MB を要するとしている。重みは Hugging Face と Kaggle で公開済みで、ソースによれば Gemini Enterprise Agent Platform Model Garden のサポートは近日提供予定であり、オンデバイス最適化版は Hugging Face 上の LiteRT Community にある。
開発者への影響
開発者にとって今回の発表の核心的な変数は、埋め込みモデルの能力範囲がテキストから音声・動画・コードへ広がったこと、そして重みが Apache 2.0 で公開され自ら微調整や再配布が可能である点だ。これはベンダー API 経由でしか呼び出せないクローズドな埋め込みサービスとは異なる制約となる。ただし、Apache 2.0 はライセンス面での開放であり、重みをダウンロードできるかどうかとは別問題である。本報道のライセンス情報はソース原文に基づくもので、実際の利用前にモデルカードとライセンスファイルを確認すべきだ。ソースによれば EmbeddingGemma 2 は Gemma 4 とテキストトークナイザーおよび音声エンコーダを共有しており、これは埋め込みモデルと生成モデルを同一のオンデバイスパイプラインに置く場合、ソースが総メモリ使用量をより低く見積もっていることを意味し、オフライン RAG やオンデバイスエージェントのデプロイコストに直接影響する。切り詰め可能なベクトル次元ももう一つの実務上の変数である。ベクトルストアのストレージと検索品質は通常次元の低下とトレードオフの関係にあり、128 次元と 768 次元の選択は自らのデータ規模で測定すべきで、ソースの宣伝文句をそのまま適用することはできない。ソースはまた、利用可能な推論・デプロイツールチェーンとして transformers、sentence-transformers、MLX、vLLM、llama.cpp、SGLang、Ollama、LMStudio、およびブラウザ側の transformers.js と WebGPU を挙げ、ベクトルストアとして Qdrant に言及している。これらのツール名はソースが列挙したデプロイ選択肢であり、本プラットフォームが統合済みまたは検証済みであることを意味しない。このバージョンは現在 KimiSeek のリアルタイムカタログに完全一致する項目がなく、ソースが言及する重みのダウンロードとオンデバイスデプロイ能力は DeepMind や Hugging Face など公開元のチャネルを指し、本プラットフォームの API 供給ではない。
導入と評価の提案
提案 1:まずマルチモーダル埋め込みが必要かどうかを決め、それから完全なモデルが必要かどうかを決める。ソースは完全なマルチモーダルが Pixel 11 Pro 上で量子化後約 567MB のアクティブメモリ、テキストのみで約 191MB と報告し、視覚・音声エンコーダはオプションモジュールである。検索コーパスがテキストとコードのみなら、まずテキスト経路のみをロードできる。音声・動画検索のニーズが確かにある場合にのみ、対応するエンコーダを導入する。実行可能な評価基準は、対象のオンデバイス機器または許容できる最小のサーバー仕様上で、コールドスタート遅延、常駐メモリのピーク、毎秒の埋め込みスループットを測定し、遅延予算を依然満たすか確認することだ。提案 2:MRL の切り詰め次元について、デフォルトの 768 次元をそのまま採用するのではなく、自ら検索実験を行う。ソースは 512、256、128 の 3 段階と最大 6 倍のストレージ削減を挙げているが、検索品質が許容できるかは自らのコーパスとクエリ分布に依存する。評価基準としては、自前のラベル付きまたは人手判断による検索セットで 768 次元と 256 次元、128 次元の Recall@10 と平均クエリ遅延の差を比較し、品質低下が業務上の閾値内に収まる場合にのみ低次元を採用する。提案 3:コード検索が主要な用途なら、ソースが報告する MTEB Code の向上は再現すべき対象と見なせる。評価基準としては、自らのコードベース上で同一のクエリセットを使い、EmbeddingGemma 1 と EmbeddingGemma 2 のヒット率とクロスリンガル検索性能をそれぞれ測定する。公開ベンチマークの絶対スコアは私有コードベース上の相対比較の代わりにはならないからだ。以上はすべてソース情報に基づく提案と条件付き分析であり、ソースが報告した既成事実ではない。
制限と未確認事項
まず明確にすべきは、EmbeddingGemma 2 は現在 KimiSeek のリアルタイムカタログに完全一致する項目がなく、本プラットフォームはこのモデルを提供しておらず、ソースが述べる重みのダウンロードとオンデバイスデプロイ能力は DeepMind や Hugging Face など公開元のチャネルを指し、本プラットフォームの API 供給ではない。次に、ソース中のベンチマークスコア(MTEB Code の 68.76 から 78.68 への向上、10 億パラメータ未満での先行などの表現を含む)は公開元の自己申告であり、ブログは完全な評価条件、比較モデル一覧、評価バージョンを示していないため、独立した検証結果とは見なせず、実際の性能は自ら再現する必要がある。第三に、ソースが示すメモリとストレージのデータ(約 191MB、約 567MB、最大 6 倍の削減)は特定の量子化方式と Google Pixel 11 Pro に基づくもので、他のハードウェアや量子化構成では必ずしも成立しない。第四に、ソースが主張する Gemma 4 とのトークナイザーおよび音声エンコーダ共有による統合メモリの優位性について、実際の数値はソースに示されていない。第五に、Gemini Enterprise Agent Platform Model Garden のサポートはソースで「近日提供予定」と記載されており、計画的な表現であって現在利用可能であることを意味しない。本プラットフォームもこのモデルの API 接続を提供しない。価格と可用性は時間とともに変化するため、読者は各公開元の現在の価格ページとモデルカードを参照すべきだ。
元の報道の図版