JetBrains が Mellum2.1 を公開:12B MoE コーディングエージェント、Apache 2.0 の重みと量子化版を用意
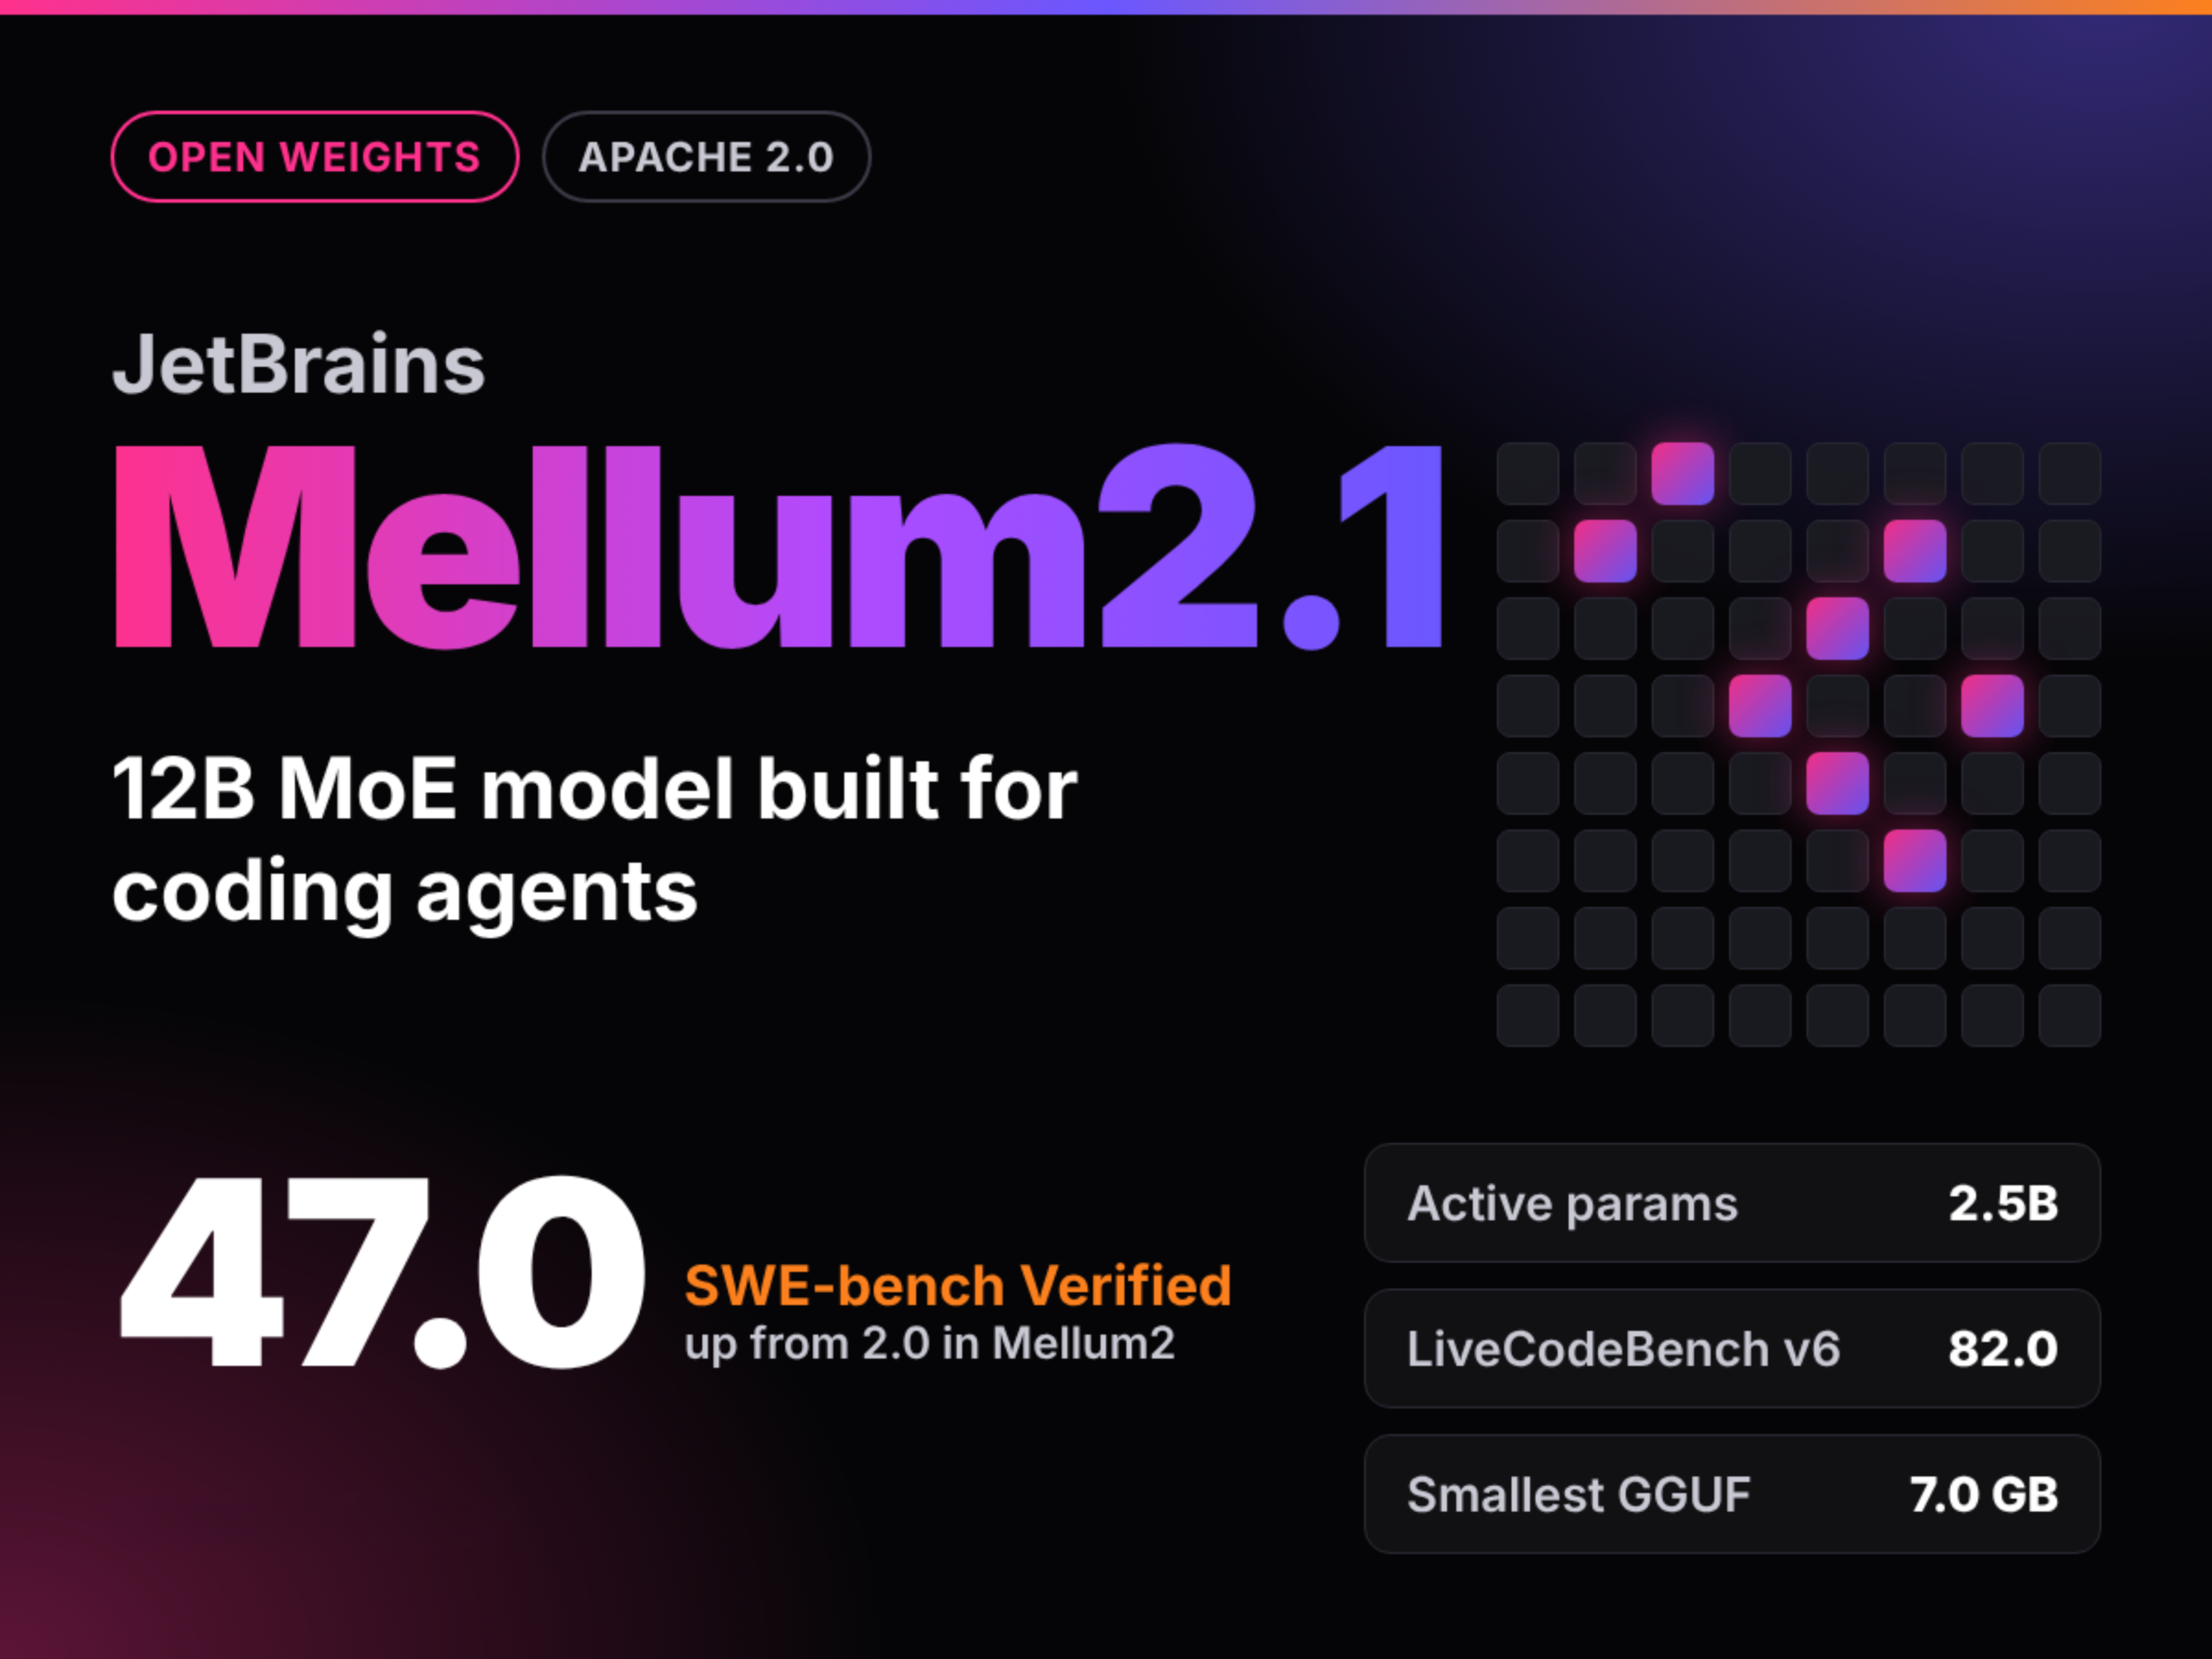
MarkTechPost の 2026 年 10 月 8 日の報道によると、JetBrains は Mellum2.1(チェックポイント名 Mellum2.1-12B-A2.5B-Thinking)を Apache 2.0 ライセンスで公開した。総パラメータ 12B、トークンあたり 2.5B を活性化する MoE 推論モデルで、アーキテクチャは前世代と同じく、主な改善は実コードリポジトリでの強化学習によるものとされ、報告では SWE-bench Verified が 2.0 から 47.0 に上昇したという。
主な変更
MarkTechPost の 2026 年 10 月 8 日の報道によると、JetBrains は Mellum2.1 を公開し、チェックポイント名は Mellum2.1-12B-A2.5B-Thinking で、Apache 2.0 ライセンスの下で Hugging Face に重みを公開した。総パラメータ 12B、トークンあたり 2.5B のパラメータを活性化する Mixture-of-Experts 推論モデルであり、28 層、64 エキスパート、トークンあたり 8 エキスパートを活性化し、GQA(32 クエリヘッド、4 KV ヘッド)を採用、4 層ごとに 3 層が 1024 トークンのスライディングウィンドウを使用し、コンテキスト長は 131072 トークン、語彙数は 98304、重みは bfloat16 である。報道によると、アーキテクチャは 2026 年 6 月にオープンソース化された Mellum2 Thinking から変わっておらず、アップグレードはほぼすべてポストトレーニングによるもので、RL が訓練の主体となり、数学、競技プログラミング、科学、ツール呼び出し、ソフトウェアエンジニアリングのタスクを追加し、実際のコードリポジトリで shell とファイル編集ツールを用いて訓練し、テスト通過に報酬を与えている。報道によると、JetBrains の自社テストでは SWE-bench Verified が 2.0 から 47.0、SWE-bench Pro が 0.0 から 28.0、Terminal-Bench 2.1 が 0.6 から 17.4、LiveCodeBench v6 は 82.0、BFCL v4 は 62.3、HarmBench は 21.5 から 8.5 に低下した。一方、Qwen3.5-9B は SWE-bench Verified(50.0)、SWE-bench Pro(38.0)、GPQA Diamond(77.8)、AIME 25/26(86.7)で依然として先行している。
開発者への影響
このリリースが自ホスト型コーディングエージェントにとって持つ意味は主に 3 点であり、いずれも独立した再現ではなく報道に基づく。第 1 に、モデルは Apache 2.0 ライセンスで重みを公開しており、単にダウンロード可能な重みではなくライセンスが明確なオープンウェイトのリリースである。しかし報道中のベンチマークスコアはすべて JetBrains の自己申告であり、Qwen 公式モデルカードは同一モデルの LiveCodeBench v6 と GPQA Diamond の数値が JetBrains の評価手順と明確に異なっており、スコアは評価フレームワークに敏感で、ベンダー間で比較可能な結論として直接扱うことはできない。第 2 に、2.5B の活性化パラメータに 131072 トークンのコンテキストと GGUF 量子化を加えることで、ローカルのサブエージェントがコンシューマー向けまたは単一 GPU 環境で実行可能になる。報道では BF16 24.3 GB、Q8_0 12.9 GB、Q4_K_M 8.1 GB(最初のトークン一致率 88.0%)、MXFP4_MOE 7.0 GB(85.6%)などのバージョンが挙げられている。開発者が注目すべきは、量子化後の能力低下が自分のタスクの許容範囲に収まるかであり、単一ファイルのサイズではない。第 3 に、報道によると単一の H200 で高負荷時にスループットが Qwen3.5-9B の約 2 倍に近づき、MTP は単一リクエストのシナリオで約 1.6 倍の加速を示すが、vLLM の投機的デコーディングに使う MTP ヘッドは近日公開と記載されており、現在のデプロイではこの加速を直接利用できない。コーディングエージェントを使うチームにとって、これは汎用推論の主力代替品というよりも、低コストの実行ユニットの候補である。報告では Terminal-Bench 2.1 と知識系ベンチマークで劣っていることが示されている。
導入と評価の提案
スタック全体を置き換えるのではなく、タスクごとに層別に検証することを勧める。判断 1:ワークロードが高並列で短いステップのコード補完やサブエージェント実行ユニットである場合、単一 GPU 以上の VRAM と vLLM または SGLang 環境があることを前提に、12B/2.5B 活性化の MoE デプロイを優先的に評価できる。報道で示された起動方法は vLLM に --reasoning-parser qwen3 を付け、ツール呼び出しには --enable-auto-tool-choice --tool-call-parser hermes を追加し、サンプリングパラメータは temperature 0.6、top_p 0.95、top_k 20 を推奨している。指標は同等ハードウェアでのトークンあたりスループットとタスクあたりコストであるべきで、ベンチマークスコアだけを見てはならない。判断 2:ワークロードが長いチェーンのリポジトリレベルの修正である場合、まず自社リポジトリで小規模な比較を行い、Qwen3.5-9B のようなモデルとタスク通過率と失敗モードを比較することを勧める。報道の自己申告では SWE-bench Verified 47.0 が Qwen3.5-9B の 50.0 を下回り、Terminal-Bench 2.1 の差はさらに顕著である。ここでの条件は、企業が自動判定可能なテストセットを既に持っていることである。指標はエンドツーエンドのタスク通過率と平均ステップ数である。判断 3:ローカルまたはオフラインのシナリオでは、まず Q4_K_M と MXFP4_MOE の量子化版を試すことができる。前提は、タスクが最初のトークンの挙動の偏りに敏感でないことである。指標は、量子化版と BF16 参照版の自社プロンプトセット上での最初のトークン一致率と実際の正解率の落差である。また、報道が述べる可用性はベンダーが公開した重みと推論フレームワークのサポートを指し、接続方法は各フレームワークのドキュメントに従う必要がある。
制限と未確認事項
重要な制限を明確にしておく。Mellum2.1 は KimiSeek のライブモデルカタログに存在せず、このバージョンは現在 KimiSeek には掲載されていない。報道で言及された重み、GGUF、vLLM/SGLang のデプロイ方法はすべて JetBrains 側のリリースを指し、本サイトで利用可能であることを意味しない。すべての性能数値は JetBrains の自己申告または同社の統一評価手順によるもので、SWE-bench、Terminal-Bench、LiveCodeBench、BFCL を含み、独立した再現は行われていない。報道自体が、Qwen 公式モデルカードと JetBrains の評価が同一モデルで異なる数値を示していると指摘しているため、横比較の結論には注意が必要である。量子化版の最初のトークン一致率はタスクの正解率と同じではない。報道の GGUF リストと「GGUF はまだ作成中」という説明には口径の違いがあり、実際に利用可能なファイルと品質は自分で確認する必要がある。MTP ヘッドは近日公開と記載されており、vLLM の投機的デコーディングによる加速は現時点では利用できない。また、具体的な呼び出し価格と課金方法はベンダーの価格ページに従うべきであり、本記事では具体的な数値を引用しない。