Kimi K3.1 Pro HighspeedがBedrockで提供開始、デフォルトの推論強度はmax:Flex層と明示的キャッシュには制約
AWSは2026年11月10日のブログで、Kimi K3.1 Pro HighspeedがAmazon Bedrockで提供開始されたと発表した。K3のエンドポイントとAPIを踏襲し、Moonshot AIの自己申告によれば出力速度はK3.1 Proの2〜3倍。デフォルトの推論強度がmaxであること、Flex層の遅延コスト、明示的キャッシュがConverseで利用不可という点が、導入前に決めるべき三つの事項だ。
主な変更
AWSは2026年11月10日の機械学習ブログで、Moonshot AIのKimi K3.1 Pro HighspeedがAmazon Bedrockで提供開始されたと発表した。記事ではこれをKimi K3の事後学習版と位置づけ、同じ3T級のオープンウェイトアーキテクチャと100万トークンのコンテキストウィンドウを踏襲し、大幅に多い事後学習計算で訓練したとしている。Moonshot AIによれば、この訓練は長期的なエージェントタスク向けで、事実誤認の削減と、財務モデリング、オフィス文書、ゲームエンジン・3Dシーン・CADスクリプト向けのコーディング能力の向上を目的とする。出力トークンの生成速度はより高く、Moonshot AIの自己申告ではKimi K3.1 Proの2〜3倍だ。Bedrock上ではKimi K3のエンドポイント、API、機能を踏襲するため、K3を利用中のアプリはモデルIDの変更だけで済む。ツール呼び出し、構造化出力、設定可能な推論、画像入力、ストリーミング出力に対応し、global、us、inの三つのクロスリージョン推論プロファイルからアクセスできる。リージョンのデータレジデンシー要件がプロファイル選択の判断基準となる。AWSは、データは自社のデータ境界内で処理され、Moonshot AIと共有されず、モデル訓練にも使われず、推論リクエストではゼロデータ保持が常に有効で、オペレーターは推論中にプロンプトと補完結果を閲覧できないとしている。K3.1シリーズは以前から報じられており、今回新たなのはBedrockのマネージド経路と、それに伴い確定した推論・課金の選択肢だ。
開発者への影響
導入への実際の影響は、モデル能力そのものよりインターフェースの形とデフォルト値に集中する。OpenAI SDKを利用中のチームは、base_urlをBedrockランタイムのエンドポイントに向け、モデル名を変えるだけで済むが、認証はAWS認証情報から生成した短期ベアラートークンに変わる。IAMにはInvokeModelとInvokeModelWithResponseStreamの権限が必要で、ベアラートークンを使う場合はCallWithBearerTokenも要る。BedrockはOpenAI互換のChat CompletionsとResponses、独自のConverseとInvokeを併せて提供し、AWSは前者を推奨する。第二の変化は推論がデフォルトで最大になる点だ。モデルは常に推論してから回答し、強度未設定ならmaxとなる。分類、フィールド抽出、短い質疑応答のように答えの空間が小さいタスクでは、これが遅延と出力トークンを直接押し上げる。Converseの応答を解析する際も、推論ブロックが先に返る可能性があるためテキストブロックを選ぶ必要がある。第三は階層だ。AWSによればFlexはStandard価格の半額で提供される代わりに応答時間が長くなる可能性があり、オンデマンドクォータはStandard、Priority、Flexの三層で共有されるため、トラフィックをFlexに移してもクォータが増えるわけではない。階層はリクエスト単位で指定でき、同一アプリ内で混用できる。第四はキャッシュのインターフェース境界だ。明示的プロンプトキャッシュはChat Completions、Responses、Invokeに適用され、Converseには適用されない。ブレークポイントの前に少なくとも256トークンの安定した内容が必要で、キャッシュ内容は少なくとも30分保持され、書き込みは標準入力より高い料率で課金され、読み取りは割引料率で毎分の入力トークンクォータには計上されない。毎ターンにシステム指示、ツール定義、リポジトリ規約を再送するエージェントやコーディングアシスタントでは、キャッシュヒットが単価以上に請求額へ影響しうる。記事はまた、出力速度がコーディングエージェントでより重要になる理由も説明する。ファイル読み込み、変更計画、コード編集、テスト実行、失敗修正は直列の呼び出しの連続で、各ステップは前のステップの完了を待つため、単位時間あたりの出力トークン増加はループ全体を短縮する。これらはいずれも経路側の構造的変化であり、モデル品質の独立した検証にはならない。
導入と評価の提案
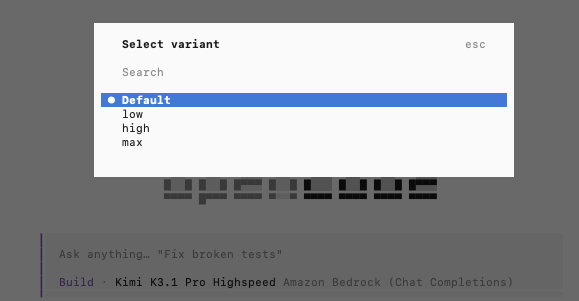
以下は本報道に基づく条件付きの分析と提案であり、推奨であって検証済みの事実ではない。 判断一、推論強度を設定に明示する。報道によればreasoning_effort未設定時はデフォルトでmaxで、low、high、maxを選択でき、Responsesではreasoning.effortが同じ設定に対応する。負荷が分類、フィールド抽出、短い質疑応答、テンプレート的な書き換えなら、答えの空間が小さいため、タスク種別ごとにlowまたはhighへ固定し、多段推論が本当に必要な経路だけmaxを残すことを勧める。前提は、勘で下げるのではなく、階層別の自前評価結果があることだ。経路が出力形式に厳格な制約を持つ場合は、階層を下げても構造化出力のフィールドが減らないことを確認する必要がある。測定基準は、同じ自前の問題セットでlowとmaxの通過率と出力トークン中央値を比較し、通過率の低下が許容範囲に収まりつつ出力トークンが明確に減るなら、階層を設定に書き込みデフォルトに頼らないことだ。 判断二、リクエスト単位でサービス階層を選び、実際に有効な階層を確認する。AWSによればFlexは遅延が長くなる可能性があるが価格は低く、階層はリクエスト単位で設定でき、三層はクォータを共有する。タスクがオフライン評価、バッチ要約、エージェント内のバックグラウンド処理で、単一応答の時間に敏感でなければ、トラフィックの一部をFlexに回し、ユーザー向けの同期リクエストはStandardかPriorityに残せる。前提は、CloudWatchのServiceTierとResolvedServiceTierのディメンションでリクエストが実際にどの階層で処理されたかを確認することだ。Flexを要求することとFlexで処理されることは別であり、階層の混用はテール遅延とクォータ消費の両方を変える。測定基準は、同じタスク群をFlexとStandardで実行したp95遅延とタスク千回あたりのコストで、コストが改善し、テール遅延が設定したタイムアウト予算内に収まる場合にのみ比率を広げることだ。 判断三、キャッシュの可用性を事後の最適化ではなくインターフェース選定の条件とする。明示的キャッシュはConverseでは使えず、ブレークポイントの前に少なくとも256トークンの安定した内容が必要で、キャッシュは少なくとも30分保持される。サービスがすでにConverse上に構築され、コンテキストに大きな安定プレフィックス(システム指示、ツール定義、リポジトリ規約)を含むなら、Chat CompletionsかResponsesへ切り替えて明示的キャッシュを得るか、自動キャッシュのみで受け入れるかを選ぶ必要がある。前者はヒット率を高められるが、呼び出し経路の変更と、キャッシュ書き込みが高い料率で課金されることを受け入れる代償がある。測定基準は、まず利用量からキャッシュトークン数を読み戻してヒットがゼロより大きいことを確認し、次に有効化前後の入力コストと最初のトークンまでの遅延を比較し、同時にブレークポイント位置の微調整でヒット率が大きく崩れないことを確認することだ。 もう一つ、アーキテクチャレビューの段階で決めておきたい点がある。globalプロファイルはトークンあたりのコストが地理的範囲のプロファイルより低いが、データレジデンシー要件がある場合はusかinしか選べず、稼働後に変更するとデプロイ構成に影響する。すでにBedrockでKimi K3を業務に使っているなら、最小の検証はK3とHighspeedを並行して同じタスク群に当て、最初のパケット速度だけでなくタスク完了時間と失敗リトライ回数を比較することだ。
制限と未確認事項
二つの不確実性を保持する必要がある。第一に、2〜3倍はMoonshot AIの自己申告の速度であり、AWSのブログはベンチマーク、測定方法、並行条件を示していない。実際の差は出力長と利用階層に依存し、独立に再現された結論として扱うことはできない。第二に、文中の「3T級のオープンウェイトアーキテクチャ」はアーキテクチャの記述であり、Bedrockが提供するのはマネージド推論サービスだ。重みをダウンロードできるか、どのライセンスで公開されるかはこの一文からは導けず、Moonshot AIの公式発表とライセンス文面を確認する必要がある。重みがダウンロード可能でも、オープンウェイトはオープンソースライセンスと同義ではない。もう一つ紛らわしい点がある。原文によれば、事後学習計算の増加、事実誤認の削減、財務モデリング・オフィス文書・ゲームエンジン・3D・CADスクリプトなどの専門能力向上はKimi K3に対する記述だ。Highspeedと非HighspeedのK3.1 Proの間で、本文が示す違いは主に出力トークン生成速度であり、記事は両者の項目別能力比較もHighspeedの独立した評価データも示していない。キャッシュの「少なくとも30分保持」は下限のみで上限はなく、Flexの遅延コストも定性的な記述にとどまる。対応リージョン、クォータ、価格は変動するため、Bedrockのモデルカード、リージョン可用性ページ、料金ページを基準とすべきだ。サイト内カタログの今回の確認時点では同名の項目がすでにあり、価格と上限はサイト内の料金ページを見られたいが、カタログ収録とBedrockでの提供開始は別の事柄であり、前者は後者の検証にはならない。
元の報道の図版