Liquid AI、LFM3を発表:6つの2B級モデルが共通バックボーンを共有、オープンウェイト下での端末側のトレードオフ
Liquid AIの2026年10月27日のブログによると、LFM3はテキスト、視覚、音声、全モダリティ、意思決定モデルを1.7B級の共有バックボーンに統合し、すべてオープンウェイトで単一GPUでファインチューニング可能と主張している。開発者は全モダリティ単一モデルと専用小モデルという2つの路線を改めて比較検討する必要がある。

主な変更
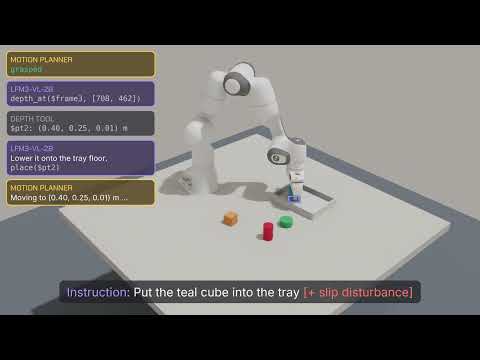
Liquid AIは2026年10月27日に公式ブログでLFM3シリーズを発表した。ブログによると、このシリーズには6つの2B級モデルが含まれる。LFM3-1.7B(テキスト)、LFM3-VL-2B(テキスト・画像・動画入力)、LFM3-Audio-2B(テキストと音声入力、テキストと音声出力)、LFM3-Omni-2B(全モダリティ入力、テキストと音声出力)、そして視覚・全モダリティ分岐に基づく意思決定モデルd1-2Bとd1-omni-2Bである。ほかに自前の事後学習用のLFM3-1.7B-Baseもある。ベンダーは、すべてのモデルが同一のバックボーンから分岐したもので、Hugging Faceから取得でき、単一GPUでファインチューニング可能であり、テキストモデルは4-bit精度で約1 GBを占め、バックボーンのコンテキストウィンドウは256Kトークンに拡張されたとしている。ブログにはいくつかの比較数値も示されている。例えばLFM3-1.7BはWebArena-Verifiedで38.42、前世代のLFM2.5-2.6Bは3.02。LFM3-VL-2Bは62の視覚ベンチマークでの平均スコアが57.6から71.4に上昇した。ベンダーはさらに、パラメータ数で計算するとLFM3-1.7Bはエッジデバイスの短いプロンプトでLFM2-1.2Bと同等であり、コンテキストに8Kトークンを含む場合は約25%高速だと主張している。これらの数値はすべてベンダーによる自己申告であり、第三者による再現は確認されていない。
開発者への影響
今回の発表の開発者にとっての核心的な影響は、モデルが1つ増えたことではなく、選定の粒度が変わったことにある。これまで端末側でマルチモーダルを動かすには、ASR、視覚言語モデル、TTSをパイプラインとして連結する必要が多かったが、今回はベンダーが全モダリティ単一モデルという選択肢を提供した。しかし同時に単一モダリティモデルも残していることは、マルチモーダルの統合がすべての場面で得策とは限らないことを示している。推論側の制約も変わる。視覚モデルはtransformers 5.21.0以上、音声と全モダリティモデルは5.20.2以上、d1は5.19以上を要求し、多くの例がtrust_remote_codeに依存しているため、フレームワークのアップグレードとカスタムリモートコードの審査が導入前の作業になる。端末側のメモリについては、テキストモデルが4-bitで約1 GBというのは計画に使える数値だが、ブログは視覚・音声モデルのVRAMやメモリ使用量を示しておらず、動画入力や音声ストリーミング出力の実際のリソース消費は自分で実測する必要がある。ブログは新しい視覚エンコーダとLiquidCodecの効率を強調し、音声の最初のトークンが最短50 ms、単一CPUスレッドで約87倍のリアルタイム音声合成だと主張しているが、こうした指標はハードウェアと入力長に強く依存するため、そのままオンラインの容量計画の根拠にすべきではない。ベンダーはSFT、DPO、GRPO、継続的事前学習をカバーするファインチューニング用notebookも提供しており、独自の用語やツール呼び出しが必要なチームにとっては、ベンチマークスコアよりも先に動かす価値がある部分だ。
導入と評価の提案
提案1(条件付き分析):端末側アプリケーションが同一リクエストで音声と映像を同時に扱う必要があるなら、まず全モダリティ単一モデルと「音声モデル+視覚モデル」の組み合わせを比較対照すべきだ。トリガー条件は、単一リクエスト内に実際にクロスモーダルな関連がある場合、例えば1フレームの映像に向かって口頭で質問するようなケースである。音声と映像が業務上無関係なら、専用モデルの方が制御性は通常高い。測定可能な基準は、同じ実サンプル群で最初のトークンの遅延、エンドツーエンドの完了時間、メモリのピークを比較し、全モダリティモデルが純テキストや純音声のサブタスクで専用モデルに対して明らかな劣化を示さないか確認することだ。提案2(条件付き分析):すでにLFM2.5シリーズに基づく推論サービスを持っているなら、WebArena-Verifiedの38.42対3.02のようなベンダー数値だけで直ちに切り替えるのではなく、まず自社のエージェント軌跡でA/Bテストを行うべきだ。トリガー条件は、ワークロードが長コンテキストのツール呼び出し中心である場合だ。ブログはアップグレードの利点が主にエージェントタスクと長コンテキストにあるとし、短いプロンプトでの比較はパラメータ数に基づく計算であり、絶対的な性能の同等性ではないとしている。測定可能な基準は、自社構築のタスクセットでツール呼び出しの成功率、フォーマット準拠率、1000トークンあたりの実所要時間を記録することで、公開リーダーボードだけを見ないことだ。提案3(条件付き分析):テキスト生成よりも構造化された判断に関心があるなら、d1-2Bが「小規模言語モデル+解析後処理」の代替になるか評価できる。前提は、業務が自然言語ではなくキャリブレーションされた確率出力を受け入れられることだ。下流が説明可能なテキストを必要とするなら、d1の路線は適さない。測定可能な基準は、ラベル付きの過去チケットや伝票で各フィールドのキャリブレーション誤差を計算し、1回のフォワードパスの処理遅延と既存パイプラインを比較することだ。
制限と未確認事項
出典はベンダーのブログであり、ベンチマークスコア、速度、メモリの数値はすべて自己申告で、独立した再現や完全な評価方法は提供されていない。ブログ内部の横比較の基準(例えば一部のエンコーダ比較が統一されたLFM2.5-230M言語バックボーンを使用している点など)も自分で確認する必要がある。ブログはすべてのLFM3モデルをオープンウェイトとしているが、本文は具体的なライセンス条項を説明していない。オープンウェイトはオープンソースライセンスと等しくなく、商用利用、再配布、ファインチューニング後の公開の権利はモデルカードとライセンス文面に基づくべきであり、「ウェイトがダウンロード可能」から推測することはできない。LFM3の各モデルは現在KimiSeekのオンラインカタログに対応する項目がなく、このバージョンは現在KimiSeekには掲載されていない。ブログもホスト型APIを提供しておらず、言うところの可用性はHugging Faceでのウェイトのダウンロードとローカル実行を指す。今後ホスト型サービスや別途の価格設定が現れた場合は、公式ページに従うべきだ。さらに例はtrust_remote_codeに依存しており、本番環境ではリモートコードを自ら監査する必要がある。動画入力、音声ストリーミング、多言語音声翻訳などの実際の効果とリソース消費について、ブログは少数の例しか示しておらず、自分で検証する必要がある。
元の報道の図版