Nemotron 3.5 Super VL、SageMaker JumpStartに登場—100万トークン主張もエンドポイントは15,600まで
AWSは11月9日のブログで、NVIDIAのNemotron 3.5 Super VLがSageMaker JumpStartで提供開始され、NVFP4とBF16の2つのバリアントがあると発表した。総パラメータ120B、活性12Bで、重みはOpenMDW 1.1ライセンスで提供されるが、マネージドエンドポイントのサービス設定はコンテキストを520〜15,600トークンに制限している。
主な変更
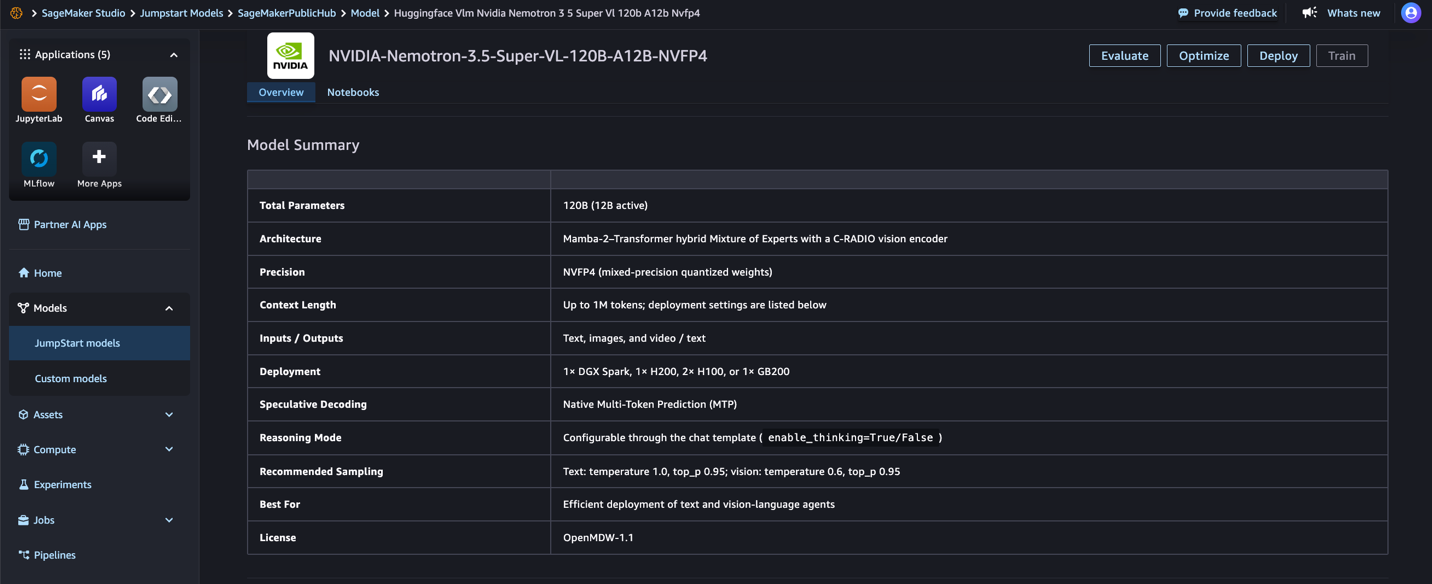
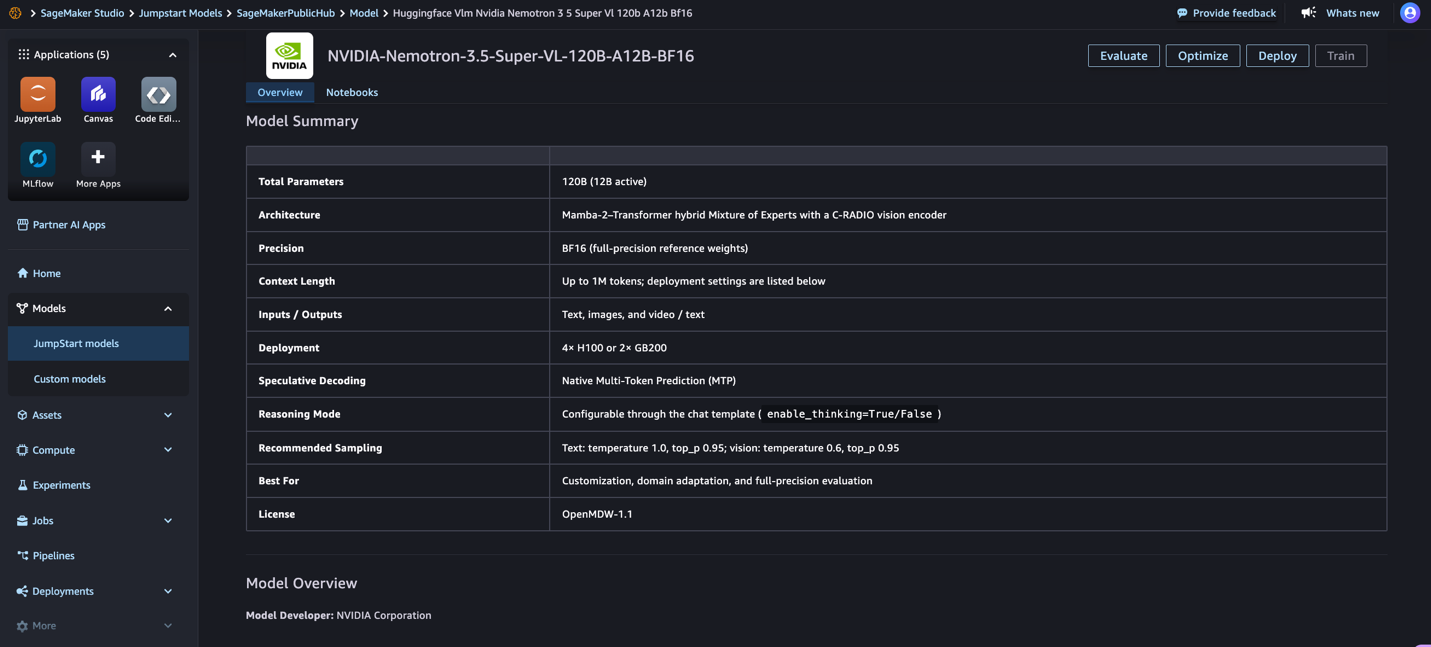
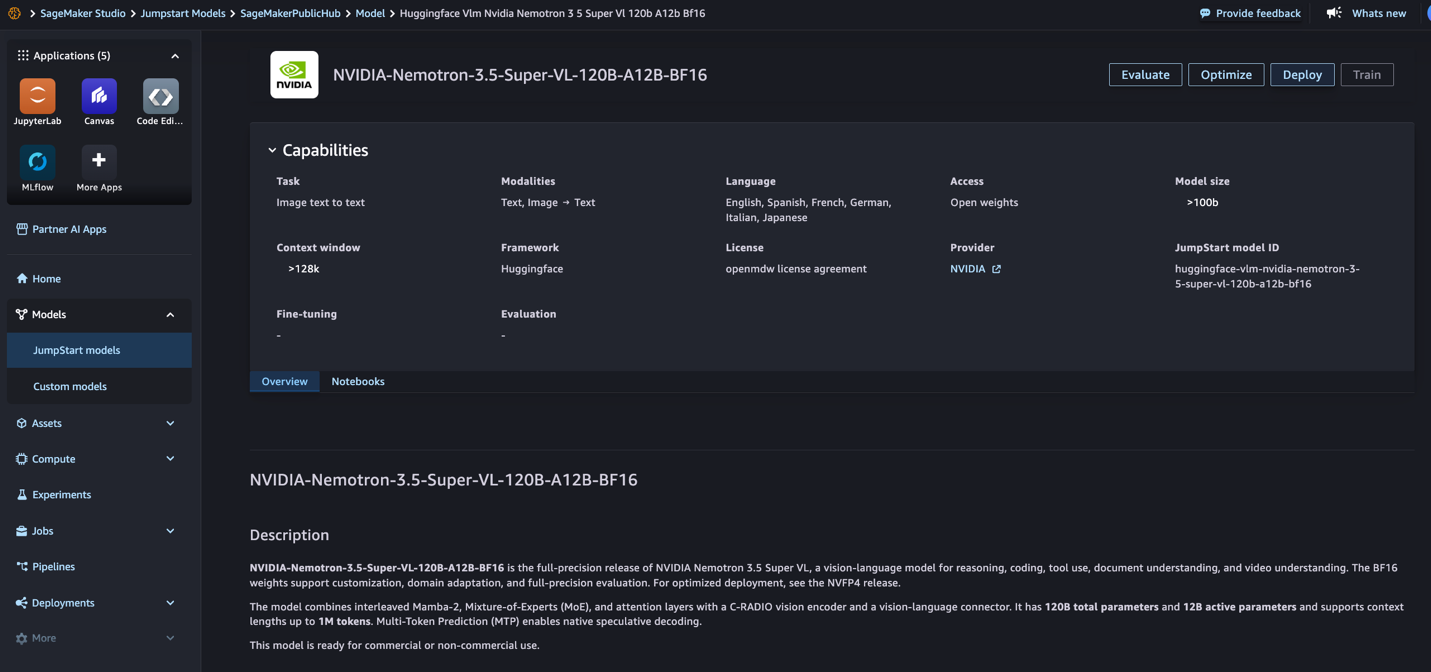
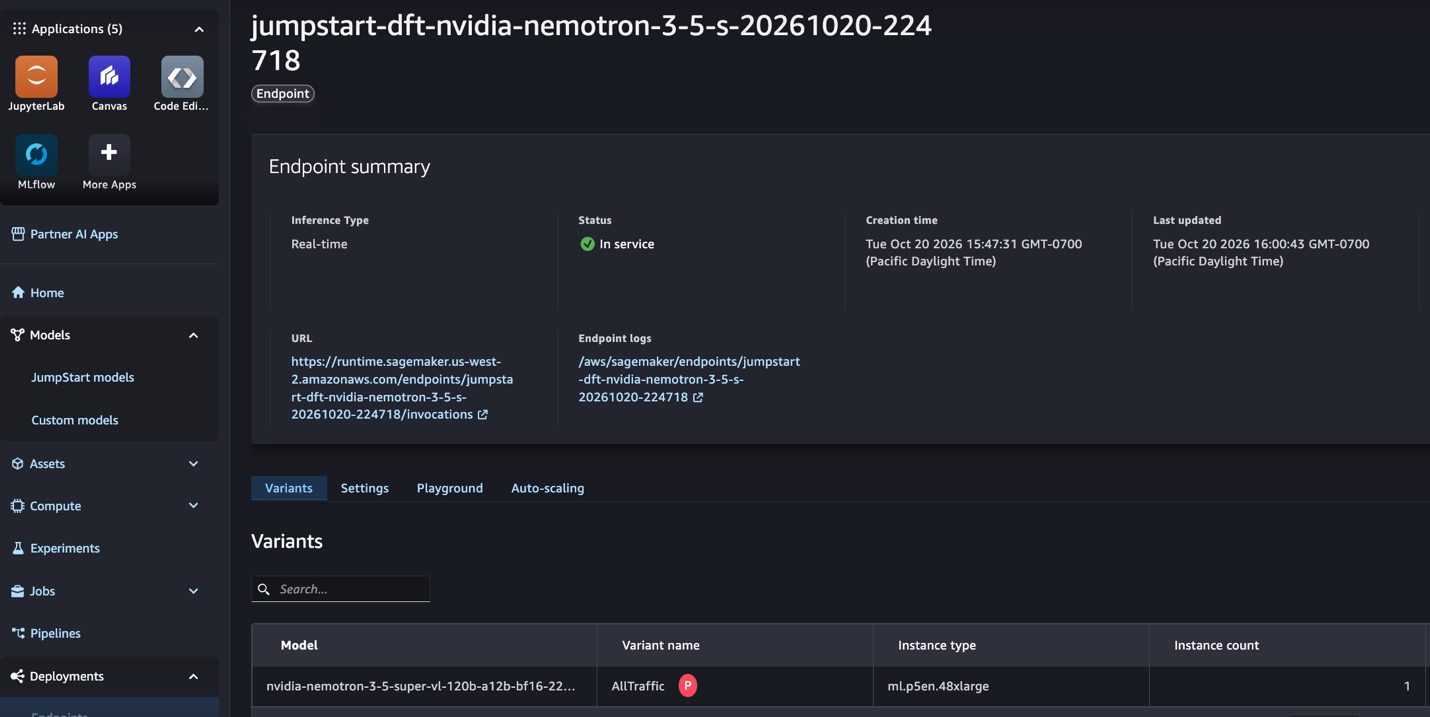
AWSが2026年11月9日に公開したブログ(著者Venu Kanamatareddy、Evan Kravitz、Naidile Murali)によると、NVIDIAのNemotron 3.5 Super VLがAmazon SageMaker JumpStartで提供開始された。ブログの説明では、このモデルはNemotron 3.5シリーズの視覚言語モデルで、画像・動画・テキストを入力としてテキストを出力する。言語バックボーンは総パラメータ120B、トークンあたり活性12Bで、88層にMamba-2とMoE(512のルーティングエキスパート、トークンあたり22を活性化)を交互に積み、8つのアテンション層を挟む。バックボーンはNemotron 3 Super Baseから初期化され、Nemotron 3 Ultra Baseから蒸留され、視覚側はC-RADIOエンコーダを使う。JumpStartは2つのバリアントを提供する。NVFP4はBF16からの量子化認識蒸留で得られ、約75GBで、RTX PRO 4500 Blackwellを搭載したG7インスタンス上で4ビットの重みと活性で実行される。BF16はフル精度の参照重みで約249GB、ml.p5en.48xlargeのH200 8枚上で動く。重みはOpenMDWライセンス契約1.1で提供され、英語、フランス語、ドイツ語、イタリア語、日本語、スペイン語、中国語をサポートする。ブログはモデルが最大100万トークンのコンテキストをサポートするとしているが、JumpStartのサービス設定は520〜15,600トークンしか開いていない。checkpointはマルチトークン予測ヘッドを備えるが、JumpStartのサービス設定では投機的デコーディングが有効化されておらず、エンドポイントはLoRAアダプタもロードしない。
開発者への影響
開発者への第一の影響はインターフェースの形にある。ブログによれば、JumpStartエンドポイントが公開するのはvLLM駆動のchat completionsインターフェースで、推論はデフォルトで有効、思考内容はメッセージのreasoningフィールドに置かれ、contentとは別に返される。つまりcontentフィールドだけを解析する既存クライアントは改修が必要で、そうしないと本文を失うか推論過程を本文と誤認する。メディアはbase64データURLでインライン送信する必要がある。エンドポイントはネットワーク分離されておりURLを取得できないためで、これによりリクエスト本体のサイズが大幅に増え、「リンクを渡してモデルにダウンロードさせる」といった手法は直接使えなくなる。 第二の影響は容量計画にある。モデルカードは最大100万トークンのコンテキストと書くが、マネージドエンドポイントのサービス設定が実際に与えるのは520〜15,600トークンで、1リクエストにつき画像1枚と動画1本しか受け付けない。1,536×1,024のページ画像は約1,536トークンを消費し、ブログもモデルは生のPDFではなく画像を受け取ると明言しているため、まず各ページを画像にレンダリングする必要がある。これに基づくと、数十ページのPDFはこのマネージド経路では一度に送れず、ページごとにリクエストするか、複数ページを1枚の画像に結合してコンテキスト予算を圧縮するしかない。 第三の影響は遅延の見込みにある。ブログの測定では、generate設定(入力250トークン、出力1,500トークン、5並列ストリーミング)でG7上のNVFP4は1リクエストあたり約63トークン/秒、最初のトークンまで約0.45秒。しかし同じg7.24xlargeでもsummarize設定の入力10,000トークンでは最初のトークンが12.62秒になる。画像・動画リクエストは通常長いプロンプト側に落ちるため、対話型GUIエージェントに使う前にこの最初のトークンの桁を一度測っておく価値がある。 品質面では、ブログはNVIDIAのモデルカードにある5つのマルチモーダルベンチマーク(推論有効)を引用する。MMLongBench-Doc 62.82対62.82、OCRBench v2英語68.12対68.34、CharXiv reasoning 80.82対79.88、Video-MME v2 32.85対32.54、OSWorld-Verified 51.14対52.30で、前者がBF16、後者がNVFP4。ブログは評価設定を揃え、異なるのはcheckpointのみとしている。これらはベンダー自己申告の数字で、第三者の再現は見られない。
導入と評価の提案
以下3点は報道された事実に基づく条件付きの提案であり、検証済みの結論ではない。 第一に、まずバリアントを決める。報道された変化は、JumpStartがNVFP4とBF16の2つのcheckpointを同時に提供し、NVFP4がデフォルトでml.g7.24xlargeから始まり、BF16はml.p5en.48xlargeのみという点だ。すべき選択は、純粋な推論サービスならまずNVFP4を使うこと。SFT、強化学習、蒸留、ドメイン適応、カスタム量子化を行う場合に限り、BF16参照重みをダウンロードして自前構築する。この選択を変える鍵となる前提は微調整の必要性だ。ブログはエンドポイントが基礎重みのみを提供しLoRAアダプタをロードしないと明言しており、LoRAのホットスワップに依存する方案ならマネージド経路はそもそも成立しない。測定可能な判断基準は、自分の文書スクリーンショットと動画クリップを同じ入力群で2つのcheckpointに走らせ、タスク精度とJSON出力準拠率の差を比較し、許容差を既存の人手レビュー率に対応する誤差水準以下に定めることだ。 第二に、コンテキストより先にサービス設定を決める。報道された変化は、inference_config_nameがモデル長を決めること。generate 2,275、interact 520、summarize 13,650、modify 15,600トークンで、ブログの画像・動画・推論の例は一律modifyを使う。選択としては、画像・動画・多段推論を含むリクエストはmodify、短いテキスト抽出はgenerateを使い、「1ページ約1,536トークン」で1リクエストが何ページ扱えるかを見積もる。前提は、複数ページ文書を複数リクエストに分割するか1枚の画像に結合する必要があることだ。測定可能な判断基準は、公開前に長さ超過の拒否率とp95の最初のトークン時間を一度集計し、入力10,000トークンでの12.62秒という参考値を遅延予算の下限対照とすることだ。 第三に、推論スイッチを先に決める。報道された変化は、推論がデフォルトで有効、思考内容が別に返され、推論付きの動画リクエストではmax_tokensを少なくとも8,192に設定することが推奨される点だ。選択としては、チケットのフィールド抽出や画像説明など短く直接的な回答が必要なタスクはenable_thinking=Falseで切り、多段分析やGUI定位は残す。選択を変える前提は、タスクが本当に中間ステップを必要とするかどうかだ。測定可能な判断基準は、同じサンプル群でオンとオフのフィールド抽出精度、出力トークン数、エンドツーエンド遅延を比較し、節約したトークンが許容できる精度損失と引き換えになっているかを見ることだ。デプロイ前にml.g7のクォータ(新規アカウントは初期ゼロ)とSageMaker Python SDKが3.25以上であることを確認し、インスタンスタイプを明示的に渡す必要がある。そうしないとSDKがml.m5.largeにフォールバックし構築が失敗する。
制限と未確認事項
Nemotron 3.5 Super VLのこのバージョンは現在KimiSeekのモデルカタログにない。報道された可用性はAWS SageMaker JumpStart、つまりベンダー側のマネージドサービスを指し、本サイトに搭載済みのモデルではない。 その他の未知も同様に保持する必要がある。上記で引用した5つのベンチマークはNVIDIAのモデルカードに由来し、ベンダー自己申告の口径だ。ブログ自身が、NVFP4とBF16の性能数値は異なるGPUシステムと構成で実行されたもので、隔離された精度比較ではないと説明しているため、63トークン/秒と140.85トークン/秒から量子化損失を直接推測することはできない。モデルカードが謳う100万トークンのコンテキストはマネージドエンドポイントでは公開されておらず、実際の上限はサービス設定に依存する。動画のフレームサンプリングはエンドポイント起動時に固定され、エンドポイントはリクエストごとのmedia_io_kwargsも拒否するため、リクエストごとにサンプリングを制御したいなら自前構築が必要だ。重みはOpenMDWライセンス契約1.1で提供され、オープンウェイトはオープンソースライセンスと同義ではなく、商用利用、再配布、派生モデルの条項はライセンス原文を読む必要がある。原文は価格を示しておらず、費用は選択したインスタンスに応じ、具体的にはAWS SageMakerの料金ページによる。中国語はサポート言語リストに含まれるが、原文は中国語シーンのベンチマークデータを示していない。
元の報道の図版