NVIDIA、Nemotron 3.5 Bolt E4Bを発表:4GB VRAMを狙うローカルエージェント、ツール呼び出しベンチマークはQwen3.5-4Bに劣る
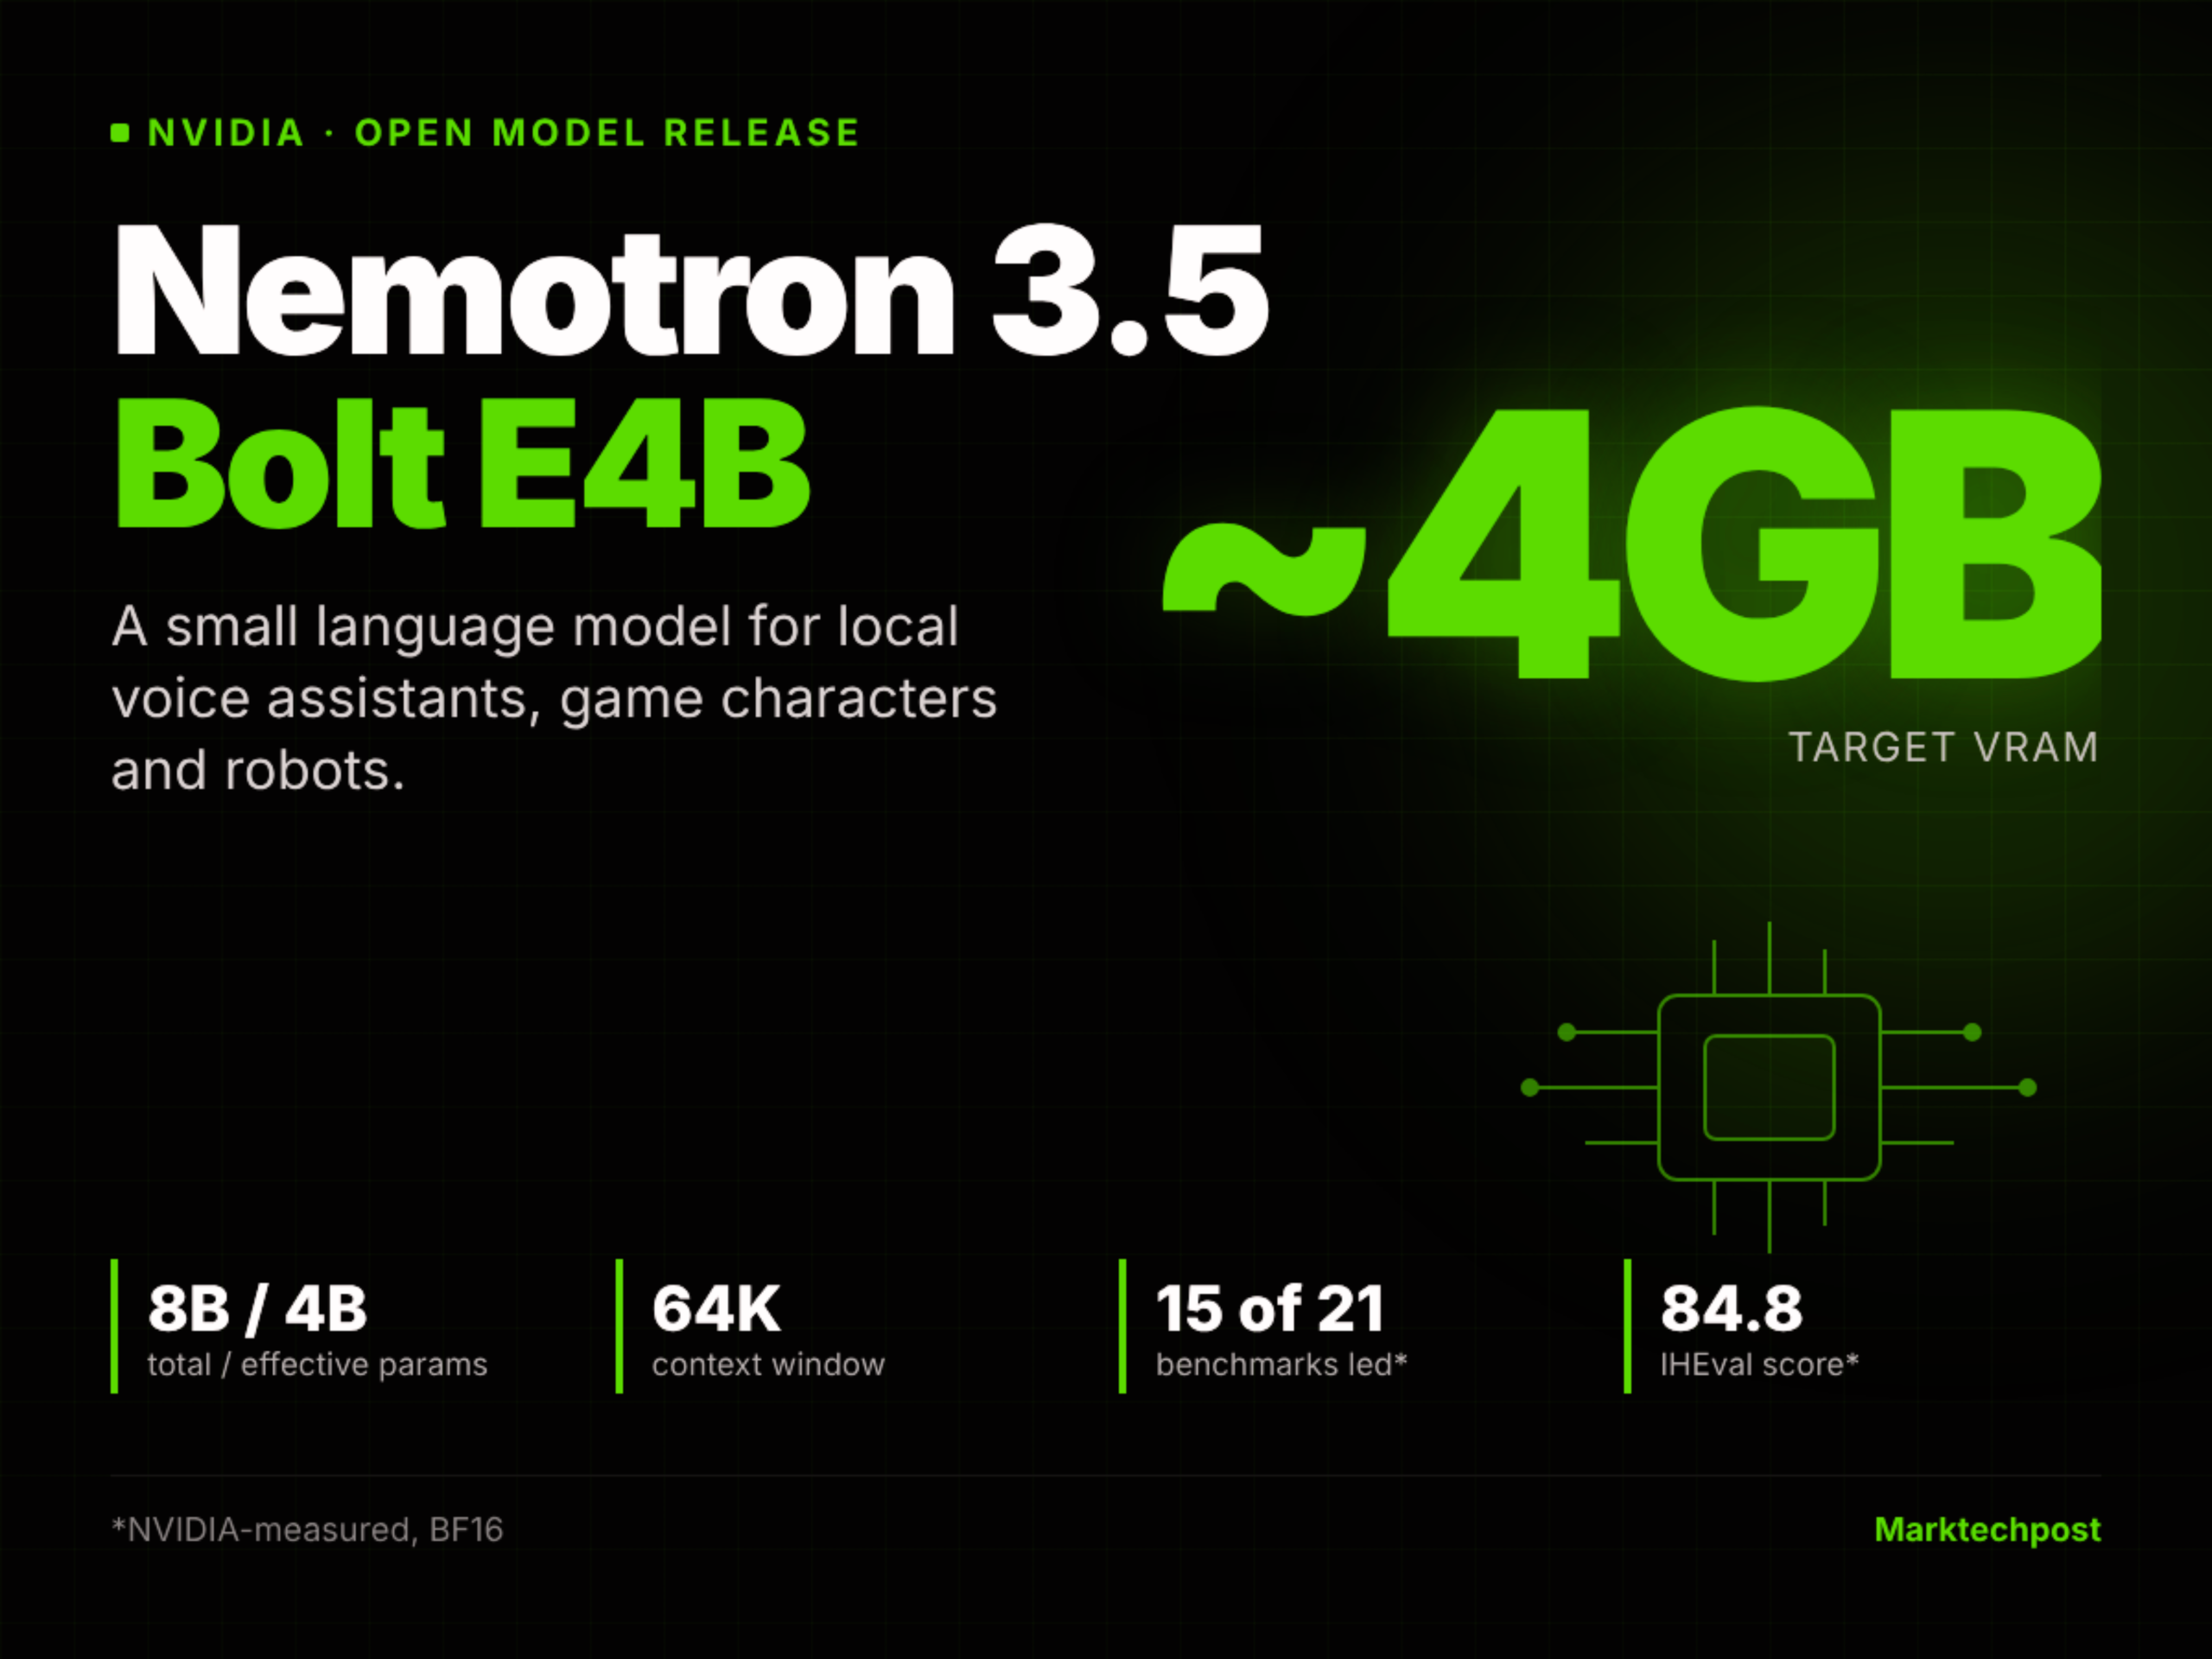
MarkTechPostの2026年10月23日の報道によると、NVIDIAはオープンウェイトモデルNemotron 3.5 Bolt E4Bを発表した。Gemma 4 E4Bを強化学習のみでポストトレーニングしたもので、総パラメータ80億、有効パラメータ40億、コンテキスト64K。ローカル音声アシスタント、ゲームNPC、ロボット向けとされる。ベンダー自己測定の21ベンチマーク中15項目で首位だが、Tau2-Benchは55.1でQwen3.5-4Bの75.1に劣る。
主な変更
MarkTechPostの2026年10月23日の報道によると、NVIDIAはNemotron 3.5 Bolt E4Bを発表した。GoogleのGemma 4 E4Bを出発点とし、教師あり微調整を完全に省略、RLVRとRLHFのみでNeMo-RL、NeMo-Gymを用いてポストトレーニングしている。各学習サンプルで推論モードと非推論モードの両方を同時に実行し、バッチ内の非推論サンプルと推論サンプルの比率を2:1に保ち、GenRM環境の長さペナルティで回答の長文化を抑制する。データセットとレシピは公開されている。モデルは総パラメータ80億、有効パラメータ40億、コンテキスト64Kで、マルチターンのツール呼び出しと非同期ツール呼び出しの指針に対応し、conversational_modeフラグで音声向けの短い応答を生成する。推論能力と実行時の思考予算は設定可能。報道ではNVIDIA ACEのゲームキャラクター向け第3世代の小型モデルとされ、Jetson Orin Nano 8GB上で動作するReachy Miniロボットのデモも示されている。そこではCosmos 3 Edgeが視覚、Boltが音声応答とツール呼び出しを担う。 デプロイ面では、NVIDIAはBF16チェックポイントを重要度行列でキャリブレーションしてQ4_K_Mに量子化した。キャリブレーションには約100万トークンのRLロールアウトを用い、投機的デコード用のDFlashドラフターも同梱する。報道によるとRTX 5070上でBoltは272.6 tokens/s、Gemma 4 E4BとそのMTPドラフターの組み合わせは225.9 tokens/s。ハードウェア実測(Q4_K_M、llama.cpp、バッチサイズ1、入力3K・出力50トークン)では、RTX 5070がVRAM 3.5GB、初回トークン548ミリ秒、133.4 tokens/s。Jetson AGX Orin 32GBが4.2GB、3687ミリ秒、24.0 tokens/s。Jetson Orin Nano 8GBが4.2GB、5785ミリ秒、15.5 tokens/sだった。報道は「4GB」が目標とするVRAM帯でありファイルサイズではないと強調している。Hugging Face上のQ4_K_M GGUFは6.18GBだ。 モデルはOpenMDW-1.1ライセンスで重みを公開し、データとレシピも公開されている。Hugging Face、Ollama、LM Studio、Unsloth、Jetson AI Labで提供され、NVIDIA NIMとIn-Game Inferencing SDKの形態でも提供される。NVIDIA公式ホスティングプラットフォームでは無料APIも利用できる。ベンチマークについて、報道のスコアはすべてBF16でNVIDIAが自社のNeMo-Gymフレームワークで測定したものだ。21項目中15項目で最高で、IHEvalは84.8(Gemma 4 E4Bは67.0、Qwen3.5-4Bは60.6)。Tau2-Benchは55.1でQwen3.5-4Bの75.1に劣り、RULER 64Kは87.0でQwen3.5-4Bの95.1を下回る。LongBench v2(50.5対59.9)とBFCL-v3(68.5対70.9)もQwen3.5-4Bがリードし、Gemma 4 E4BはEQ-Bench v3で41.1対39.4とわずかに上回る。報道はNVIDIAの主張も伝えている。平均スコアはNemotron 3 Nano 4Bより約40%高く、推論を有効にした比較では出力トークンが最大80%削減されるという。
開発者への影響
開発者への直接的な影響は主にVRAM予算とタスクの分担の2点にある。報道のVRAM数値はモデル単体の推論のもので、音声認識、音声合成、視覚モデルは含まない。報告にあるJetson Orin Nano 8GBのデモを参考に構成する場合、モデル自体が4.2GBを占めるため、残りの余裕でどのくらいの規模の知覚モデルを載せられるか、画像解像度を上げられるか、16GB以上のデバイスに切り替える必要があるかが決まる。初回トークン時間の差も重要だ。RTX 5070の548ミリ秒とOrin Nanoの5785ミリ秒ではインタラクション体験がまったく異なり、後者は自然な相づち型の対話というよりターン制に近い。 能力の分布から、汎用小型モデルではなく専用部品として扱う方が適している。NVIDIAは5つの能力領域の21ベンチマークで15項目のみリードを主張しており、負けた項目は長いコンテキストとエージェントのツールチェーンに集中している。Tau2-Bench、RULER 64K、LongBench v2、BFCL-v3はいずれもQwen3.5-4Bに敗れている。逆にIHEval 84.8のような指示追従スコアは強みで、conversational_modeも短く速くそのまま読み上げられる応答を意図した設計を示す。総合すると、複雑なマルチターン計画や超長コンテキスト検索の既定の選択肢ではなく、「対話と軽量なツール呼び出し」の候補だ。 判断には測定条件の違いも織り込む必要がある。上記スコアはすべてベンダーが自社のテストフレームワークで測定したもので、第三者による再現とは差が出る可能性がある。報道はさらに、Scale LabsがMultiChallengeで56.03%を示し、NVIDIAの自己申告53.1を上回ったとも伝えている。同じ記事内に2種類の数値が併存することは、特に自社の業務分布がベンチマーク分布と一致しない場合、単一のスコアを断定の根拠にできないことを示す。
導入と評価の提案
以下は報道に基づく条件付きの提案と条件分析であり、検証済みの結論ではない。 判断1:対象デバイスのVRAM余裕に応じて量子化バージョンとデプロイ形態を決める。8GB級のJetsonや12GBのGPUで、音声と視覚モデルを同時に動かす必要があるなら、まずQ4_K_Mとllama.cppの組み合わせを検証するとよい。報道の4.2GBの占有と6.18GBのファイルサイズは、重みファイル自体は「4GB」予算に収まらず、量子化された実行形態が実用的な形であることを示す。測定可能な判断基準は具体的だ。自分の入力長(報道は入力3K・出力50トークン)で初回トークン遅延とtokens/sを測り、知覚モデルを重ねても余裕が残るか確認する。初回トークンが対話設計の許容上限を超えるなら、プロンプト調整を続けるのではなく、より小型かより攻めた量子化段階に切り替えるべきだ。 判断2:ワークロードがツール呼び出し中心かどうかで、Boltを登場させるかを決める。製品が音声アシスタント的な短い対話と少数のツール呼び出しなら、conversational_modeと64Kコンテキストは試す価値がある。中核がマルチターンで状態を持つ長いツール軌跡なら、報道のTau2-Bench 55.1対75.1の差は、まずQwen3.5-4Bでベースラインを築くべきだという示唆になる。測定可能な判断基準は、自社業務のマルチターンツール呼び出し軌跡を固定の評価セットにまとめ、同じ関数定義の下でタスク完了率と平均呼び出しターン数を比較することだ。単一ターンの回答が流暢かどうかだけを見てはいけない。 判断3:実行時の思考予算はスイッチではなく、キャリブレーションが必要なパラメータとして扱う。報道ではモデルが設定可能な推論と実行時の思考予算に対応し、推論を有効にした比較で出力トークンが最大80%削減される(ベンダー主張)としている。つまり同じ重みでも推論オンとオフでは遅延と品質の曲線が別物になる。音声経路には遅延予算を設定し、その範囲で二者択一し、出力トークン数と初回パケット時間を測定指標にして、トークン削減の主張が自社のタスク分布で成り立つか検証するとよい。 判断4:ライセンスは別途確認が必要だ。報道では重みはOpenMDW-1.1で公開され、基盤のGemma 4 E4BはApache 2.0であり、両者の条項は同じではない。重みを製品に組み込む前に、ライセンス本文を直接読んで配布、帰属表示、商用条件を確認すべきで、「オープンウェイト」といったラベルから権利を推測してはいけない。
制限と未確認事項
本記事で述べるNemotron 3.5 Bolt E4Bは現時点でKimiSeekには掲載されておらず、サイト内のモデル一覧に対応する項目はない。報道に登場する無料APIはNVIDIA公式ホスティングプラットフォーム上での同モデルの可用性を指し、当サイトとは無関係だ。実際の可用性と条件はベンダーのドキュメントに従う必要がある。 既知の限界は次の通り。報道のベンチマークスコアはすべてBF16で、NVIDIAが自社のNeMo-Gymフレームワークで測定したものであり、独立した再現ではない。平均スコアがNemotron 3 Nano 4Bより約40%高いこと、推論有効時に出力トークンが最大80%削減されることは、いずれもベンダーの自己申告だ。速度比較にも測定条件の違いがある。272.6対225.9 tokens/sはRTX 5070上でBoltにDFlashドラフターを組み合わせた場合とGemma 4 E4BにMTPドラフターを組み合わせた場合の結果で、ハードウェア表の133.4 tokens/sとは条件が異なり、そのまま置き換えて使うことはできない。MultiChallengeではNVIDIAが53.1を自己申告し、報道が伝えたあるX投稿ではScale Labsが56.03を示したとされ、2つの数値はそれぞれ出所を明記する必要がある。ライセンス面ではBoltはOpenMDW-1.1で公開され、基盤のGemma 4 E4BはApache 2.0であり、オープンウェイトは同等の商用条件を意味しない。ハードウェアデータはRTXとJetsonの4機種のみで、他のプラットフォームのデータはない。入力形態について、報道の比較表ではBoltのモデルカード上の入力はテキストで、NIM形態は画像と音声も受け付ける。実際に利用可能なモダリティと制限は公式ドキュメントに従う必要があり、報道はこれらのモダリティの評価データを示していない。