Reflection Beam のオープンウェイト 501B モデル公開:Apache 2.0 の重みと AWS 上の 2 つのデプロイ経路
AWS が 2026 年 10 月 16 日に公開したブログによると、Reflection AI はオープンウェイトモデル Beam を発表した。エージェント型コーディングと長期タスク向けで、総パラメータ数 501B、活性パラメータ数 23B、報告されている有効コンテキスト長は 100 万トークン。重みは Apache 2.0 で Hugging Face を通じて公開され、BF16/FP8/NVFP4 のチェックポイントが提供され、SageMaker JumpStart と HyperPod の 2 つのデプロイ経路が示されている。
主な変更
AWS 公式ブログの 2026 年 10 月 16 日付の報道によると、Reflection AI はオープンウェイトモデル Beam を発表した。エージェント型コーディングと長期タスク(コードの保守、ツール呼び出し、結果の解釈、複数ステップのワークフロー完了など)を想定している。このモデルはスパースな Mixture-of-Experts(MoE)構造で、総パラメータ数 5010 億、活性パラメータ数 230 億、Reflection が報告する有効コンテキスト長は 100 万トークンである。Reflection は Hugging Face を通じて Apache 2.0 ライセンスで Beam の重みを公開しており、Beam 1.0 は BF16、FP8、NVFP4 の 3 種類のチェックポイントを提供し、異なるメモリ使用量とハードウェアに対応する。公開時点で、このモデルは Amazon SageMaker JumpStart で、米国東部(バージニア北部)とオハイオの 2 リージョンで提供されている。ブログは 2 つのデプロイ経路も示している。SageMaker JumpStart のリアルタイムエンドポイント(フルマネージド)と、SageMaker HyperPod Inference(JumpStart のマネージドコンテナ、またはカスタムの SGLang、vLLM と組み合わせる)である。記事では精度別のインスタンス選択の指針も示されている。FP8 には H100 の ml.p5.48xlarge または H200 の ml.p5e/ml.p5en.48xlarge、NVFP4 には B200 の ml.p6-b200.48xlarge を使用し、BF16 の重みはメモリ要件が最も大きく、マルチノードの計画が必要であると強調している。併記すべき点として、これは同ブログの報道内容であり、KimiSeek はモデル能力、インスタンス対応、リージョン可用性について独自の検証を行っていない。
開発者への影響
開発者にとっての直接的な意味は次のとおりである。これはオープンウェイトの公開であり、Apache 2.0 ライセンスと宣言されている点で、単に「重みがダウンロード可能」であるよりもライセンス面では明確だが、ライセンス上の権利は依然として Hugging Face のリポジトリと規約の文言に基づくべきであり、「重みが入手可能」であることから商用利用、再配布、派生トレーニングの許諾範囲を逆算してはならない。エンジニアリング面では、501B/A23B のスパース構造は、VRAM とデプロイコストが総パラメータ数で決まり、1 トークンあたりの計算は 23B 活性規模に近いことを意味する。したがって、重みのメモリ、シャーディング、並列配置が第一の制約となる。BF16 はマルチノードで VRAM を集約する必要があり、FP8 と NVFP4 は実現可能なハードウェアを H100/H200 と B200 の特定インスタンスに狭める。デプロイ形態には実際のトレードオフがある。JumpStart のリアルタイムエンドポイントはモデル、コンテナ、エンドポイントをマネージドワークフローとして包み、迅速な検証に適する。HyperPod はクラスタとランタイムを公開し、イメージダイジェスト、Beam のコミット SHA、並列パラメータを固定できるため、性能結果の再現やカスタム量子化、パーサーが必要なチームに適する。ブログが言及する 100 万トークンの有効コンテキストは KV キャッシュの予算とバッチ処理戦略に影響し、長コンテキストでの VRAM 使用量は推定ではなく実測が必要である。評価に関しては、このモデルはマルチステップのツール呼び出しを想定しているため、単一ターンの Q&A ベンチマークでは実際のエージェントループでの性能を説明するには不十分であり、代表的なコーディングとツール使用リクエストで負荷を構成する必要がある。
導入と評価の提案
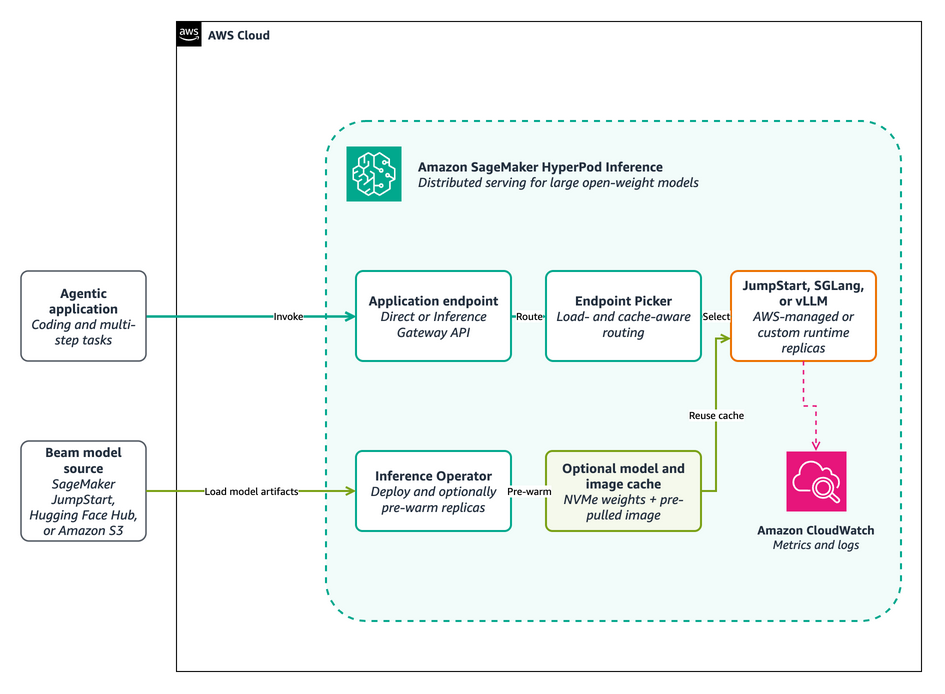
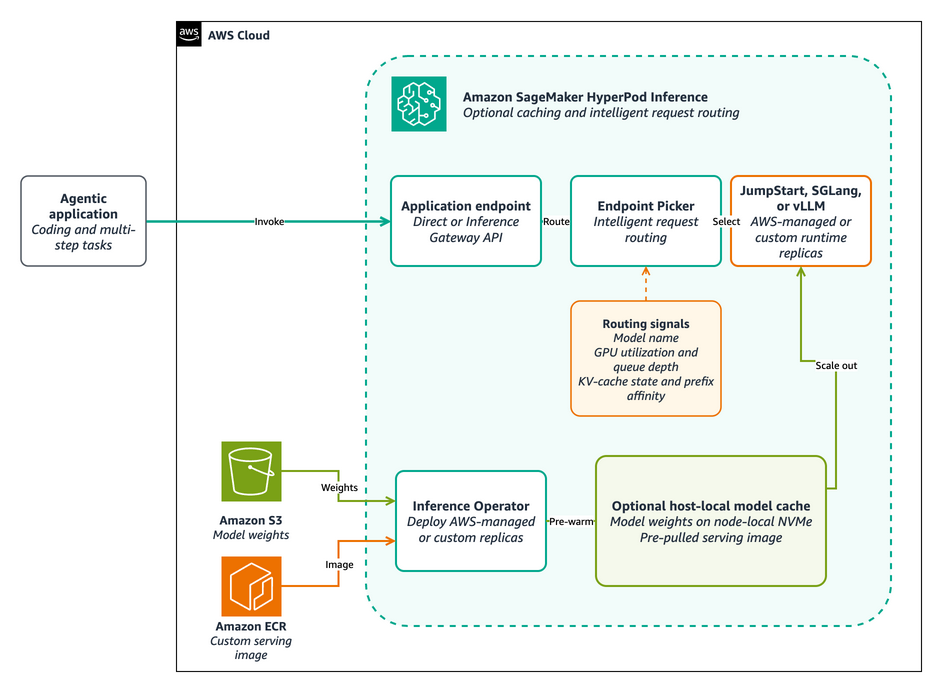
以下は同ブログに基づく評価上の提案であり、検証済みの結論ではない。第一に、「マネージドか自己管理か」を先に決める。統合をできるだけ早く通したい、チームに Kubernetes 運用能力がない場合は、JumpStart のリアルタイムエンドポイントで有界なライフサイクル(デプロイ、単一リクエスト、クリーンアップ)を実行し、成功条件をエンドポイント準備完了後に公開されたリクエストスキーマに適合する応答を返すこととする。ランタイムパラメータ、量子化、カスタムパーサーを固定する必要がある場合にのみ、HyperPod 上の SGLang や vLLM に移行し、このときイメージダイジェスト、モデルリビジョン、並列設定の再現性を合格条件とする。第二に、精度ごとに容量を 1 回判断する。単一レプリカの重み、KV キャッシュ、ランタイムオーバーヘッドで集約 VRAM を見積もり、負荷テストで補正する。目標コンテキストが報告された有効上限に近い場合は、まず長コンテキストでの p95 初回トークン時間と出力トークンあたりの時間がレイテンシ予算を満たすか検証し、NVFP4 や FP8 を使う場合は出力品質の劣化がないか再確認する。第三に、エージェントシナリオ用に測定可能な受け入れラインを設ける。実際のコード修正とマルチステップのツール呼び出しリクエストで、想定同時実行数に応じて負荷を繰り返しかけ、成功率、p50/p95 初回トークン時間、エンドツーエンドレイテンシ、集約出力スループットを記録し、モデルバージョン、イメージダイジェスト、精度、コンテキスト長、キャッシュ状態を併せて文書化する。そうしなければ構成間の比較は不可能である。第四に、小規模で検証してから拡張する。選択したインスタンスタイプのサービスクォータとリージョン容量を確認し、イメージ転送、重みのダウンロード、シャード読み込みがかなりのコールドスタート時間を占めることに注意し、キャッシュと自動スケーリング戦略は事前設定ではなく実測に基づくべきである。第五に、テスト完了後は公式の例に従ってエンドポイント、クラスタ、キャッシュされた重み、一時的な IAM リソースをクリーンアップし、継続課金を避ける。
制限と未確認事項
今回の発表に対応する Beam 1.0(501B/A23B)は現在 KimiSeek には掲載されていない。したがって本文で述べたデプロイ経路、呼び出し方法、可用性はいずれも Reflection AI と AWS の公開チャネルを指し、当サイトのサービスではない。KimiSeek 上の Kimi K3、GLM、Qwen、DeepSeek などは別のモデルであり、本バージョンの可用性の証拠にはならない。本報道は AWS ブログの単一ソースに基づいており、KimiSeek はパラメータ数、有効コンテキスト長、Apache 2.0 ライセンスの実際の適用範囲、各チェックポイントのハードウェア互換性、米国東部 2 リージョンの可用状態、モデルのベンチマーク性能を独自に検証していない。ブログは公開されたコーディングまたはエージェントのベンチマークスコアを提供しておらず、能力に関する主張は検証済みの事実と見なすべきではない。オープンウェイトは完全なオープンソースと同義ではない。ライセンス条項、トレーニングデータ、再現資料は Hugging Face リポジトリと Reflection の公式声明に基づく必要がある。本文で言及した HyperPod のキャッシュ、ルーティング、ゲートウェイ機能は 2026 年の SageMaker の機能範囲に属し、その動作はバージョンによって変わるため、対応するドキュメントを参照すべきである。インスタンスタイプとリージョンも時間とともに調整される可能性がある。コストについては、Reflection AI、Hugging Face、AWS それぞれの価格または課金ページに基づくべきであり、価格とクォータは変動する。また、ブログのサンプリングパラメータ(temperature や top-p など)はあくまで例示的な開始値であり、推奨設定を意味しない。
元の報道の図版