Reflection BeamとMistral Large 4が同時期に登場:オープンウェイトの選択肢は増えるも、重みとライセンスは未確定
InfoQ中国語版の2026年10月の報道によると、10月5日から6日にかけて、米国のReflectionが初のオープンウェイトMoEモデルBeamを発表し、フランスのMistralがこれまでで最大となるMistral Large 4を投入した。報道では、Beamは推論効率を売りとし、一部ベンチマークでGLM-5.2に近いが中国の最新世代には劣るとされ、Large 4はAPIプレビューを開放済みで完全な重みは10月末に公開予定とされている。両バージョンとも現在KimiSeekには掲載されていない。
主な変更
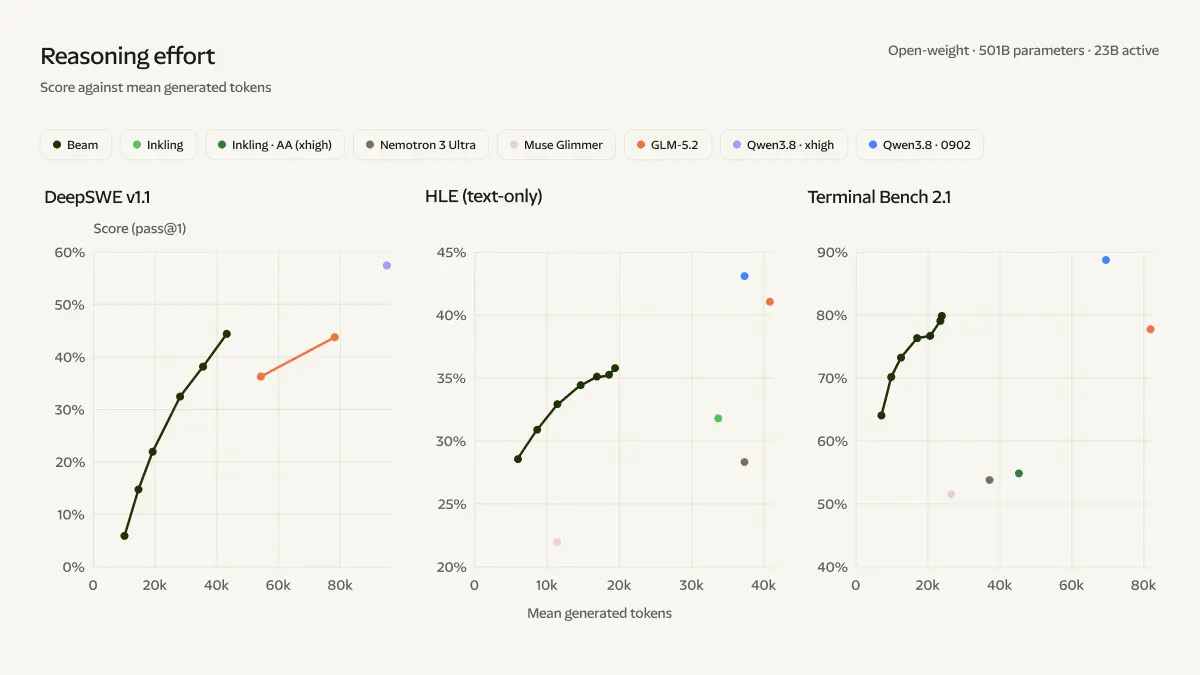
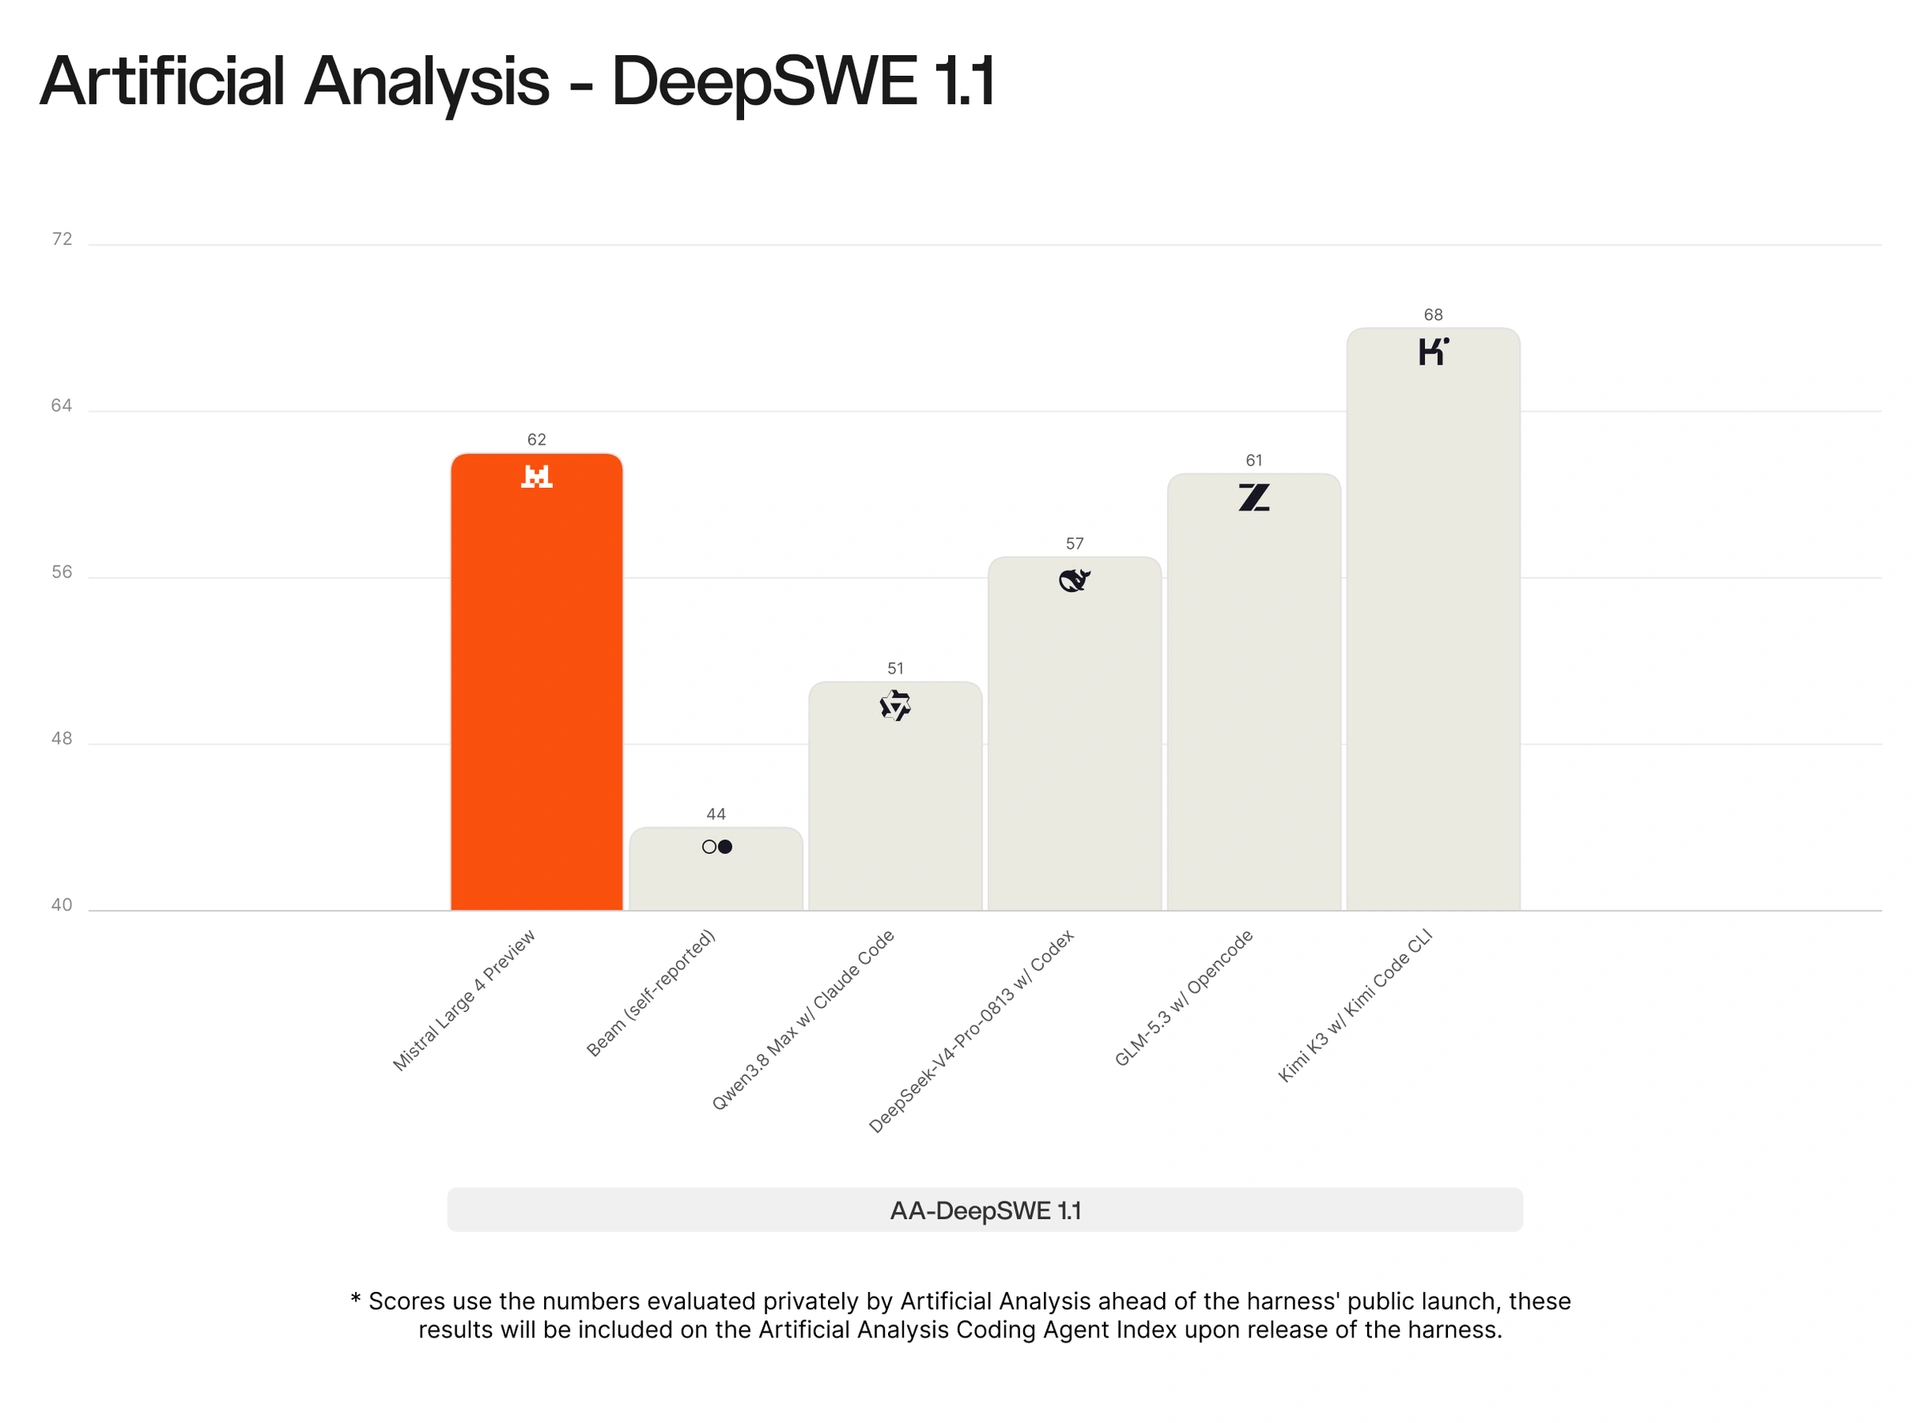
InfoQ中国語版の報道(原文は現地時間10月5日から6日と記載)によると、米国のスタートアップReflectionが初のオープンウェイトモデルBeamを発表し、その翌日、フランスのMistralがMistral Large 4を発表した。報道によれば、BeamはMoEモデルで、総パラメータ5010億、トークンあたり230億を活性化し、コーディング、推論、エージェントワークロード向けであり、23.8兆トークンで事前学習され、1万500枚のNvidia GB300を用いて4週間連続で高負荷の強化学習を行い、1億回以上のロールアウトを生成した。公開時点では最終的なレッドチーミング段階にあり、Reflectionは10月に重み、技術レポート、開発ツールを公開する予定と報じられた。Mistral Large 4は、活性化520億、総パラメータ1.05兆で、16億パラメータのビジョンエンコーダを含み、ネイティブマルチモーダルで160以上の言語をサポートし、コンテキストウィンドウは100万トークンとされ、欧州のデータセンターで約3800枚のNvidia Grace Blackwell GPUを用いてゼロから学習されたとされ、報道時点でAPIプレビューが開放され、完全な重みは10月末に公開予定とされた。報道が伝えたベンチマークデータでは、BeamはDeepSWE v1.1で44.4、Terminal Bench v2.1で80.1を記録し、いずれも報道に列挙されたGLM-5.3、Kimi K3、DeepSeek V4.1 Flashの成績を下回った。Humanity's Last ExamではBeamは36.2で、同時に記載されたGLM-5.3の42.3とKimi K3の46.9を下回った(原文はDeepSeek V4.1 Flashの同項目のスコアを記載していない)。Mistral側では、報道によればLarge 4は公式のCoding Agent IndexでDeepSeek V4 ProとQwen 3.8 Maxを上回り、Kimi K3を下回り、AutomationBenchではKimi K3、MiMo-V2.6-Pro、DeepSeek V4 Proを上回り、GLM-5.3を下回った。これらのスコアはそれぞれベンダーの自己申告またはベンダーが引用した第三者テストに由来し、報道による伝聞であり、独立した再現はされていない。
開発者への影響
この一連の発表が変えるのは、オープンウェイト陣営の候補集合と比較の座標であり、中国モデルの入手可能性を直ちに変えるものではない。最も工学的な意味を持つ点は、ReflectionがBeamの売りを絶対的な能力から「単位推論計算量あたりどれだけの知能を得られるか」へ移したことである。報道によれば、一部の高度な推論タスクではGLM-5.2の約4分の1から3分の1の計算量で近い性能に達することができるとされる。この主張が自社の負荷で成立するなら、影響を受けるのは長鎖エージェントとバッチ推論のタスクあたりのコスト構造である。しかし、報道が伝えたベンチマークによれば、Beamが並んだのは主に中国の前世代モデルであり、DeepSWE v1.1とTerminal Bench v2.1では原文に同時に列挙されたGLM-5.3、Kimi K3、DeepSeek V4.1 Flashを下回り、HLEでは原文に列挙されたGLM-5.3とKimi K3を下回る。したがって「より少ない計算量で近い能力を得る」と「同等の計算量でより高い品質を得る」は異なる置き換え経路であり、互いに代替できるものではない。Mistral Large 4の重点は異なる。100万トークン級のコンテキスト、ネイティブマルチモーダル、多言語に加え、報道が強調するプライベートクラウドやオンプレミス展開とカスタムセキュリティポリシーは、アプリケーション横断的な企業ワークフローやデータ境界を自ら制御する必要があるシナリオを指し、純粋なコーディングベンチマークの競争ではない。概念を区別する必要がある。両社ともオープンウェイトと説明されているが、報道では重みの入手時点が異なり、公開時点で両者とも実際に重みを開放していない。オープンウェイトとはダウンロード可能なモデルファイルを指し、学習データ、学習コード、ライセンス条項が開放されているかは別問題である。報道はライセンスの詳細を提供しておらず、これに基づいて商用利用、再配布、微調整の権利を推測することはできない。また、現在のカタログとの照合によれば、BeamとMistral Large 4はKimiSeekにいずれも対応するエントリがない。報道で述べられたAPIプレビューと可用性はベンダー自身のチャネルを指す。
導入と評価の提案
以下は条件付きの分析または提案であり、報道された事実ではない。第一に、主な負荷が長鎖エージェントのコーディングでコストに敏感な場合。報道によればBeamは約GLM-5.2の4分の1から3分の1の推論計算量でその性能に近づけるとされ、現在利用可能な同種の選択肢にはGLM-5.2とDeepSeek V4.1 Flashが含まれる。まず自社のマルチターンのツール呼び出しトレースで小規模な比較を行い、測定指標は「1タスクを完了するまでの総トークンとエンドツーエンド遅延」とし、報道のベンチマークで中国の最新世代を下回る水準を受け入れられることを前提とする。失敗率の上昇がリトライを引き起こす場合、計算量の節約は相殺されるため、その場合は置き換えるべきではなく、評価基準を同一タスクセットのエンドツーエンド成功率の低下が所定の閾値を超えないこととすることができる。第二に、負荷が100万トークン級のコンテキスト、マルチモーダル入力、または多言語を必要とする場合。Mistral Large 4は報道によれば100万トークンのコンテキストと160以上の言語をサポートするが、重みと最終的な条項は未定であり、まずAPIプレビュー段階で長コンテキスト検索の精度とビジョンエンコーダの自社ドキュメント上での性能を検証すべきである。測定指標は長コンテキスト質問応答の精度とリクエストあたりのコストとし、プレビュー版の挙動を将来のオープンウェイトの挙動と同一視しないことを前提とし、既存の主力モデルをフォールバックとして保持する。両方のルールは、重みが正式に公開されライセンスが明確になった後に再度見直すべきである。
制限と未確認事項
報道内容は主にベンダーの自己申告とベンダーが引用した第三者テストに由来し、ベンチマークスコアは独立した再現がされておらず、検証済みの結論と見なすべきではない。特に指摘すべきは、原文はHumanity's Last ExamについてBeam 36.2、GLM-5.3 42.3、Kimi K3 46.9のみを示し、DeepSeek V4.1 FlashのHLEスコアを列挙していない。したがってHLEの比較対象は原文が実際に列挙したGLM-5.3とKimi K3に限定すべきであり、3つのベンチマークをまとめて「いずれも3社を下回る」とするのは原文が支持しないベンチマーク横断の比較である。さらに、BeamとMistral Large 4はKimiSeekの現在のモデルにいずれも対応するエントリがなく、つまりこの2つのバージョンは現在KimiSeekに掲載されておらず、報道で述べられたAPIプレビューと重み公開計画はベンダー自身のチャネルでの可用性を指し、KimiSeekが提供するかどうかとは無関係である。重みの可用性はオープンソースライセンスと同一ではなく、報道はライセンス条項を示しておらず、商用利用と再配布の権利はベンダーが実際に公開するライセンスに従う必要がある。報道ではBeamの重みは10月に公開予定、Large 4の完全な重みは10月末に公開予定とされ、公開時点で両者とも実際に重みを開放していない。その後予定通りに実現するか、条項がどう変化するかは依然として不明である。「約4分の1から3分の1の計算量」という説明はReflectionの自己申告であり、独立した測定基準を欠き、実際の置き換え効果は自社の負荷で検証する必要がある。本ブリーフは両社の将来のロードマップやビジネスモデルの約束の履行について判断を下すものではない。
元の報道の図版