Underdog、Saluki 27Bを公開:7.89GBの2-bit Qwen3.8-27B、ツール呼び出しは原版超え
MarkTechPostが2026年10月9日に報じたところによると、Conway Research傘下のUnderdogはApache 2.0でSaluki 27Bを公開した。54GBのQwen3.8-27Bを7.89GBの2-bit混合GGUFに圧縮し、オリジナルのllama.cppで動作する。ツール呼び出しのスコアは原版を上回る一方、競技数学と多段推論は12〜18ポイント低い。
主な変更
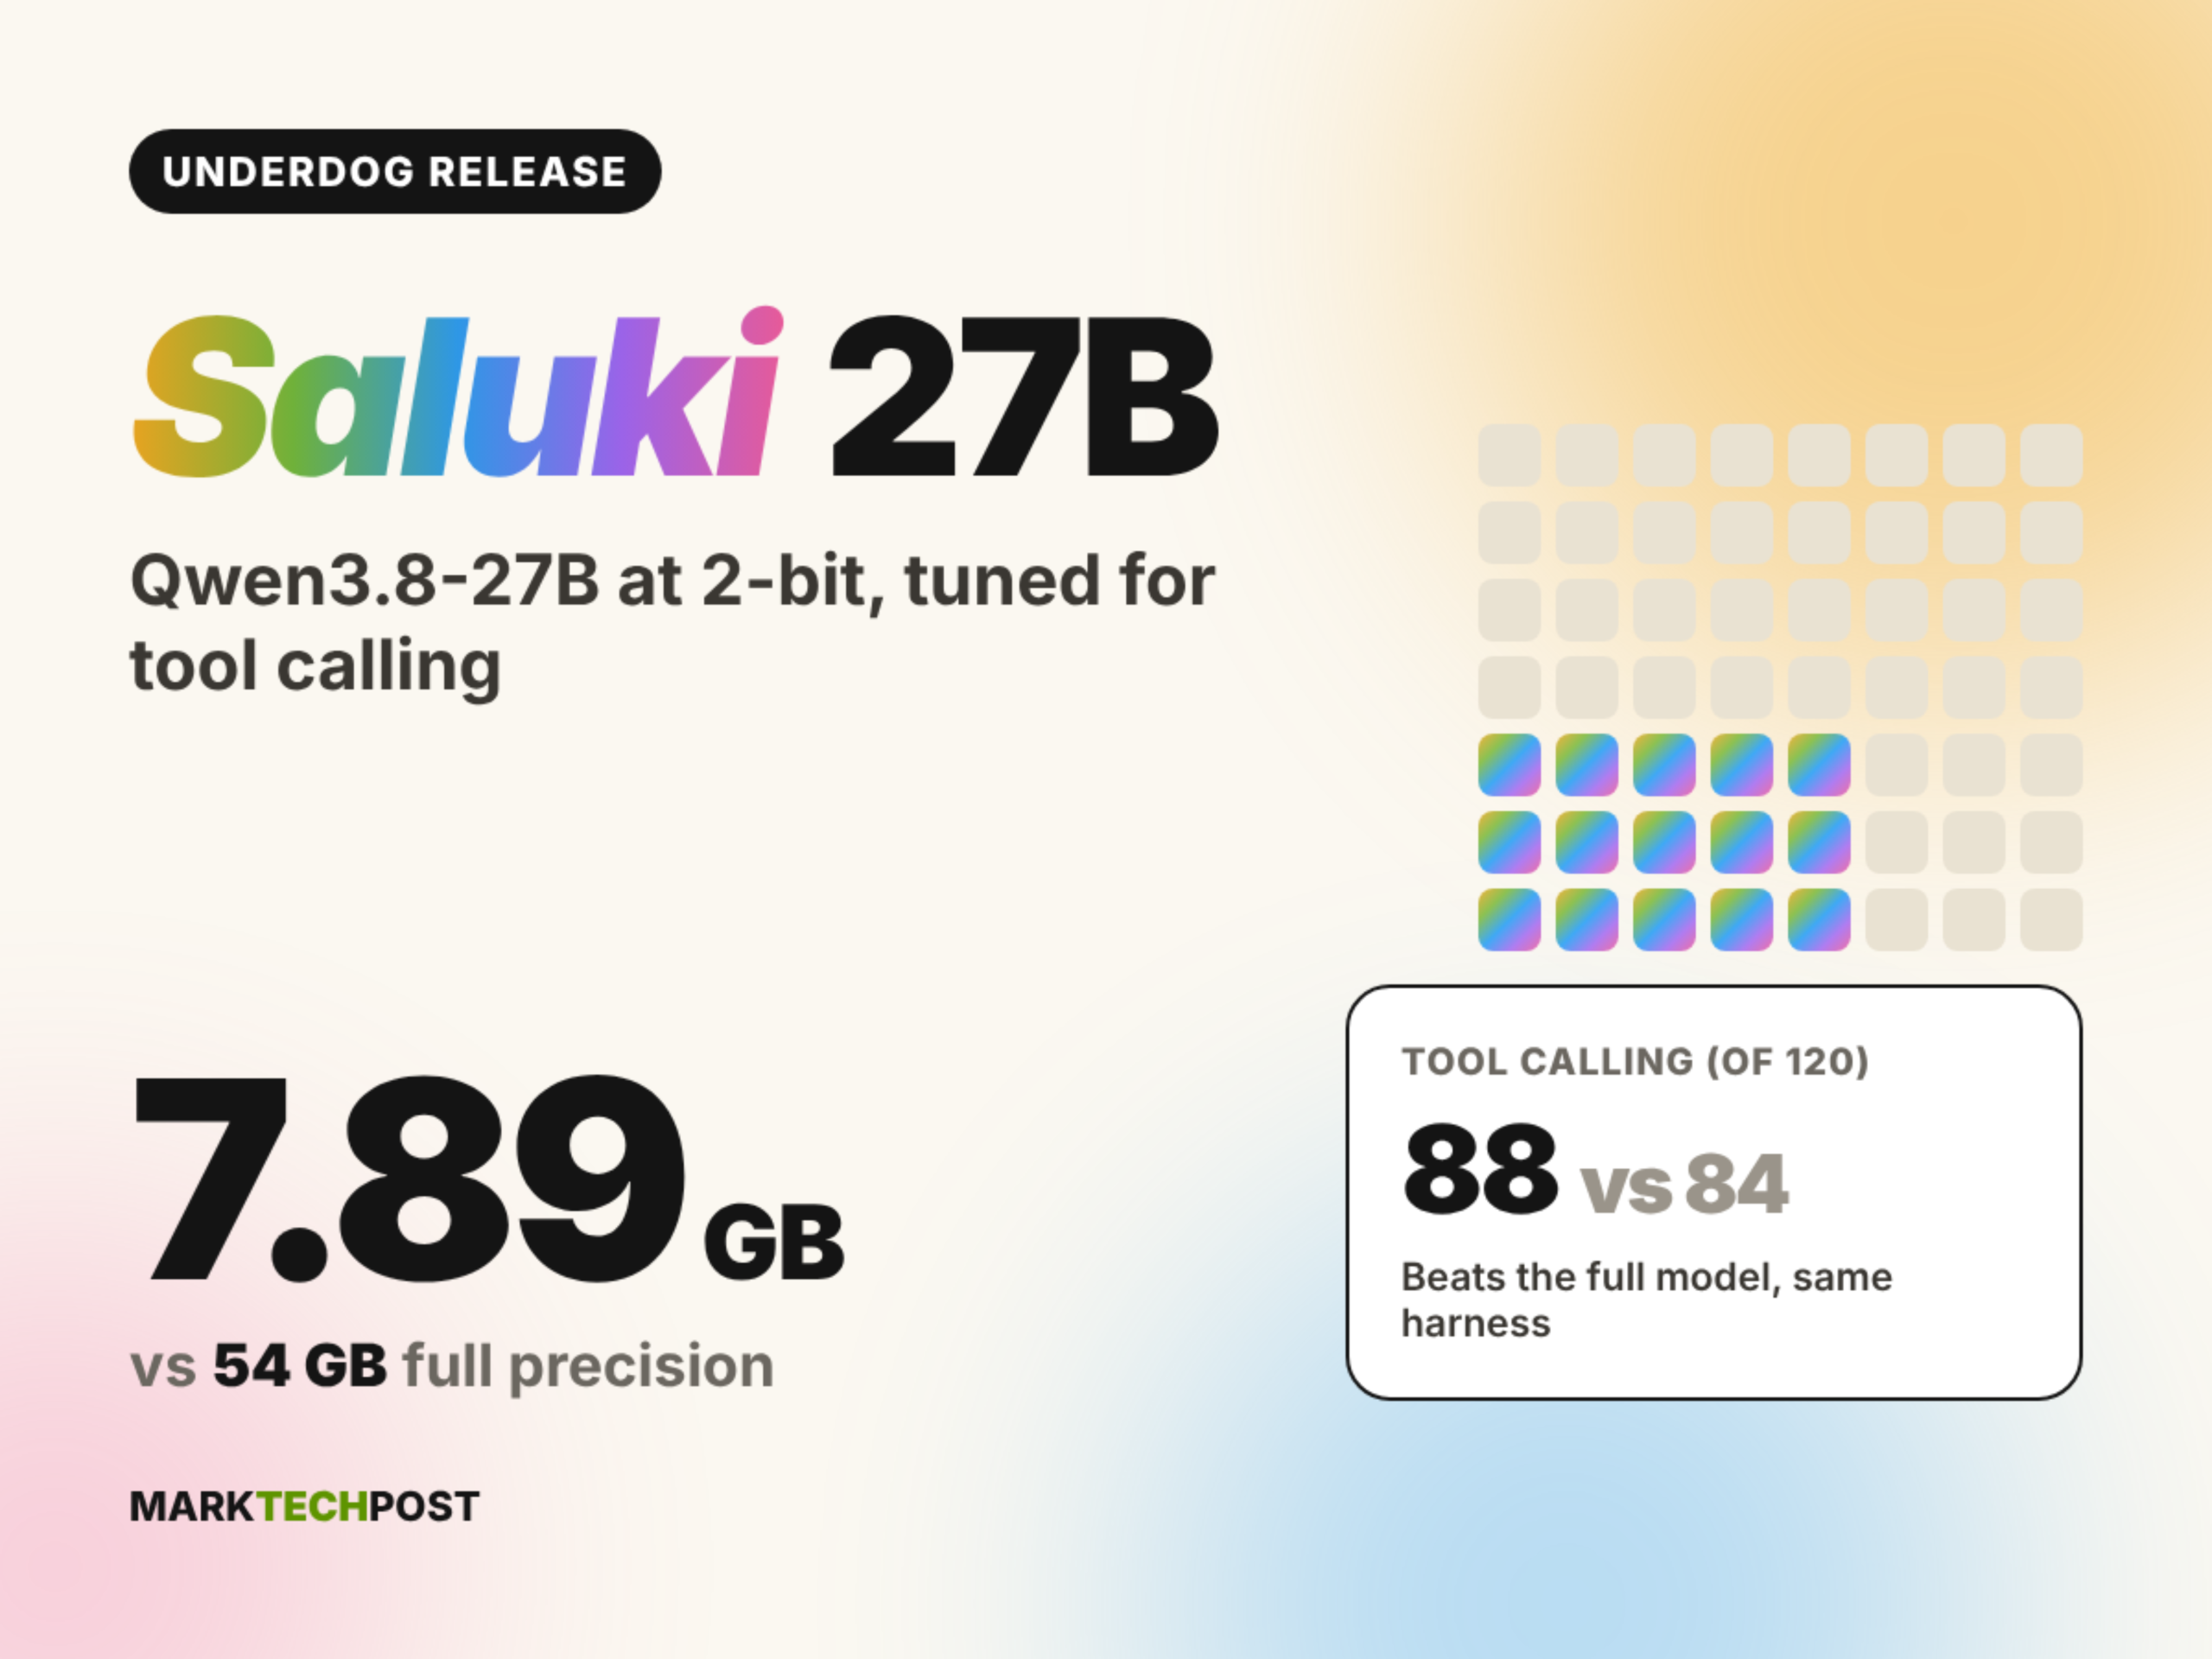
MarkTechPostが2026年10月9日に報じたところによると、Conway Research傘下のオンデバイスアシスタントプロジェクトUnderdogは、Apache 2.0ライセンスでSaluki 27Bを公開した。これはQwen3.8-27Bの2-bit混合精度GGUF版で、ファイルサイズは7.89GB、完全なBF16モデルは54GBである。報道によると、その構築は3層の作業を重ねている。基盤はQwenチームの27BデンスモデルQwen3.8-27B(64層、Gated DeltaNet線形注意とゲート付き注意の混合、ネイティブ262,144トークン)。その上にISTA-DASLabのGSQ-RCO GGUFがあり、最小ファイルIQ2_XSは8.4GB、平均2.50ビット/重み。Underdogがさらに独自の圧縮とツール呼び出し最適化を行い、IQ2-mixという名前でimatrixマーク付きのファイルを生成するが、報道はUnderdogがこの段階の完全なレシピをまだ公開していないと指摘している。実行面では、報道によればこのモデルはオリジナルのllama.cppおよびそれに基づくアプリで直接動作し、完全なGPUオフロードをサポートするほか、629MBまたは928MBのオプションのビジョン追加モジュールがある。ベンチマークについて、報道はUnderdog自身が述べた2組の結果を挙げている。完全モデルと同じフレームワークで比較した組では、Underdog Bench(BFCL v4の120タスク、思考モードオフ、temperature 0)でSalukiが88点、完全モデルが84点。並列ツール呼び出しは42対35。SWE-bench Verifiedの50イシュー中、修復は30対33。公開されているフルサイズのスコアとの比較では、IFEval 93.5対91.5、IFBench 72.7対71.0、MBPP+ 78.0対83.9、MuSR 67.5対79.6、AIME 2025 79.2対96.7、AIME 2026 80.0対94.6。報道は同時にISTA GSQ-RCO IQ2_XSとPrismML Bonsai 2 27Bを対照として挙げ、各ベンダーがそれぞれのテストフレームワークを使用しているためベンダー間のスコアは直接比較できないと強調している。Bonsai 2はより小さいがPrismMLのllama.cppブランチが必要である。
開発者への影響
ローカルエージェントを必要とする開発者にとって、このニュースの実質的な変化は次の点である。27B級のツール呼び出しモデルの重みが8GB未満に量子化され、サードパーティのllama.cppブランチなしでロードできる。これはVRAMとデプロイの敷居の判断を直接変える。単一のコンシューマー向けGPU、あるいは大容量メモリのマシンでの完全オフロードが現実的になり、「ローカルエージェントループ+リモートモデルのフォールバック」というハイブリッド構成のコストも計算しやすくなる。ただし開放重みとライセンス上の権利は区別しなければならない。報道はこのファイルがApache 2.0で公開されたと述べているが、これはライセンス面の宣言であり、商用可否は依然としてモデルカードとライセンス原文で確認すべきで、重みがダウンロード可能であること自体はライセンス許諾範囲を意味しない。さらに能力分布は均一ではない点に注意が必要である。報道によればツール呼び出しと指示追従系の指標は原版に近いかやや上回る一方、AIMEやMuSRなど数学と多段推論の指標は12〜18ポイント低下している。これはこの量子化版がツール編成、関数選択、形式制約系の負荷に適し、推論の主力として使うべきではないことを意味する。またすべてのスコアはUnderdogまたはそれが引用したベンダーの自社テストに由来し、ベンダーごとにテストフレームワークが異なるため、独立再現ではなく伝聞された主張であり、モデル間の順位は比較不能と見なすべきである。報道は重みあたりのビット数、コンテキスト長、圧縮レシピを公開しておらず、これらの未知項は長いコンテキストやバッチ並列時の実際の性能に影響する。
導入と評価の提案
提案1(ツール呼び出しルーティング):Saluki 27Bをローカルエージェントの関数選択と引数生成層として使うかどうかは、あなたの負荷が並列ツール呼び出しと構造化出力を主とするかによる。単一ターンまたは少数の並列呼び出しで、応答形式に厳格な場面なら、報道は並列ツール呼び出しと指示追従系の指標が原版に近いか上回るとしているので、まずローカルで走らせる価値がある。長い多段計画に依存する負荷なら、報道はMuSRとAIMEが明らかに低下するとしているので、原版またはより強いモデルをフォールバックとして残すべきである。測定可能な評価基準:自分のツールスキーマ上で同じ凍結タスク群を走らせ、Salukiと原版(または既存のオンラインモデル)のツール名選択精度、引数JSONの合法性、並列呼び出し場面でのタスク完了率を比較する。提案2(圧縮方式の選定):同じ2-bit帯の候補間での選択は、非オリジナルのランタイムを保守する意思があるかによる。報道はSalukiがオリジナルのllama.cppで動作する一方、PrismML Bonsai 2はそのllama.cppブランチを必要とするとし、これはビルド、アップグレード、CIの複雑さに直結する。また報道はSalukiが重みあたりビット数とコンテキストを公開していない一方、対照案は2.50ビット/重みとファイルサイズを公開しているとする。チームが推論フレームワークの分岐を望まないなら、「オリジナルのllama.cppでロード可能」を必須前提として、サイズと精度を比較する。サイズが最優先制約なら、ブランチ保守コストを受け入れる必要がある。測定可能な評価基準:同じ目標マシン上で初回トークン遅延、VRAMピーク、実際の最大入力長に近い長コンテキストでの安定性を記録し、このファイルのロードに必要なllama.cppバージョン要件を確認する。提案3(量子化後の受け入れ):どちらを選ぶにせよ、ベンチマークスコアではなく「量子化後もエンドツーエンドのタスクを完了できるか」をリリースの敷居とする。測定可能な評価基準:本番の実トラフィックのサンプルで、修復系タスクの合格数、ツール呼び出しのラウンド数、失敗リトライ率を比較し、明確なフォールバック閾値を設ける。例えばエンドツーエンドのタスク合格率が原版の許容可能な比率を下回ったら自動でフォールバックする。以上は条件付きの分析と提案であり、報道中の事実陳述ではない。
制限と未確認事項
まず明確にすべき点:報道中のSaluki 27B(Qwen3.8-27Bの2-bit GGUF派生版)は現在KimiSeekのモデルディレクトリに存在しない。この報道が述べる配布方法はHugging FaceなどのチャネルでGGUF重みを取得し、オリジナルのllama.cppでローカル実行するもので、KimiSeekプラットフォーム上のAPI可用性には触れていない。API可用性に関するいかなる記述も公開元自身のチャネルを指す。次に、文中のすべてのベンチマーク数値はUnderdogの自社テストおよびそれが引用した公開スコアの転述であり、公開元の主張であって、本文は独立再現を行っていない。報道自体も各ベンダーがそれぞれのテストフレームワークを使用しており、ベンダー間のスコアは直接比較できないと注意を促している。第三に、報道はこのファイルの重みあたりビット数、コンテキスト長、第3層圧縮の完全なレシピを公開していないため、長コンテキスト、バッチ並列、異なるハードウェアでの性能は依然として未知である。第四に、重みがApache 2.0で公開されたことは報道中のライセンス宣言であり、具体的な商用条件を満たすかはモデルカードとライセンス原文に基づく必要があり、重みが取得可能であることは許諾範囲が明確であることを意味しない。最後に、Qwen3.8-27Bの基盤能力の記述(64層、混合注意、262,144ネイティブコンテキスト)も同様にこの報道に由来し、本文では検証していない。