In fünf Minuten integrieren
Kompatible APIs für OpenAI, Anthropic Messages, Responses und Gemini. Prüfen Sie vor der Integration die Unterstützung für Modell, Protokoll und Tools.
Erste Anfrage
API-Schlüssel im Dashboard erstellen und ausführen:
Erstellen Sie im Dashboard einen API-Schlüssel, ersetzen Sie den Platzhalter unten durch Ihren Schlüssel und führen Sie den Befehl im selben Terminal wie die Beispiele aus. curl, SDK und Clients lesen diese Umgebungsvariable.
export KIMISEEK_API_KEY="ks-your-key"curl https://api.kimiseek.app/v1/chat/completions \
-H "Authorization: Bearer ${KIMISEEK_API_KEY:?Setzen Sie zuerst KIMISEEK_API_KEY in diesem Terminal.}" \
-H "Content-Type: application/json" \
-d '{
"model": "deepseek-v4-pro-0813",
"max_completion_tokens": 1024,
"messages": [
{
"role": "user",
"content": "Hello from KimiSeek"
}
]
}'Authentifizierung
Übergeben Sie Ihren KimiSeek-API-Schlüssel für OpenAI-APIs per Authorization: Bearer; Anthropic Messages akzeptiert auch x-api-key. ks-Schlüssel können aus der Schlüsselliste im Dashboard kopiert werden.
Schlüssel nie im Browsercode oder öffentlichen Repository offenlegen.
Unterstützte Modelle und Preise
Kopieren Sie die Modell-ID aus der Tabelle in das Feld model. Angezeigt werden die aktuellen KimiSeek-Preise für Echtzeitanfragen.
| Modell und API-ID | Preisstufe | Eingabe | Cache-Eingabe | Ausgabe | Kontext |
|---|---|---|---|---|---|
DeepSeek V4 Pro 0813deepseek-v4-pro-0813Alias: deepseek-v4-proAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Spitzenzeit (01:00–04:00, 06:00–10:00 UTC (Beijing time 09:00–12:00, 14:00–18:00)) · Zeittarife ab 2026-08-20 13:03:49.577 UTC; davor ganztägig Spitzenzeittarif | ¥4.5 | ¥0.15 | ¥13.5 | 1M |
| Nebenzeit (außerhalb von 01:00–04:00, 06:00–10:00 UTC (Beijing time 09:00–12:00, 14:00–18:00)) · Zeittarife ab 2026-08-20 13:03:49.577 UTC; davor ganztägig Spitzenzeittarif | ¥2.25 | ¥0.075 | ¥6.75 | ||
DeepSeek V4.1 Flashdeepseek-v4.1-flashAlias: deepseek-flashAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Nebenzeit (außerhalb von 01:00–04:00, 06:00–10:00 UTC (Beijing time 09:00–12:00, 14:00–18:00)) · Zeittarife ab 2026-08-16 16:00:00.000 UTC; davor ganztägig Spitzenzeittarif | ¥0.5 | ¥0.01 | ¥2 | 1M |
| Spitzenzeit (01:00–04:00, 06:00–10:00 UTC (Beijing time 09:00–12:00, 14:00–18:00)) · Zeittarife ab 2026-08-16 16:00:00.000 UTC; davor ganztägig Spitzenzeittarif | ¥1 | ¥0.02 | ¥4 | ||
Qwen4 Maxqwen4-maxAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥8.5 | ¥0.425 | ¥25.5 | 1M |
GLM-5.3 Flashglm-5.3-flashAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥0.4 | ¥0.115 | ¥1.4 | 1M |
Qwen3.8 Maxqwen3.8-maxAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥6 | ¥0.75 | ¥18 | 991K |
GLM-5.3glm-5.3Alias: GLM-5.3Aktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥4 | ¥1 | ¥14 | 1.024M |
Kimi K3kimi/kimi-k3Alias: kimi-k3Aktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥16 | ¥1.6 | ¥80 | 1.048576M |
Kimi K3.1 Pro Highspeedkimi/kimi-k3.1-pro-highspeedAlias: kimi-k3.1Alias: kimi-k3.1-proAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥13 | ¥0.65 | ¥68 | 1.048576M |
Qwen3.8 Flashqwen3.8-flashAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥0.4 | ¥0.05 | ¥1.35 | 1M |
Qwen3.8 27Bqwen3.8-27bAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥0.9 | ¥0.18 | ¥3.6 | 1M |
Qwen3.8 2.4T A95Bqwen3.8-2.4t-a95bAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥9.6 | ¥1.2 | ¥28.8 | 1M |
Qwen3.7 Maxqwen3.7-maxAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Standard | ¥6 | ¥1.2 | ¥18 | 991K |
Qwen3.6 Plusqwen3.6-plusAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Eingabe ≤ 256.000 Tokens | ¥1.6 | Eingabepreis | ¥9.6 | 1M |
| Eingabe ≥ 256.001 Tokens | ¥6.4 | Eingabepreis | ¥38.4 | ||
Qwen3.7 Plusqwen3.7-plusAktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Eingabe ≤ 256.000 Tokens | ¥1.6 | ¥0.32 | ¥6.4 | 1M |
| Eingabe ≥ 256.001 Tokens | ¥4.8 | ¥0.96 | ¥19.2 | ||
DeepSeek V4.1 Flash 1017deepseek-v4.1-flash-1017Aktuell verfügbare Protokolle: OpenAI Chat Completions · /v1/chat/completions · Responses /v1/responses; Anthropic Messages · /v1/messages; Gemini · /v1beta/models/{model}:generateContent. | Nebenzeit (außerhalb von 01:00–04:00, 06:00–10:00 UTC (Beijing time 09:00–12:00, 14:00–18:00)) · Zeittarife ab 2026-10-18 23:42:09.074 UTC; davor ganztägig Spitzenzeittarif | ¥0.5 | ¥0.05 | ¥2 | 1.024M |
| Spitzenzeit (01:00–04:00, 06:00–10:00 UTC (Beijing time 09:00–12:00, 14:00–18:00)) · Zeittarife ab 2026-10-18 23:42:09.074 UTC; davor ganztägig Spitzenzeittarif | ¥1 | ¥0.1 | ¥4 |
Preise für Bildmodelle
Preise in CNY pro Bild mit dem aktuellen Modellrabatt. Referenzbilder und erzeugte Bilder werden getrennt berechnet. Auflösungsstufen und Prompt-Erweiterung stehen in der Tabelle; ohne eigenen Erweiterungspreis gilt der normale Ausgabepreis.
| Bildmodell | Referenz / Bild | Ausgabe / Bild | Mit Erweiterung / Bild |
|---|---|---|---|
Qwen Image 3.0 Proqwen-image-3.0-proAktuell verfügbare Protokolle: OpenAI Images · /v1/images/generations. | ¥0.016 | 262.144–2.250.000 Pixel¥0.22.250.001–4.194.304 Pixel¥0.4 | — |
Qwen Image 3.0qwen-image-3.0Aktuell verfügbare Protokolle: OpenAI Images · /v1/images/generations. | ¥0.016 | 262.144–4.194.304 Pixel¥0.144 | — |
Wan 2.7 Image Prowan2.7-image-proAktuell verfügbare Protokolle: OpenAI Images · /v1/images/generations. | ¥0 | 589.824–16.777.216 Pixel¥0.4 | — |
Wan 2.7 Imagewan2.7-imageAktuell verfügbare Protokolle: OpenAI Images · /v1/images/generations. | ¥0 | 589.824–4.194.304 Pixel¥0.16 | — |
Z-Image Turboz-image-turboAktuell verfügbare Protokolle: OpenAI Images · /v1/images/generations. | ¥0 | 262.144–4.194.304 Pixel¥0.08 | 262.144–4.194.304 Pixel¥0.16 |
Preise für Textmodelle in CNY pro 1 Mio. Tokens. Die Stufe richtet sich nach Eingabebereich, Anfragebeginn und Gültigkeitsbedingungen des jeweiligen Modells. Alle Preise und Details zum expliziten Cache
Öffentlicher maschinenlesbarer Modellkatalog, ohne API-Key: GET https://api.kimiseek.app/v1/models
API-Beispiele
Die Beispiele verwenden aktuell konfigurierte Modelle und Protokolle. Verwenden Sie Ihren eigenen KimiSeek-API-Schlüssel.
curl https://api.kimiseek.app/v1/chat/completions \
  -H "Authorization: Bearer ${KIMISEEK_API_KEY:?Setzen Sie zuerst KIMISEEK_API_KEY in diesem Terminal.}" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "deepseek-v4-pro-0813",
  "max_completion_tokens": 1024,
  "messages": [
    {
      "role": "user",
      "content": "Hello from KimiSeek"
    }
  ]
}'curl https://api.kimiseek.app/v1/messages \
-H "x-api-key: ${KIMISEEK_API_KEY:?Setzen Sie zuerst KIMISEEK_API_KEY in diesem Terminal.}" \
-H "anthropic-version: 2023-06-01" \
-H "Content-Type: application/json" \
-d '{
"model": "deepseek-v4-pro-0813",
"max_tokens": 1024,
"messages": [
{
"role": "user",
"content": "Hello from KimiSeek"
}
]
}'curl https://api.kimiseek.app/v1/responses \
-H "Authorization: Bearer ${KIMISEEK_API_KEY:?Setzen Sie zuerst KIMISEEK_API_KEY in diesem Terminal.}" \
-H "Content-Type: application/json" \
-d '{
"model": "deepseek-v4-pro-0813",
"input": "Hello from KimiSeek",
"max_output_tokens": 1024
}'curl https://api.kimiseek.app/v1beta/models/deepseek-v4-pro-0813:generateContent \
-H "Authorization: Bearer ${KIMISEEK_API_KEY:?Setzen Sie zuerst KIMISEEK_API_KEY in diesem Terminal.}" \
-H "Content-Type: application/json" \
-d '{
"contents": [
{
"role": "user",
"parts": [
{
"text": "Hello from KimiSeek"
}
]
}
],
"generationConfig": {
"maxOutputTokens": 1024
}
}'API zur Bilderzeugung
Rufen Sie Bildmodelle über /v1/images/generations auf. Geben Sie beim Bearbeiten für image HTTPS-Referenzen oder Bild-Daten-URLs (data URL) an.
curl https://api.kimiseek.app/v1/images/generations \
  -H "Authorization: Bearer ${KIMISEEK_API_KEY:?Setzen Sie zuerst KIMISEEK_API_KEY in diesem Terminal.}" \
  -H "Content-Type: application/json" \
  -d '{
  "model": "qwen-image-3.0-pro",
  "prompt": "A red panda reading under a cedar tree",
  "size": "1024x1024",
  "n": 1,
  "prompt_extend": false
}'
Offizielles OpenAI SDK
Nur model ändern. Jede Anfrage wird an den für das Modell konfigurierten Upstream geleitet.
import OpenAI from "openai";

const apiKey = process.env.KIMISEEK_API_KEY;
if (!apiKey) throw new Error("Setzen Sie zuerst KIMISEEK_API_KEY in diesem Terminal.");

const client = new OpenAI({
  apiKey,
  baseURL: "https://api.kimiseek.app/v1",
});

const reply = await client.chat.completions.create({
  model: "deepseek-v4-pro-0813",
  messages: [{ role: "user", content: "Hello from KimiSeek!" }],
  max_completion_tokens: 1024,
});Claude Code und Codex
Mit CC Switch konfigurieren
Fügen Sie KimiSeek über die Oberfläche von CC Switch getrennt für Codex und Claude Code hinzu.
- Erstellen oder kopieren Sie zuerst einen KimiSeek-API-Schlüssel im Dashboard. API-Schlüssel verwalten
- Wählen Sie in CC Switch Codex oder Claude Code und fügen Sie einen eigenen Anbieter hinzu oder bearbeiten Sie einen vorhandenen.
- Tragen Sie die folgenden Angaben ein. Website und Notizen sind optional.
- Anbietername
kimiseek- API Key
- Ihr eigener KimiSeek-API-Schlüssel (beginnt mit ks-)
- Standardmodell
- Die Screenshots verwenden glm-5.3-flash. Sie können auch eine verfügbare Modell-ID aus dem obigen Katalog kopieren.
- Tragen Sie die unten angegebene API-Adresse (Base URL) für Ihren Client ein. Lassen Sie den Schalter für die vollständige URL ausgeschaltet.
- Speichern Sie, aktivieren Sie KimiSeek in der Anbieterliste des Clients und starten Sie den Client neu. Konfigurieren und aktivieren Sie beide Clients einzeln, wenn Sie beide verwenden.
Codex
Standardmodell: deepseek-v4-pro-0813
https://api.kimiseek.app/v1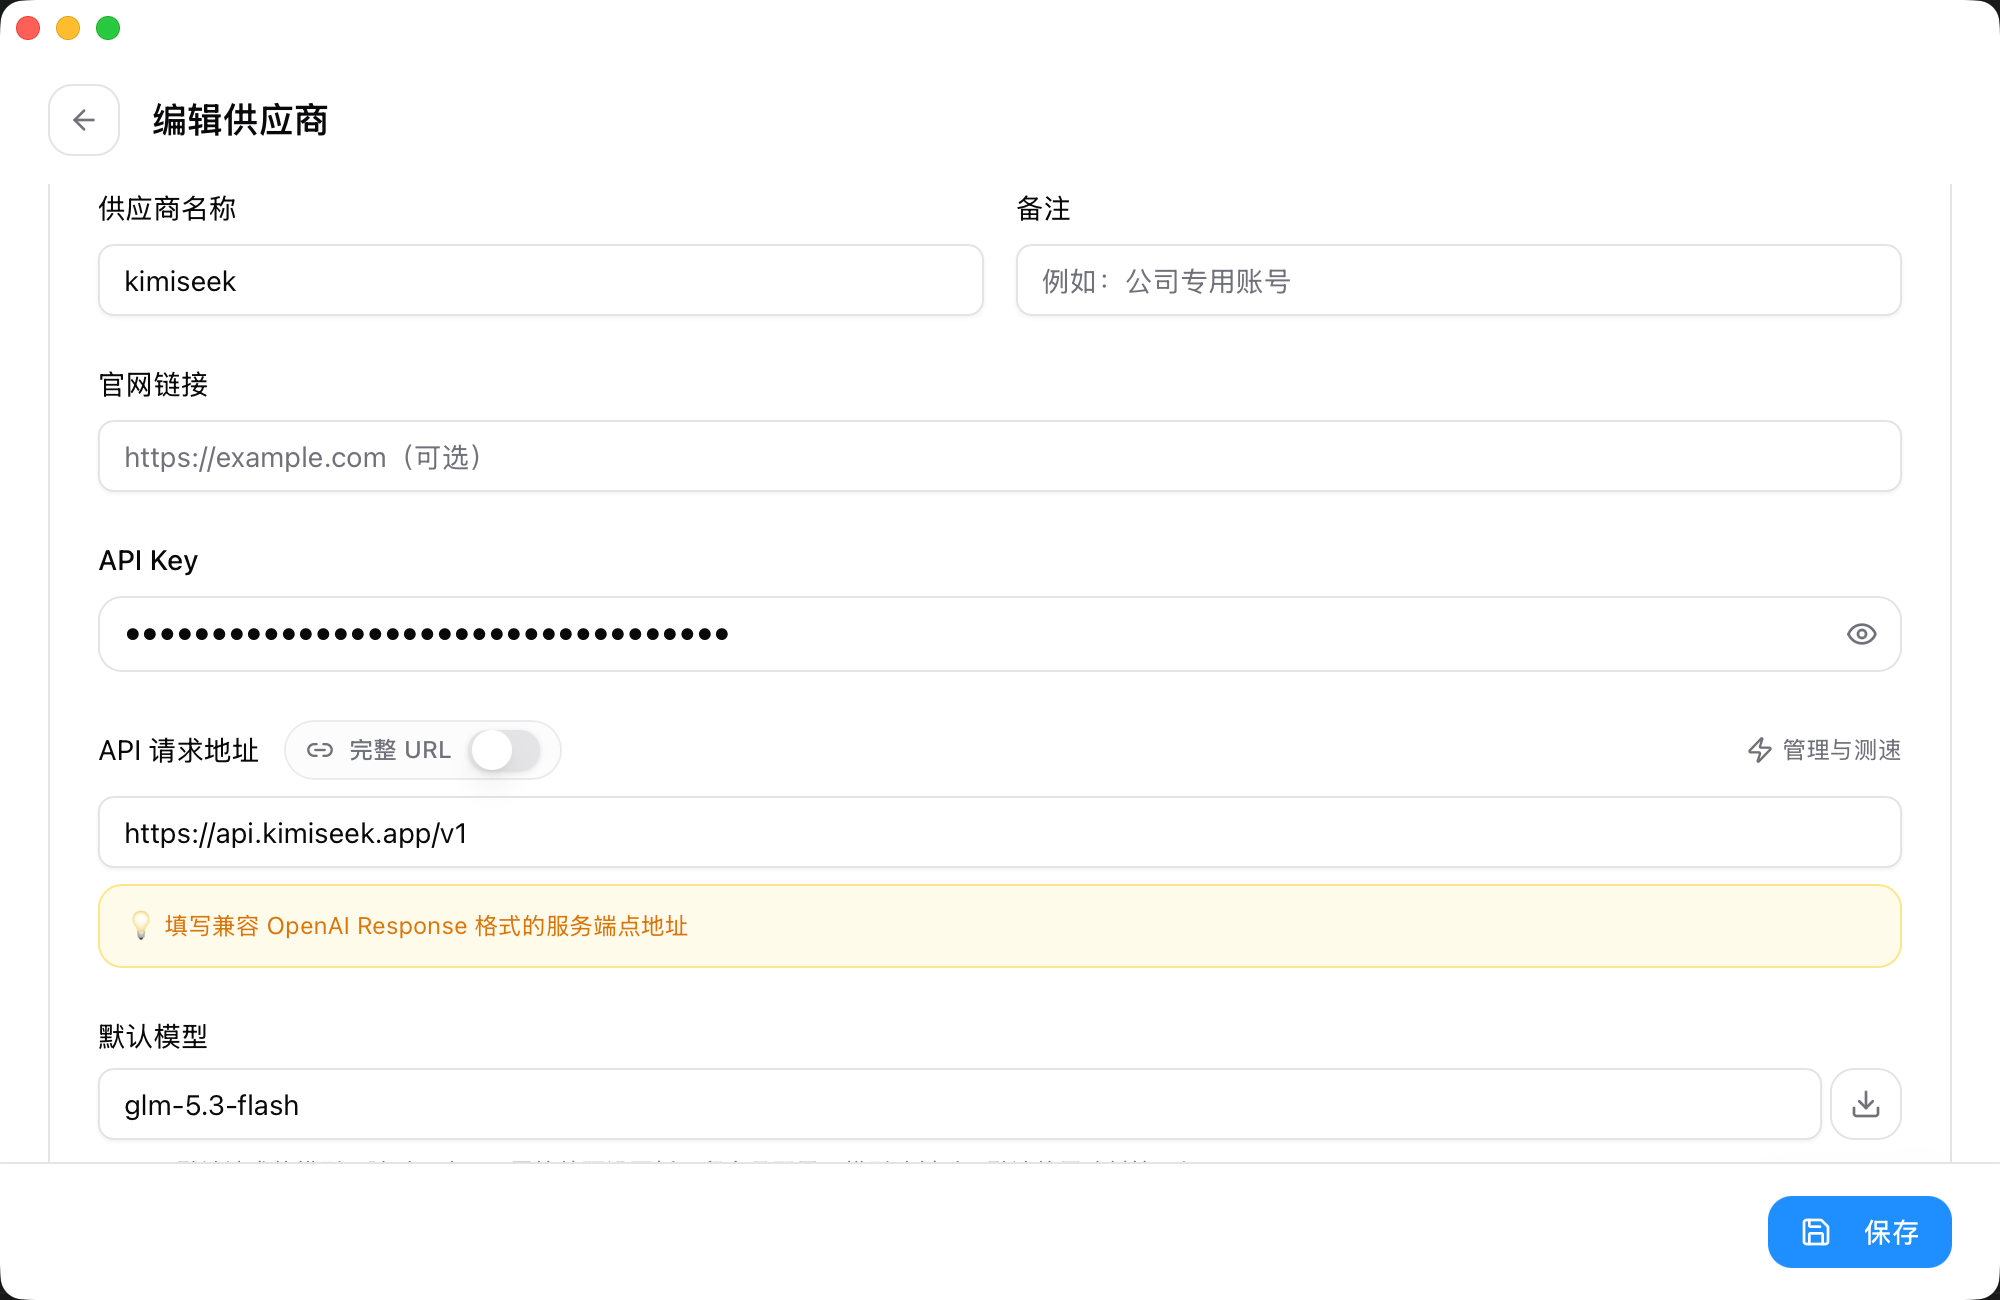
Claude Code
Standardmodell: deepseek-v4.1-flash
https://api.kimiseek.app/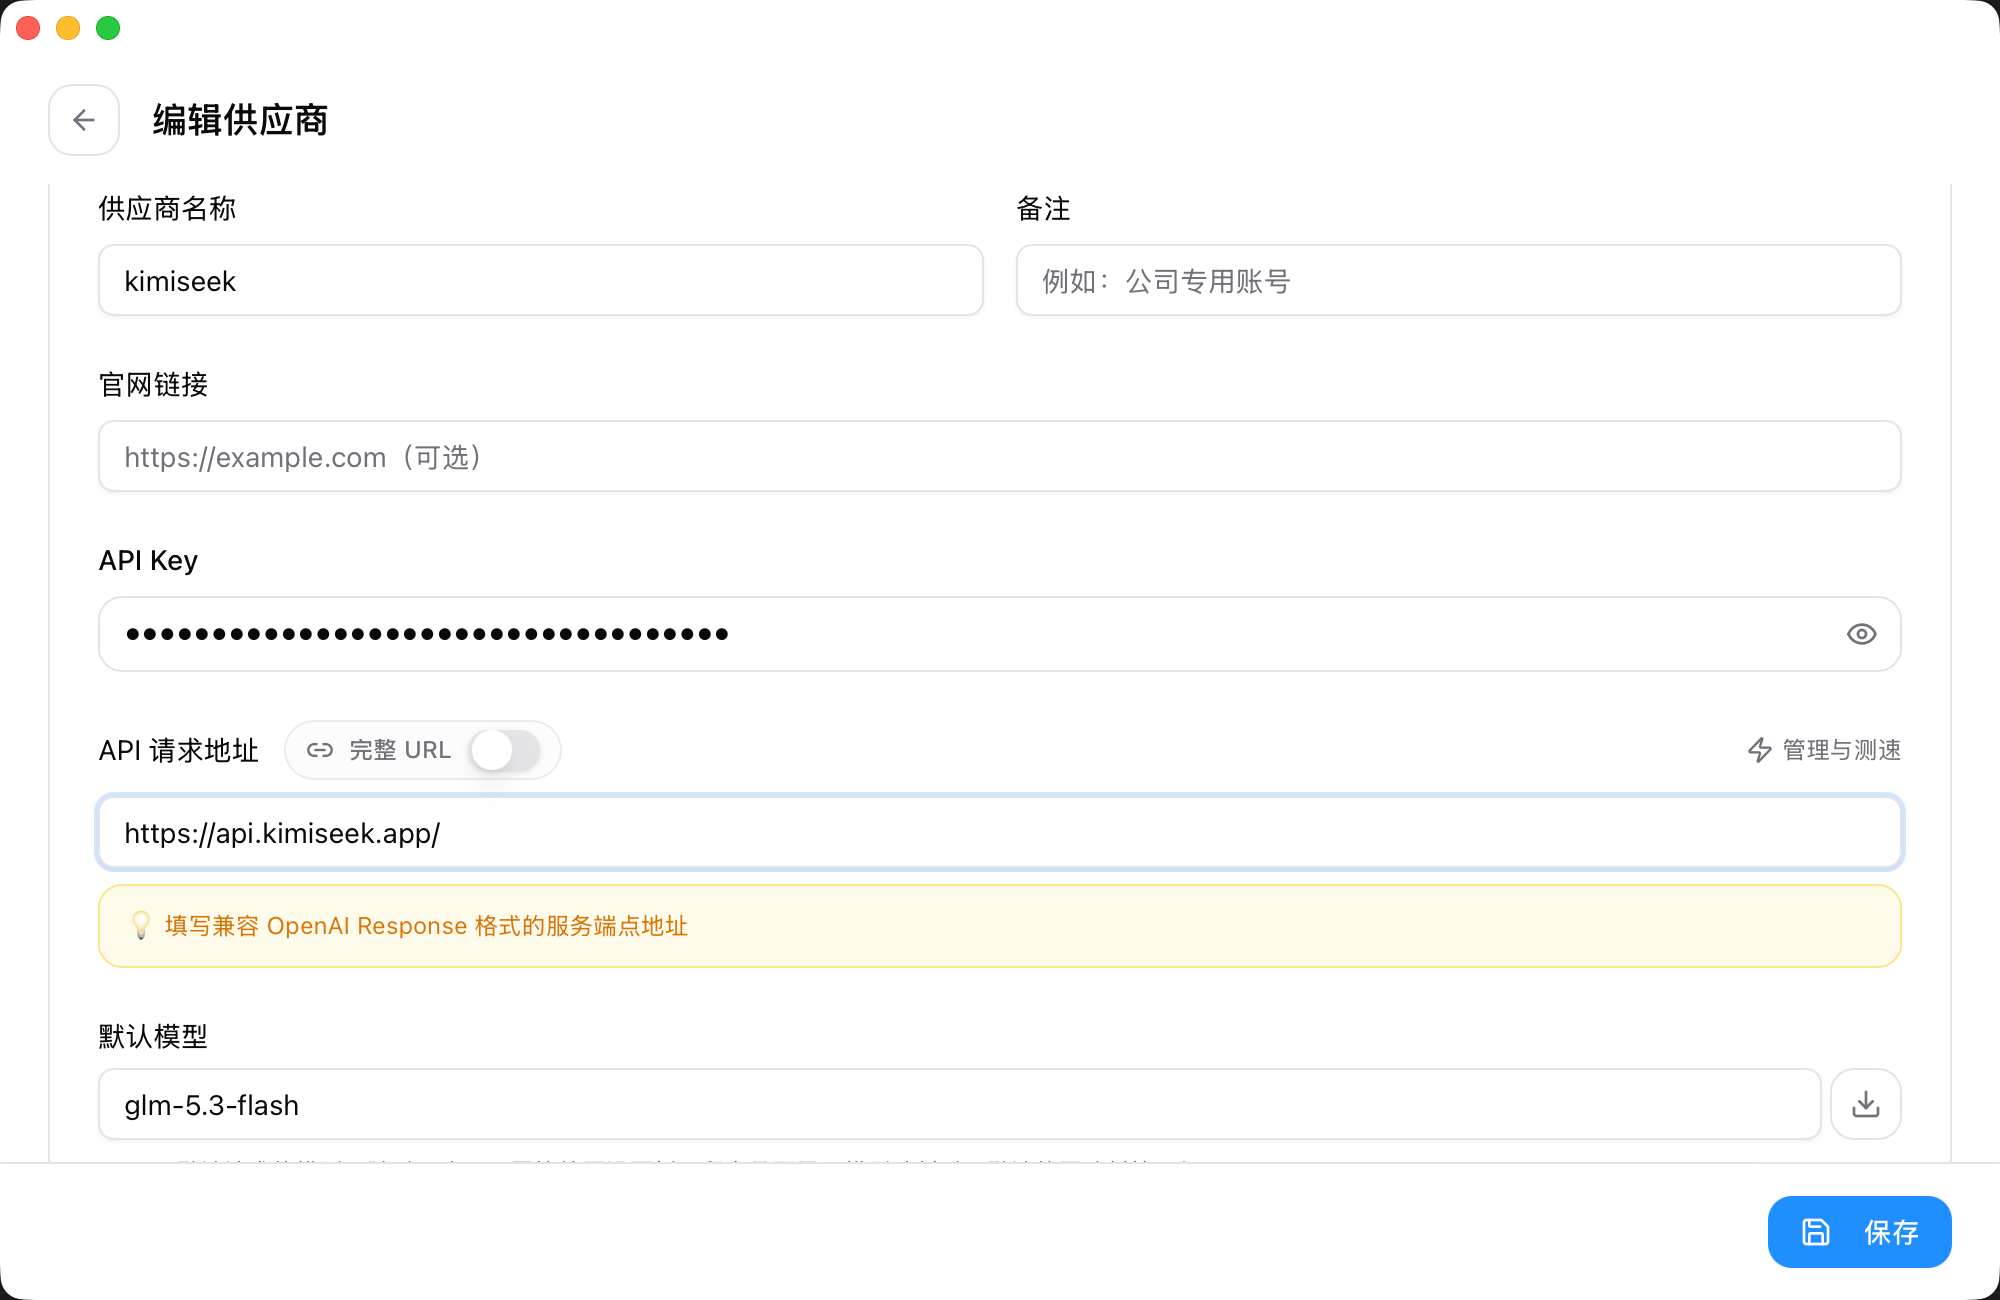
Claude Code nutzt die Anthropic-Messages-kompatible API.
export ANTHROPIC_BASE_URL="https://api.kimiseek.app"
export ANTHROPIC_MODEL='deepseek-v4.1-flash'
export ANTHROPIC_AUTH_TOKEN="${KIMISEEK_API_KEY:?Setzen Sie zuerst KIMISEEK_API_KEY in diesem Terminal.}" && claude
Codex nutzt Responses und die Variable KIMISEEK_API_KEY.
Responses-Client-Tools unterstützen nur flache Funktionen; custom-, namespace- und gehostete Tools werden verworfen und nicht ausgeführt. Werkzeugunterstützung: Codex · Responses
model = "deepseek-v4-pro-0813"
model_provider = "kimiseek"

[model_providers.kimiseek]
name = "KimiSeek"
base_url = "https://api.kimiseek.app/v1"
env_key = "KIMISEEK_API_KEY"
wire_api = "responses"generateContent und streamGenerateContent akzeptieren nur parts[].text; der Schlüssel wird per x-goog-api-key übergeben. Bilder, Dateien, tools, toolConfig und Funktionsaufrufverläufe werden vor Weiterleitung oder Abrechnung mit HTTP 400 abgewiesen. Für Tools nutzen Sie eine andere kompatible Schnittstelle und ein geeignetes Modell. Auch die Ausgabe ist auf Text beschränkt; Audio- oder Bilderzeugung wird vor Weiterleitung oder Abrechnung mit HTTP 400 abgewiesen.
Streaming
stream: true aktiviert SSE; erzeugte Nutzung wird bei Abschluss oder Abbruch des Streams abgerechnet.
Fehlercodes
400Ungültige Anfrage oder Modellname401Ungültiger Schlüssel oder Quote aufgebraucht402CNY-Guthaben zu niedrig503Modellkanal nicht verfügbarCNY-Abrechnung
Eingabe-, Cache- und Ausgabetokens werden mit den Preisen multipliziert und in CNY abgerechnet.
Jede Anfrage reserviert die geschätzten Kosten (mindestens ¥0.10) aus dem verfügbaren Konto- und Schlüsselbudget. Laufende Anfragen und ausstehende Buchungen belegen ebenfalls Budget. Warten Sie bei Engpässen oder senken Sie das Ausgabe- oder separate Denkbudget.
Pro Konto sind bis zu 4 Modellanfragen gleichzeitig möglich. Reservierungen sind keine Abbuchungen; abgerechnet wird der tatsächliche Verbrauch. Mehrverbrauch wird nachberechnet und kann zu einem negativen Guthaben führen. Aufladungen decken zuerst offene Beträge. Ohne Ausgabelimit wird das Modellmaximum reserviert. Separate Denkbudgets kommen hinzu; ohne Angabe wird vorsorglich das Kontextlimit verwendet.