Aleph Alpha veröffentlicht offene Gewichte Kolibri: 78,1 Mrd. Parameter MoE, 3,46 Mrd. pro Token aktiviert
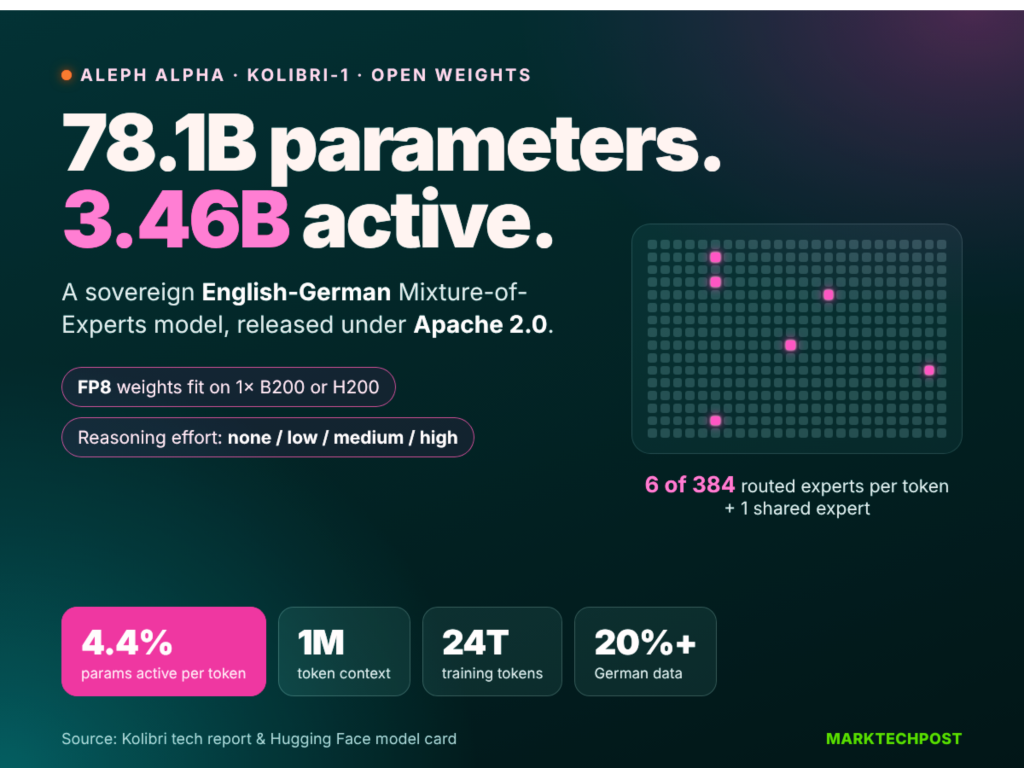
Laut einem Bericht von MarkTechPost vom 4. Oktober 2026 hat Aleph Alpha das englisch-deutschsprachige MoE-Modell mit offenen Gewichten Kolibri-1 veröffentlicht: insgesamt 78,1 Mrd. Parameter, pro Token nur 3,46 Mrd. aktiviert, Kontext bis zu 1.048.576 Token und vier Stufen der Inferenzintensität, unter Apache-2.0-Lizenz auf Hugging Face veröffentlicht, FP8-Checkpoint ca. 78 GB, mit vLLM auf einer einzelnen B200 oder H200 betreibbar.
Was sich geändert hat
Laut einem Bericht von MarkTechPost vom 4. Oktober 2026 hat das deutsche Team Aleph Alpha das Modell mit offenen Gewichten Kolibri (Kolibri-1) veröffentlicht, positioniert als englisch-deutschsprachiges Mixture-of-Experts-(MoE-)Sprachmodell mit dem Ziel souveräner Bereitstellung in regulierten Bereichen wie öffentliche Verwaltung, Industrie und Luft- und Raumfahrt. Der Bericht nennt insgesamt 78,1 Mrd. Parameter, pro Token nur 3,46 Mrd. aktiviert (ca. 4,4 %): Jede MoE-Schicht wählt mit einem Sigmoid-Router top 6 aus 384 gerouteten Experten plus 1 geteilten Experten; die Lastverteilung nutzt Exact Quantile Balancing und Load-Error Injection. Das Modell stapelt 50 Transformer-Blöcke der Breite 2560, gruppierte Query-Attention mit 48 Query- und 4 KV-Köpfen; jeder fünfte Block ist vollständige Attention ohne Positionskodierung, die übrigen 40 Blöcke sind Sliding-Window-Attention über die vorherigen 512 Token mit RoPE, sodass nur 10 Schichten KV-Cache mit dem Kontext wachsen. Die Kontextobergrenze wird mit 1.048.576 Token angegeben, die Inferenzintensität kann pro Anfrage auf keine, niedrig, mittel oder hoch gesetzt werden. Zum Training heißt es, das Vortraining habe auf 768 NVIDIA B200 20T Token umfasst, das Midtraining 3,44T Token (Sequenzlänge 65.536), die Langkontextphase 201B Token (Sequenzlänge 262.144), zusätzlich über 2T deutsche Token; das Posttraining kombiniere überwachtes Feintuning mit Reinforcement Learning auf über 1,2 Mio. internen Aufgaben. Die Lizenz ist Apache 2.0, die Gewichte sind auf Hugging Face veröffentlicht; der FP8-Checkpoint umfasst ca. 78 GB und lässt sich auf einer einzelnen B200, B300 oder H200 oder zwei H100 SXM5 über vLLM mit speziellem Inferenz-Parser und Tool-Calling-Parser betreiben. Die im Bericht genannten Benchmarks zeigen im Englischen insgesamt 75,5, im Deutschen insgesamt 70,8, BFCL v4 61,4 und damit niedriger als das zum Vergleich herangezogene Qwen3.5. Die genannten Parameter, Benchmarks und Bereitstellungsdetails sind Wiedergaben des ursprünglichen Berichts und des technischen Berichts und noch nicht unabhängig reproduziert.
Auswirkungen für Entwickler
Aus Entwicklersicht konzentriert sich der Wert dieser Meldung auf drei Punkte. Erstens die Kombination aus Lizenz und Selbsthosting: Der Bericht nennt eine Veröffentlichung der Gewichte unter Apache 2.0, was einen klareren Lizenzspielraum gibt als die übliche Praxis „offene Gewichte, aber eingeschränkte kommerzielle Nutzung“; die Lizenzbedingungen sind jedoch im Original der Modellkarte und des Repositorys auf Hugging Face zu prüfen und nicht allein aus der Berichtswiedergabe abzuleiten. Zudem ist zu beachten, dass verfügbare Gewichte nicht bedeuten, dass Trainingsdaten, Tokenizer oder Inferenzpaket derselben Lizenz unterliegen. Zweitens die Kostenstruktur durch die Sparsity: 78,1 Mrd. Gesamtparameter und 3,46 Mrd. aktivierte Parameter bedeuten, dass der Speicherbedarf nach den Gesamtparametern und der Rechenaufwand nach den aktivierten Parametern bemessen wird; der Bericht nennt einen FP8-Checkpoint von ca. 78 GB, der auf einer einzelnen B200/H200 läuft, was für Teams mit vorhandenen Knoten mit einer einzelnen Karte hohem Speicher ein machbarer Ausgangspunkt für Selbsthosting ist. Der tatsächliche Durchsatz und die Parallelität hängen jedoch weiterhin von Speicherbandbreite, KV-Cache-Präzision und Batchgröße ab und müssen selbst getestet werden. Drittens die hybride Attention und der Million-Kontext: Die Sliding-Window-Schichten halten den KV-Cache konstant, nur 10 Schichten wachsen mit dem Kontext; das Team gibt an, bei gleichem Rechenaufwand die vierfache Sequenzlänge gegenüber vollständiger Attention zu unterstützen. Falls zutreffend, wäre die Kontextökonomie für lange Dokumente und industrielles RAG deutlich besser als bei dichten Modellen gleicher Größe; dies ist jedoch eine Herstelleraussage und muss auf der eigenen Dokumentverteilung als effektiver Kontext validiert werden, nicht nur anhand der Obergrenze. Darüber hinaus zeigt die englisch-deutsche Ausrichtung und ein für Deutsch optimierter Tokenizer (laut Bericht 4,90 Bytes pro deutschem Token, ca. 11,2 % weniger Token als der Vergleichstokenizer), dass der Stärkebereich im Deutschen liegt; für überwiegend chinesische Geschäfte sollte daraus keine chinesische Kompetenz abgeleitet werden, der Bericht liefert keine chinesischen Evaluierungen. Klarzustellen ist: Zum Zeitpunkt dieser Katalogprüfung erscheint die Version Kolibri-1 nicht im Echtzeit-Modellkatalog von KimiSeek; die im Bericht genannte Verfügbarkeit von Gewichten und Inferenzdienst bezieht sich daher auf die Veröffentlichung seitens Aleph Alpha und Hugging Face, nicht auf ein Angebot dieser Seite.
Integration und Bewertung
Das Folgende sind Empfehlungen und bedingte Analysen, keine bestätigten Fakten. Empfehlung eins: Zuerst nach Lizenz- und Compliance-Voraussetzungen entscheiden, dann nach Leistung. Die konkrete Wahl besteht darin, die LICENSE-Datei des Hugging-Face-Repositorys, die Nutzungsbeschränkungen der Modellkarte und die Lizenz des Inferenzpakets aleph-alpha-inference zu prüfen, bevor eine Produktionsabhängigkeit erwogen wird. Wenn die Arbeitslast die lokale Verarbeitung regulierter Daten betrifft und das Team über einen Knoten mit einer einzelnen B200/H200-Klasse verfügt, ist Selbsthosting wertvoller als der Aufruf einer externen API; ist diese Voraussetzung nicht erfüllt (etwa nur Consumer- oder mehrere Karten mittlerer bis kleiner Speichergröße), sollte nach quantifizierbaren Kriterien abgebrochen werden: Bestanden gilt, wenn der FP8-Checkpoint auf der Zielhardware erfolgreich geladen wird und stabil ausgibt; schlägt das Laden fehl oder wäre eine Speichererweiterung über das Budget hinaus nötig, erfolgt keine nächste Runde. Empfehlung zwei: Vor einer Umstellung oder Einführung eine Vergleichsevaluierung mit dem bestehenden Modell auf eigenen deutschen oder gemischt englisch-deutschen Korpora durchführen. Wählbare Schlüsselvariablen sind die Stufe der Inferenzintensität (keine/niedrig/mittel/hoch) und die KV-Cache-Präzision, da sie die Kosten und Latenz einer Anfrage direkt verändern; bei Aufgaben der Extraktion aus langen Dokumenten mit hoher Latenztoleranz kann eine höhere Intensität Qualitätsgewinne bringen, bei kurzen Frage-Antwort-Aufgaben mit hoher Parallelität ist niedrige Intensität mit größerem Batching günstiger. Die Bewertungskriterien müssen messbar sein: Auf einem festen Satz von 200 bis 500 deutschsprachigen Langdokument-Frage-Antwort-Paaren Genauigkeit und Ende-zu-Ende-Latenz pro tausend Token je Stufe vergleichen; eine höhere Stufe erst dann einsetzen, wenn der Genauigkeitszuwachs den Latenz- und Kostenzuwachs übersteigt. Empfehlung drei: Langkontextfähigkeit muss als „effektives Fenster“ und nicht als Obergrenze validiert werden. Die konkrete Wahl besteht darin, zunächst mit dem Standardkontext von 262.144 zu starten und dann über max-model-len und das Überschreiben von max_position_embeddings schrittweise größere Fenster freizugeben; Voraussetzung ist, dass die Aufgabe tatsächlich durchgehende Abhängigkeiten über eine Million Token benötigt; sind die Retrieval-Ergebnisse ohnehin kürzer als hunderttausend Token, erhöht das Öffnen der Obergrenze nur die KV-Cache-Kosten. Quantifizierbar ist die Messung der Recall-Rate für Schlüsselinformationen über eine Längengradienten (z. B. 32k, 128k, 512k); zeigt sich bei einer Länge ein deutlicher Abfall, sollte diese Länge als praktische Obergrenze verwendet werden. Empfehlung vier: Tool-Calling und Agent-Szenarien separat belasten. Der Bericht nennt einen niedrigeren BFCL-v4-Wert als beim Vergleichsmodell Qwen, während der Agentic-Durchschnitt nahe am Wettbewerber liegt, was auf große Unterschiede zwischen einzelnen Agent-Teilaufgaben hindeutet; die konkrete Wahl ist, das bestehende Modell als Hauptpfad für Tool-Calling zu behalten und Kolibri für deutsche Retrieval und Generierung zu nutzen oder umgekehrt. Voraussetzung ist, dass das Team über ein regressionsfähiges Tool-Calling-Testset verfügt; quantifizierbar sind Erfolgsrate und Parameterkorrektheit der Aufrufe auf dem eigenen Tool-Schema; liegt sie deutlich unter dem aktuellen Modell, sollte der Hauptpfad nicht migriert werden.
Grenzen und offene Fragen
Zunächst ist ausdrücklich festzuhalten: Zum Zeitpunkt dieser Katalogprüfung erscheint Kolibri-1 nicht im Echtzeit-Modellkatalog von KimiSeek; die hier genannten Gewichte, Inferenzpakete und Bereitstellungswege beziehen sich auf die Veröffentlichung von Aleph Alpha und Hugging Face und bedeuten nicht, dass diese Seite das Modell anbietet; Aussagen zur API-Verfügbarkeit im Bericht betreffen nur die Herstellerseite und sind nicht als Dienst dieser Seite zu verstehen. Zweitens stammen alle Architektur-, Trainings-, Benchmark- und Bereitstellungszahlen aus dem Bericht von MarkTechPost vom 4. Oktober 2026 und den darin wiedergegebenen technischen Berichten und Modellkarten und sind nicht unabhängig reproduziert; die Benchmark-Vergleiche beruhen auf herstellereigenen Evaluierungskonfigurationen, deren Vergleichbarkeit über Modelle hinweg begrenzt ist und die nicht als alleinige Auswahlgrundlage dienen sollten. Drittens liefert der Bericht keine unabhängigen Validierungsdetails zu chinesischen, Code- oder Langkontextszenarien; die Fähigkeiten außerhalb der englisch-deutschen Ausrichtung sind unbekannt; die Aussage „vierfache Sequenzlänge bei gleichem Rechenaufwand“ ist eine Teamaussage und selbst zu prüfen. Viertens ist Apache 2.0 eine Lizenzangabe für die veröffentlichten Gewichte; der konkrete Geltungsbereich (Gewichte, Tokenizer, Inferenzpaket, Trainingsdaten) ist Punkt für Punkt anhand der Originallizenz und der Modellkarte zu prüfen; aus „offenen Gewichten“ lässt sich nicht direkt der Lizenzumfang aller Komponenten ableiten. Fünftens sind Einzelkarten-Lauffähigkeit und Produktionstauglichkeit zweierlei; Spitzenparallelität, Speicherreserven und der Einfluss der Inferenzintensitätsstufen auf die Kosten müssen auf der Zielhardware gemessen werden. Sechstens sind die im Bericht genannten Preise, Obergrenzen und empfohlenen Sampling-Parameter Informationen zum Zeitpunkt der Veröffentlichung und können sich mit späteren Versionen ändern; maßgeblich sind die aktuellen Inhalte der Seiten des Herstellers und von Hugging Face.