Baidu stellt Apollo World vor: Weltmodell als Prüfer für autonomes Fahren – was Entwickler messen sollten
Baidu hat am 3. November auf der AI Day·Apollo-Sonderveranstaltung in Shenzhen erstmals das Weltmodell Apollo World vorgestellt und einen „2+3“-Kriterienkatalog aus Kausalität, Interaktivität, physikalischer Genauigkeit, Persistenz und Echtzeitfähigkeit präsentiert. Laut Bericht wird es bereits für globale Tests und die Validierung von Apollo Go eingesetzt. Der Artikel trennt berichtete Fakten von Schlussfolgerungen und gibt bedingte Einschätzungen zu Simulationsgrundlage, Abnahmekriterien und Echtzeitbudget.
Was sich geändert hat
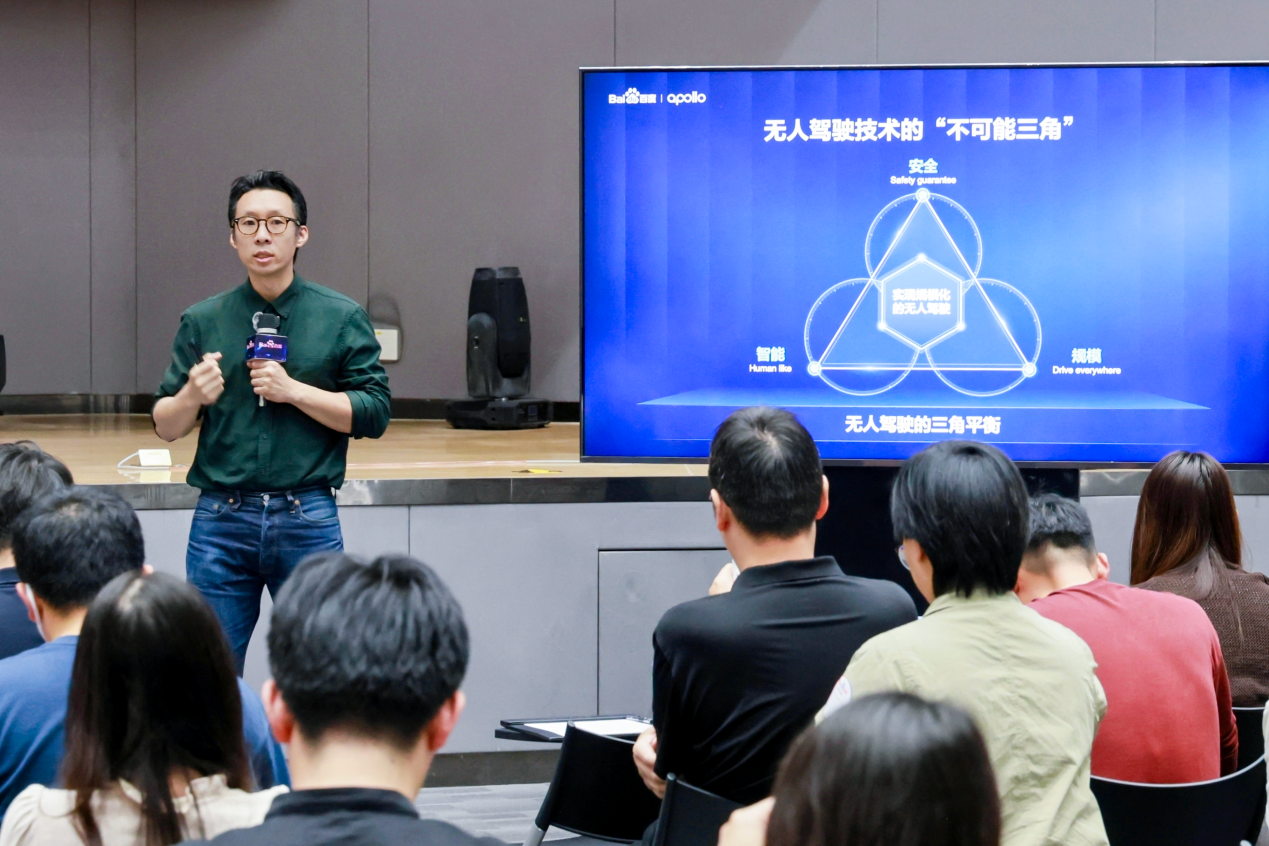
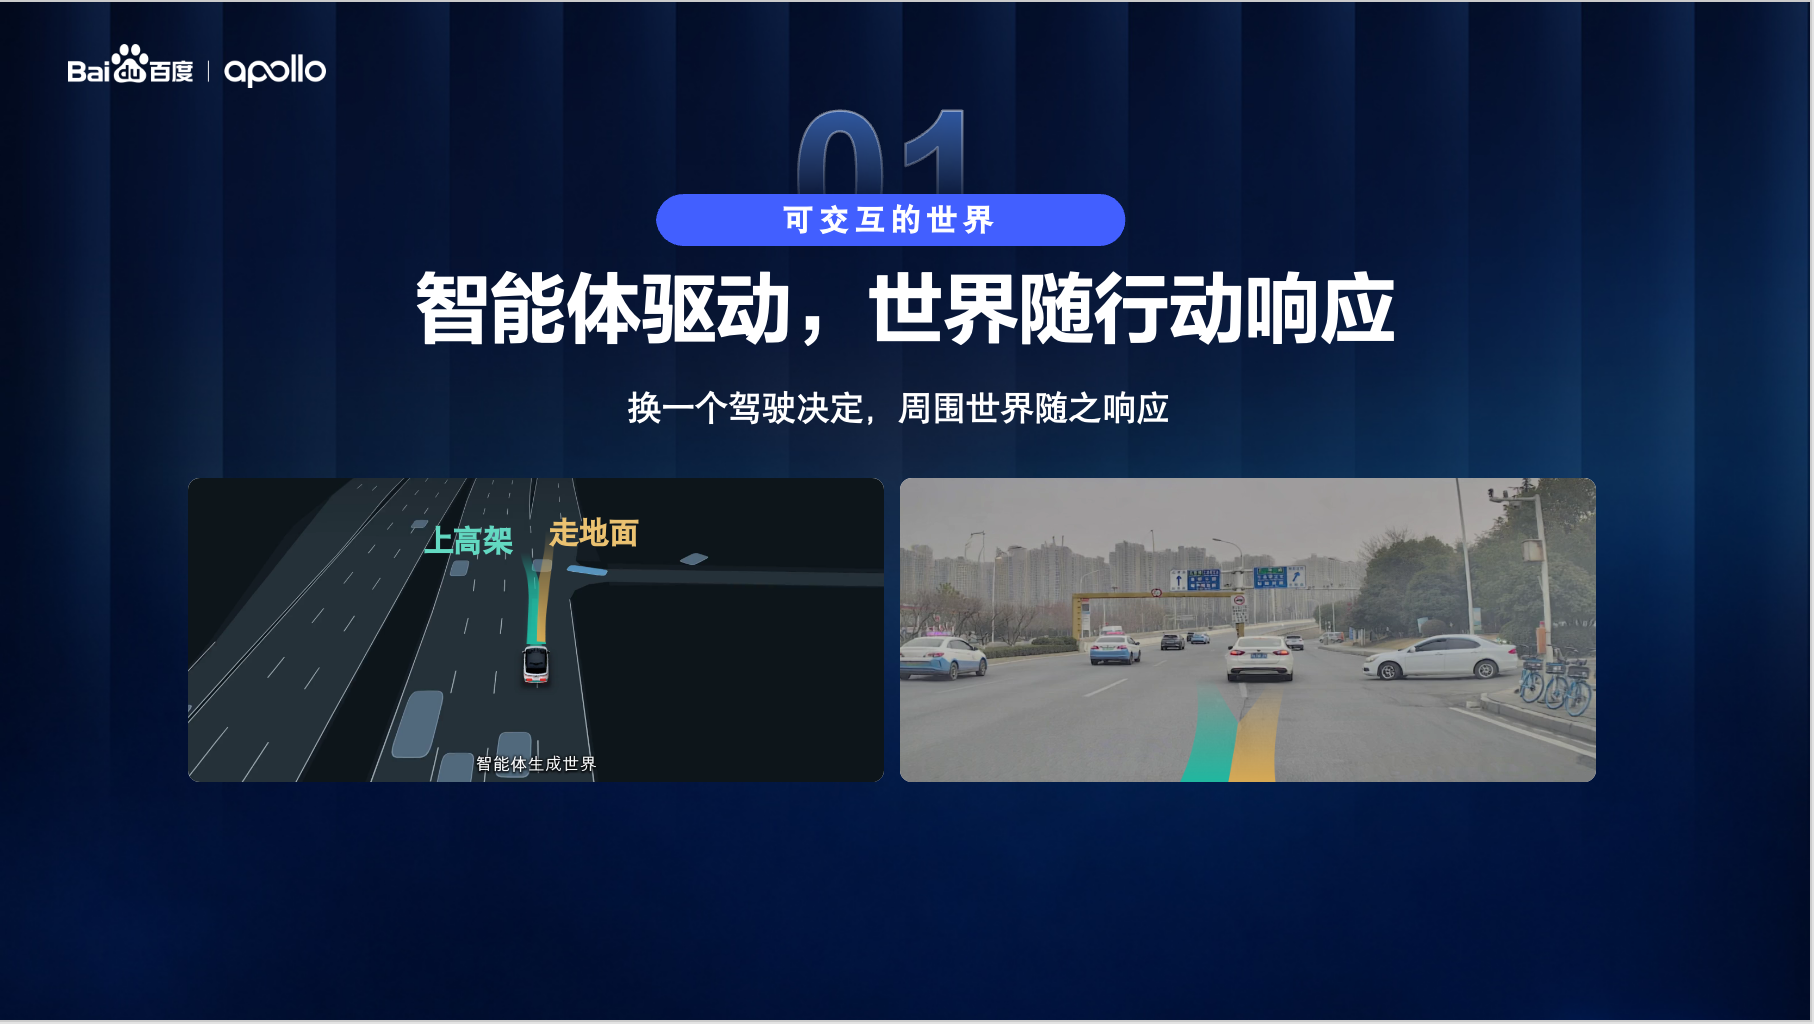
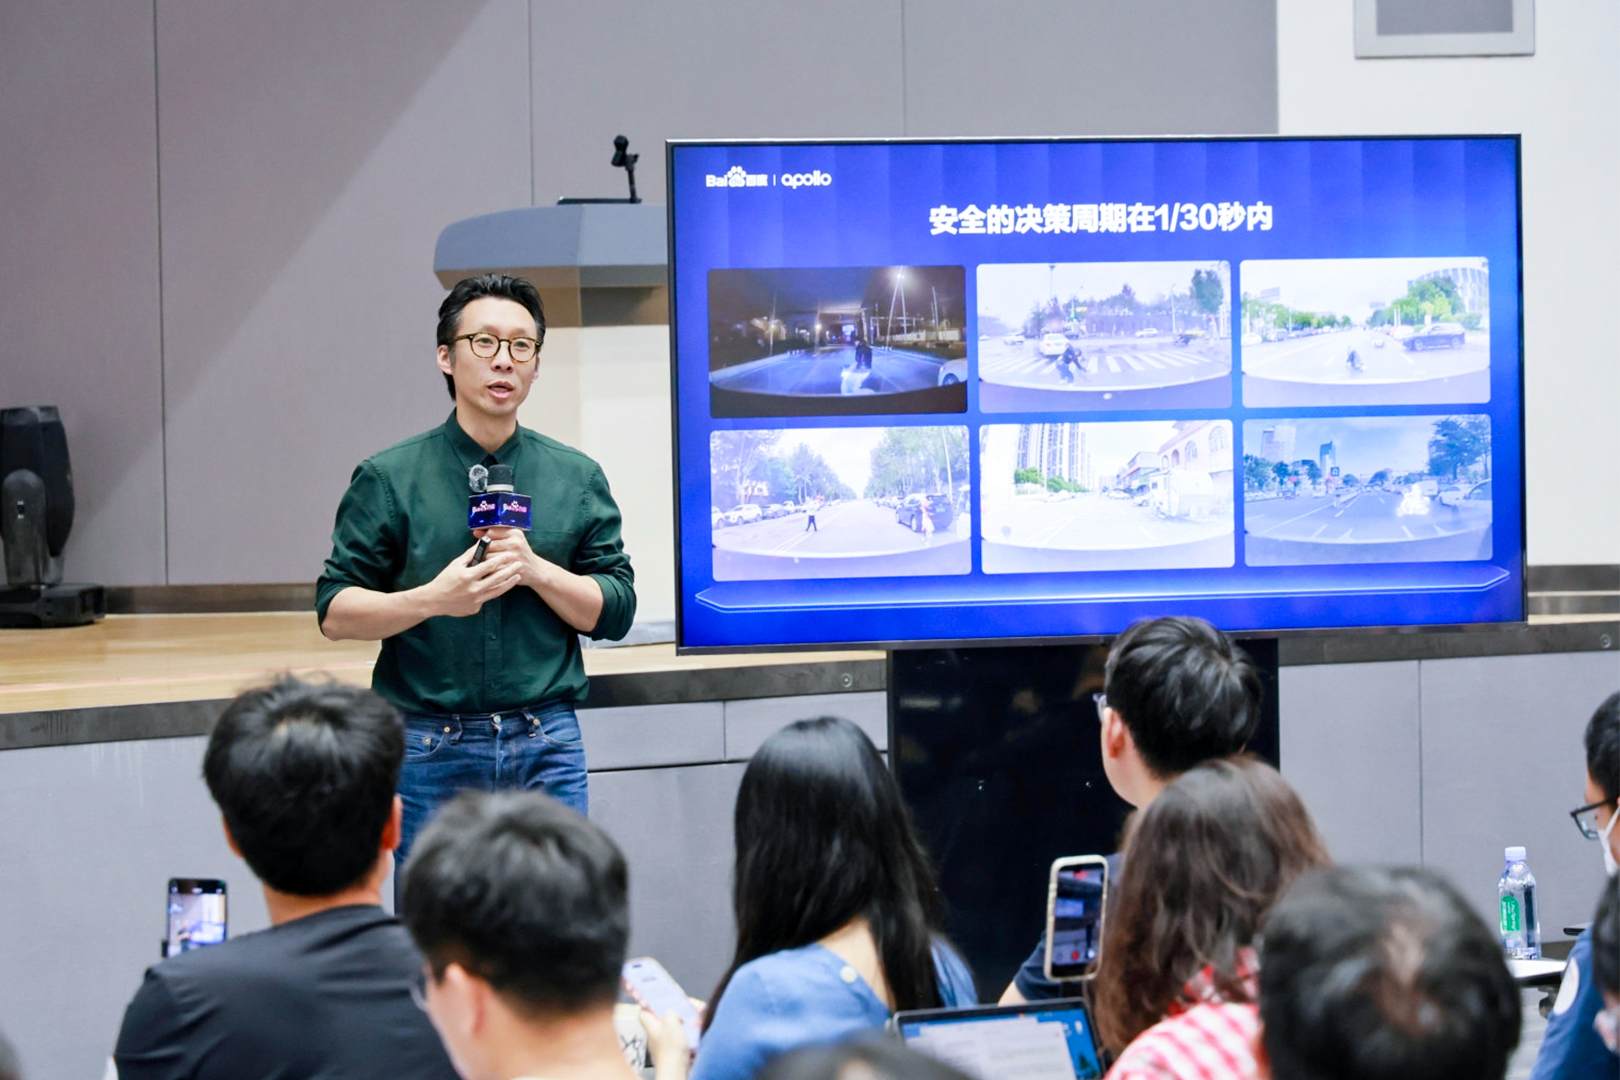
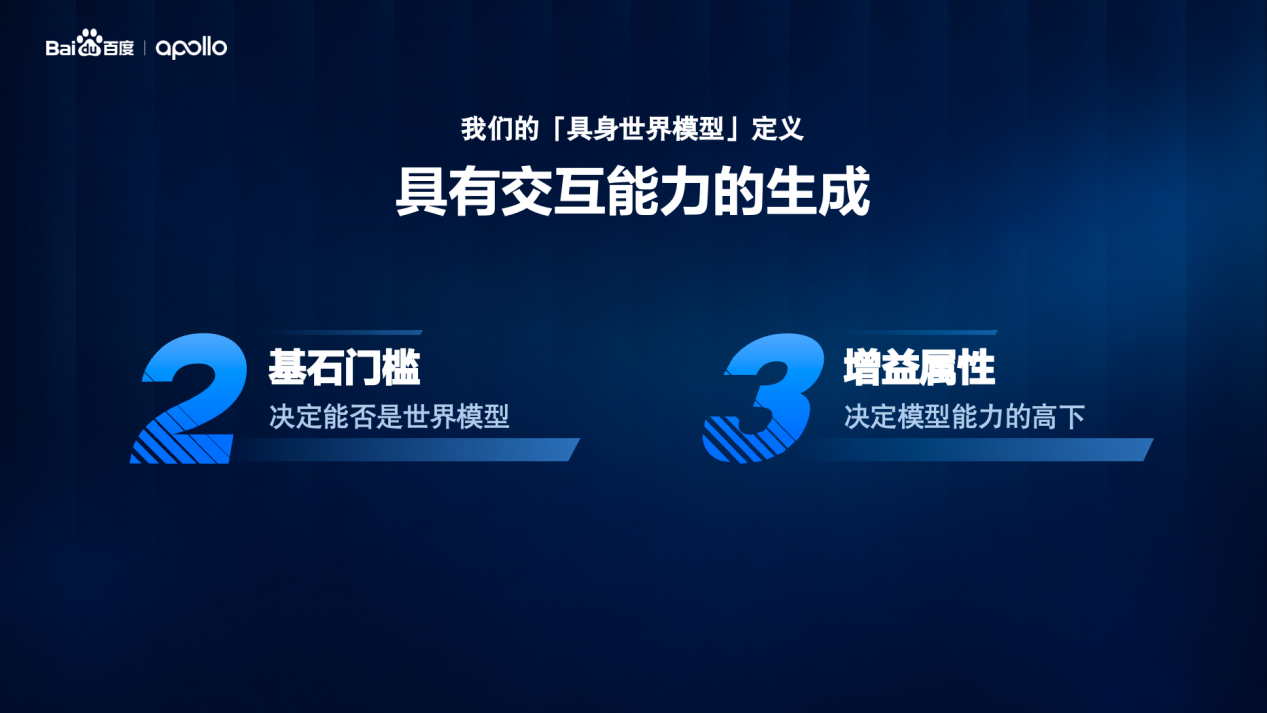
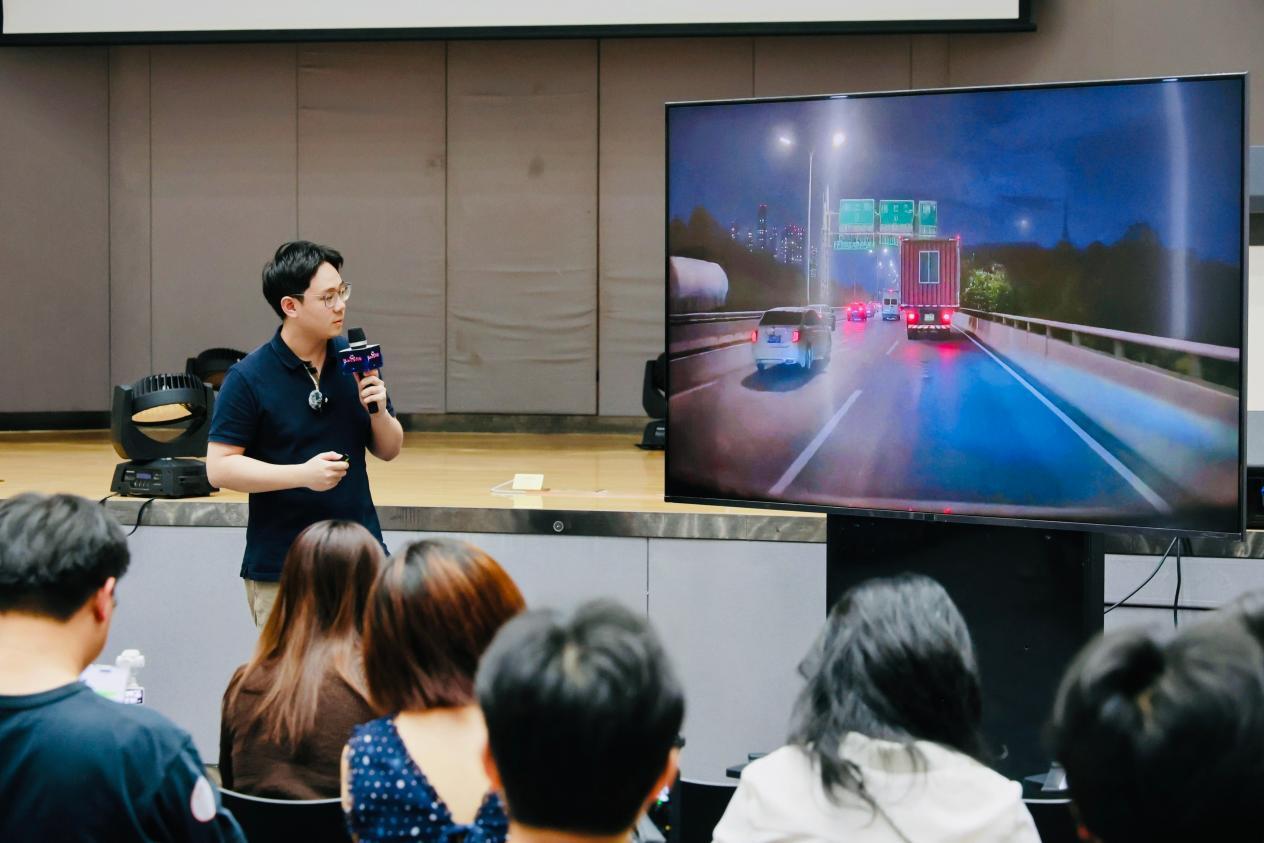
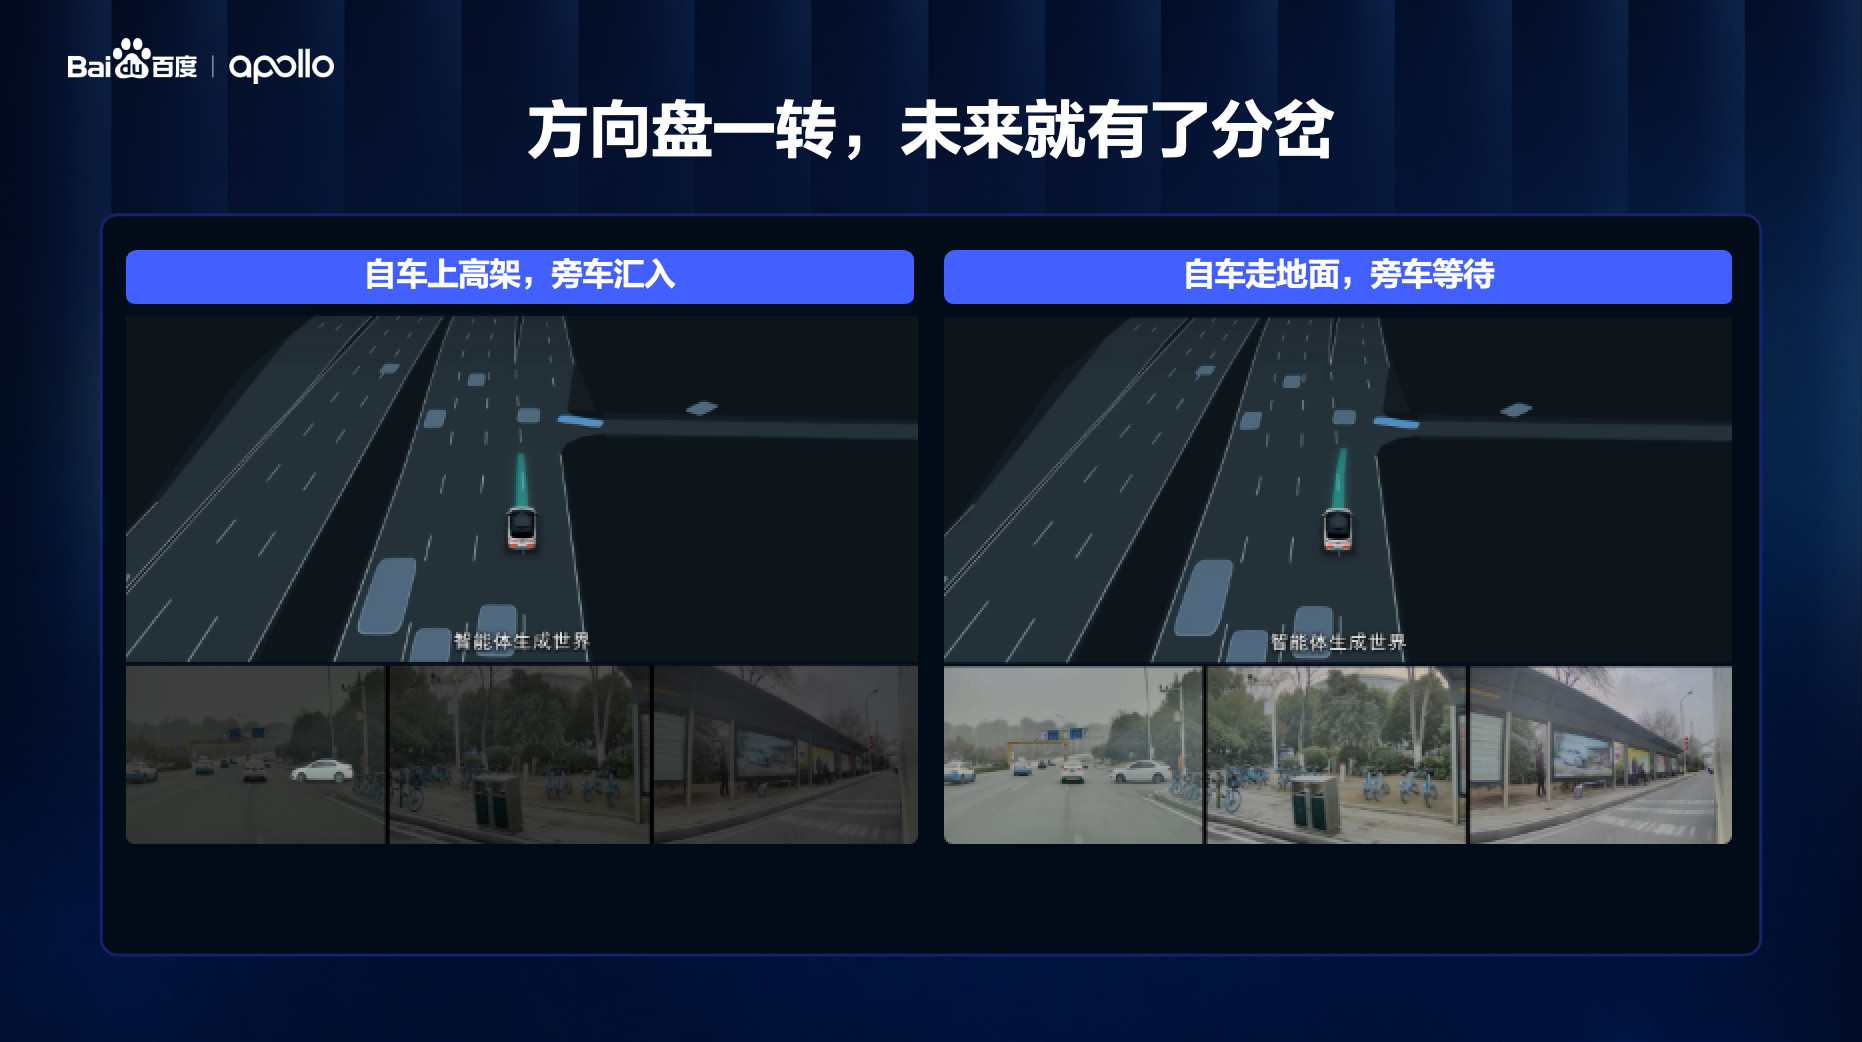
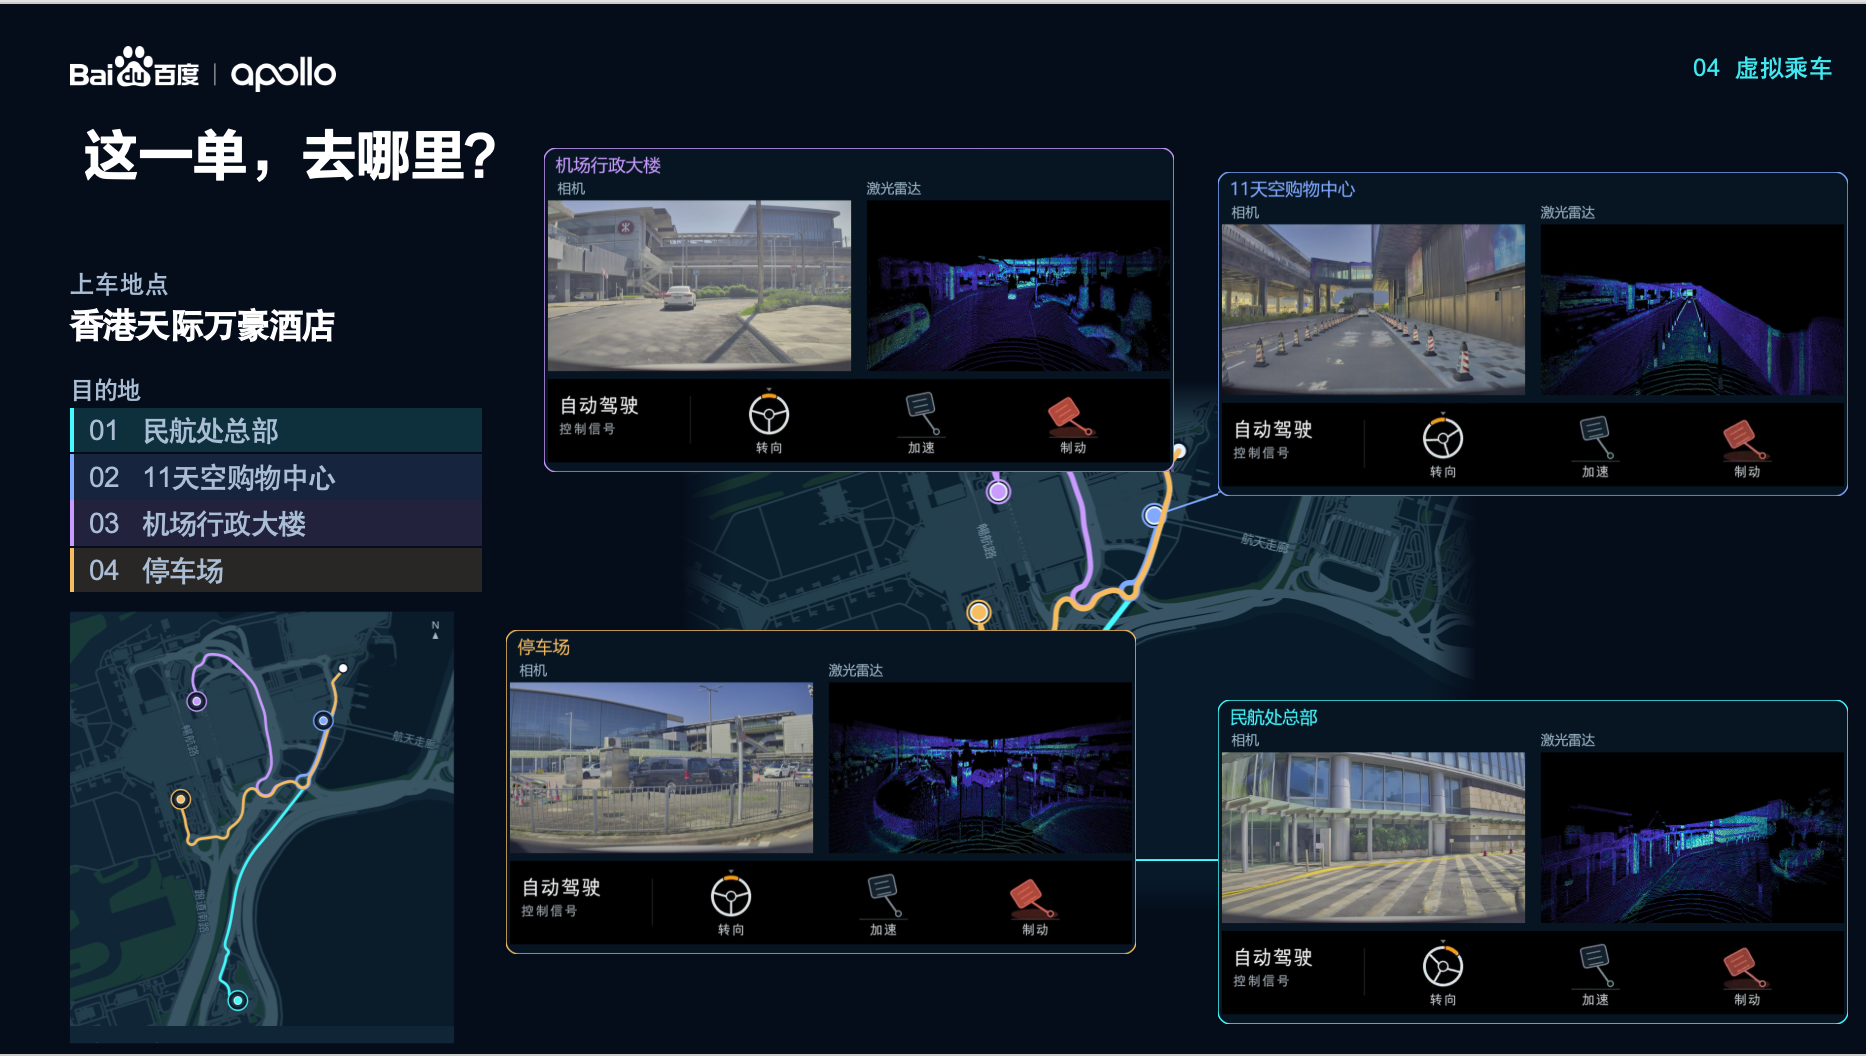
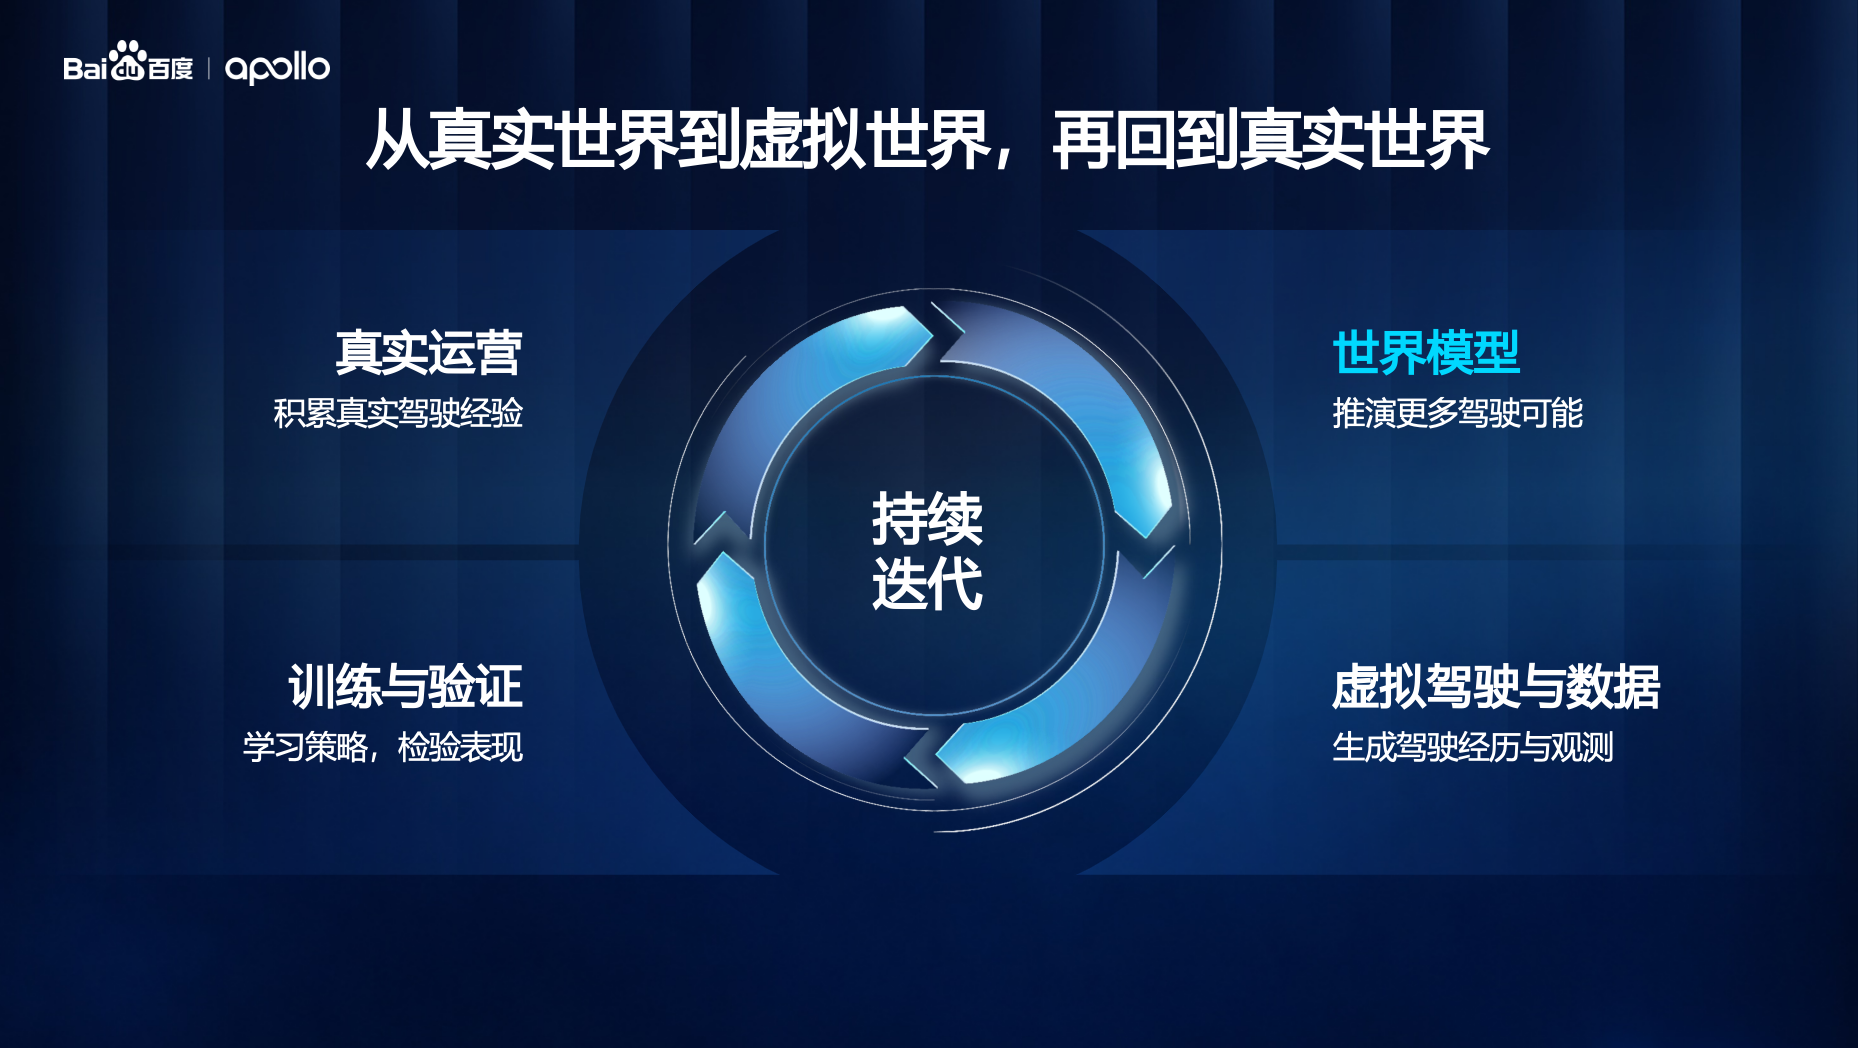
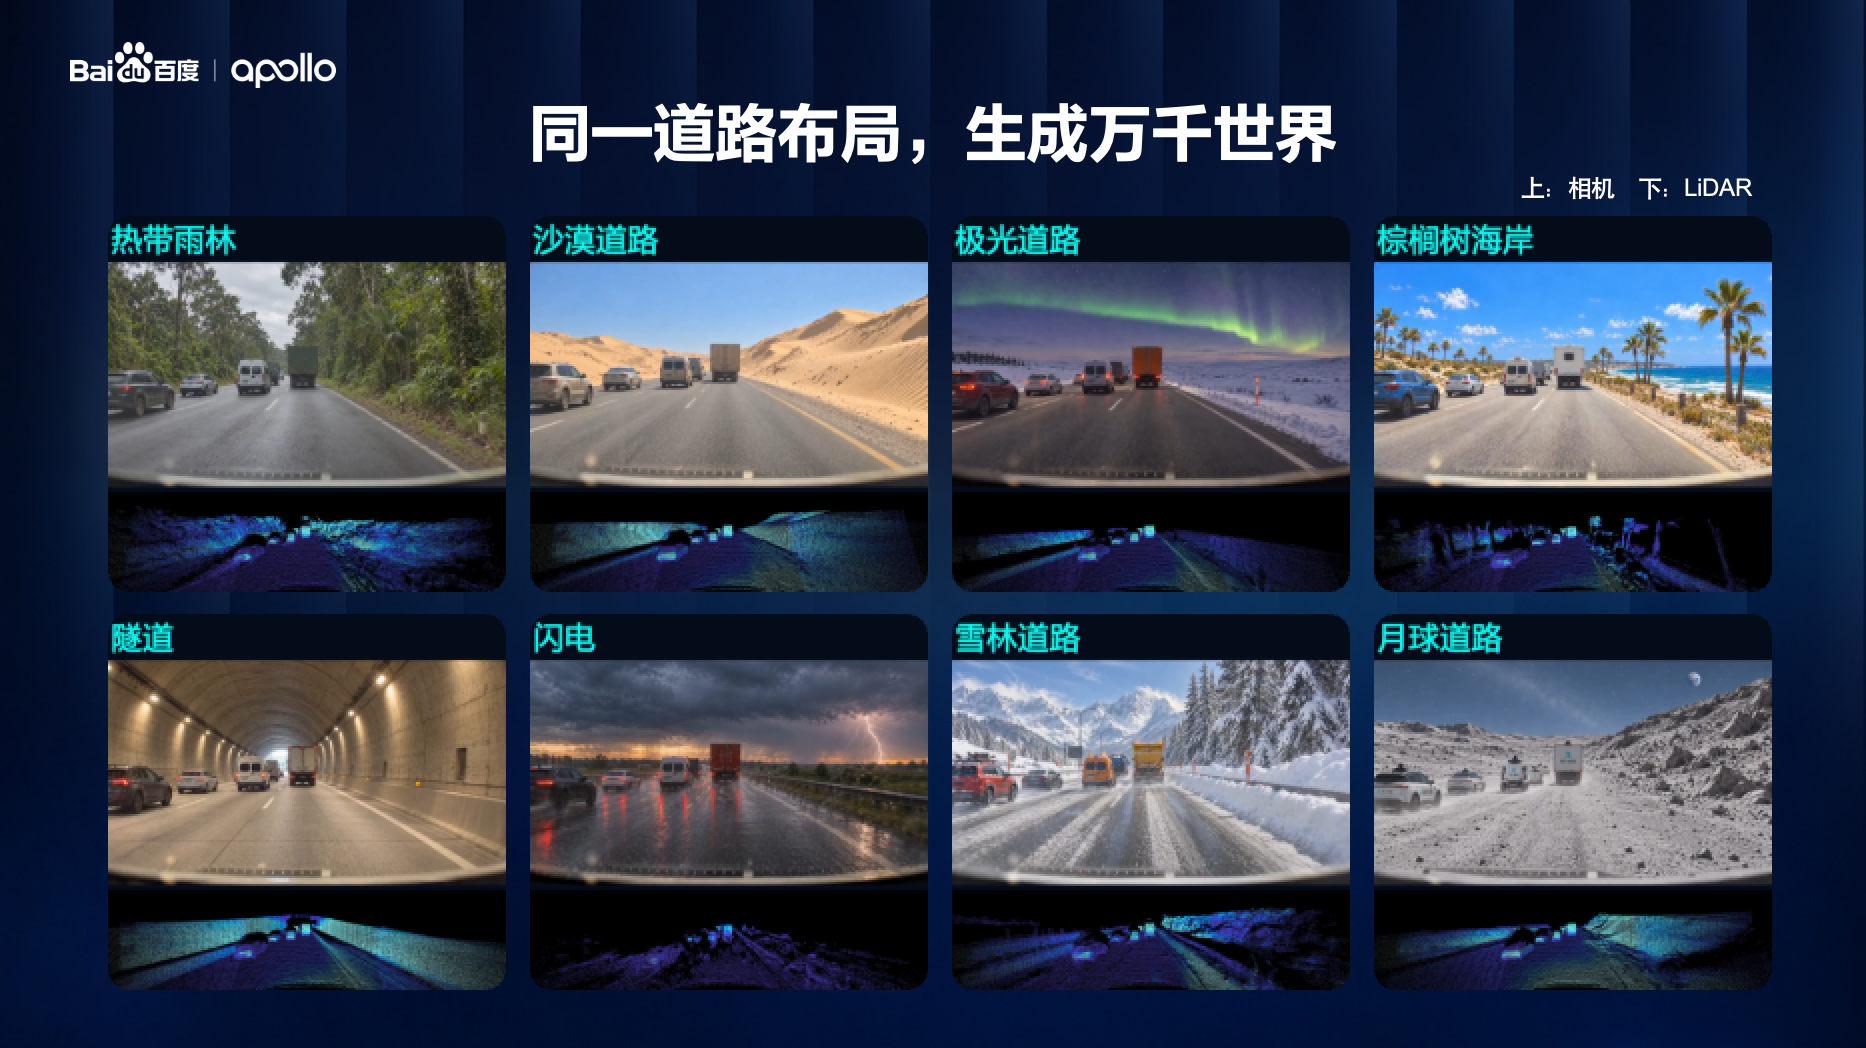
Laut einem Bericht von InfoQ China hat Baidu am 3. November auf der AI Day·Apollo-Sonderveranstaltung in Shenzhen erstmals das Weltmodell Apollo World für physische KI vorgestellt und einen „2+3“-Kriterienkatalog für Weltmodelle präsentiert. Die „2“ steht für zwei Grundschwellen: Kausalität, wonach das Modell der Zeit nur in eine Richtung folgen und aus dem aktuellen Zustand den nächsten Schritt ableiten muss, statt Bilder zusammenzusetzen und daraus die Vergangenheit zu rekonstruieren; und Interaktivität, wonach von außen eingegebene Aktionen den zukünftigen Weltzustand verändern können müssen. Die „3“ umfasst drei fortgeschrittene Kennzahlen: physikalische Genauigkeit, Persistenz über lange Laufzeiten (ob Objekte und Details driften) sowie Echtzeitfähigkeit, bei der die Inferenzzeit nicht mit steigender Szenenkomplexität zunehmen darf. Wang Liang, Chefarchitekt von Baidu IDG, sagte, ein Weltmodell dürfe nicht nur ein „Maler“ sein, der Videos erzeugt, sondern müsse ein „Prüfer“ werden, der die Sicherheit des autonomen Fahrens validiert; der Bericht erwähnt, dass der Sicherheitsentscheidungszyklus auf offener Straße auf 1/30 Sekunde begrenzt werden müsse. Yang Ze, verantwortlich für Apollo World, erklärte, Fahrzeuge und Fußgänger in der virtuellen Stadt würden als Agenten mit Entscheidungs- und Interaktionsfähigkeit modelliert. Apollo World könne in Echtzeit multimodale Beobachtungen wie Kamera- und Lidardaten erzeugen, die das Fahrzeug direkt wahrnehmen kann, und zwischen beliebigen Start- und Zielpunkten einen vollständigen Fahrtablauf vom Annehmen des Auftrags über die Fahrgastbeförderung bis zur Ankunft unterstützen, statt nur isolierte Szenen zu simulieren. Dem Bericht zufolge wird das Modell bereits für globale Tests und Validierung von Apollo Go eingesetzt; sein Technologie-Stack lasse sich auch auf Robotik und andere Szenarien physischer KI erweitern.
Auswirkungen für Entwickler
Für die meisten Entwickler liegt der praktisch relevante Teil dieser Meldung nicht darin, dass „ein weiteres aufrufbares Modell“ hinzugekommen ist, sondern darin, dass das Weltmodell von einer Frage des visuellen Eindrucks in messbare technische Probleme zerlegt wird. Der Bericht sagt ausdrücklich, dass Apollo World dem internen End-to-End-Training und der Validierung des autonomen Fahrens bei Baidu dient; öffentliche Schnittstellen oder Gewichte werden nicht genannt. Kurzfristig ändert sich daher für niemanden die Liste der API-Optionen. Die vorgeschlagenen Kriterien dürften jedoch in Simulation und Evaluierung einfließen: Wird „steigende Komplexität ohne steigende Inferenzzeit“ als harte Kennzahl behandelt, gibt es eine klare Eintrittsschwelle für geschlossene Simulationsschleifen; wird akzeptiert, dass „Verkehrsteilnehmer reaktionsfähige Agenten sind“, zeigen Evaluierungen auf Basis von Log-Replay blinde Flecken in der Abdeckung. Teams für Embodied-KI, Simulation des autonomen Fahrens oder Pipelines für synthetische Daten können diese Aufteilung direkt als interne Prüfliste übernehmen. Umgekehrt stammen die Kennzahlen vom bewerteten Anbieter selbst und bevorzugen naturgemäß dessen Stärken; gerade physikalische Genauigkeit und Persistenz sind am schwersten zu quantifizieren. Wer sie ungeprüft übernimmt, erhält leicht eine Abnahmeliste, die vollständig aussieht, aber tatsächlich keine Unterschiede messbar macht.
Integration und Bewertung
Für die drei im Bericht genannten Veränderungen empfiehlt es sich, jeweils eine Entscheidung zu treffen und die Kriterien vorab schriftlich festzulegen. Erstens, interaktive Teilnehmer: Dem Bericht zufolge verfügen andere Verkehrsteilnehmer über Entscheidungs- und Interaktionsfähigkeit. Zu entscheiden ist, ob die Simulationsgrundlage von Log-Replay auf interaktive Agenten umgestellt wird. Voraussetzung ist, dass die Ziel-Fehlermodi selbst von spieltheoretischen Interaktionen abhängen (ungeschützte Abbiegevorgänge, Einfädeln, Vorfahrt gewähren) und eine Replay-Baseline zum Vergleich existiert. Das Kriterium: dieselben Szenarien in beiden Modi fahren und Kollisionen sowie Beinaheunfälle pro 100 Kilometer vergleichen, ebenso den Anteil, in dem das Ego-Fahrzeug lange stehen bleibt oder wiederholt Anläufe unternimmt. Eine Umstellung ist nur gerechtfertigt, wenn der interaktive Modus deutlich mehr Ausfälle zeigt und die Richtung mit den Übernahmeaufzeichnungen aus realen Fahrten übereinstimmt. Zweitens, geschlossene Fahrtkette: Der Bericht betont kontinuierliche Aufgaben über Straßenabschnitte hinweg statt isolierter Szenen. Zu entscheiden ist, ob das Abnahmekriterium von der Bestehensrate einzelner Szenarien auf die Abschlussrate kontinuierlicher Fahrten wechselt. Voraussetzung ist ein End-to-End-System, bei dem sich Fehler über die Zeit akkumulieren. Das Kriterium: Abschlussrate und Anzahl der Übernahmen auf virtuellen Fahrten von mehreren Dutzend bis hundert Kilometern erfassen und die Fahrt nach Straßenabschnitten aufteilen, um per Regression zu lokalisieren, wo die Fehlerakkumulation beginnt. Steigen die Einzelszenarien-Werte, während die Abschlussrate kontinuierlicher Fahrten unverändert bleibt, hat die Kennzahl das eigentliche Problem nicht erfasst. Drittens, Echtzeitbudget: Der Bericht listet „Komplexitätszunahme ohne Auswirkung auf die Inferenzzeit“ als Kennzahl. Zu entscheiden ist, ob das Weltmodell in die geschlossene Schleife kommt oder nur der Offline-Datenerweiterung dient. Voraussetzung sind geschlossene Simulation und Hardware-in-the-Loop. Das Kriterium: die p99-Latenz pro Schritt bei steigender Agentenzahl und zunehmenden Sensormodalitäten messen. Sobald das Budget des Entscheidungszyklus überschritten wird, muss die Szenenkomplexität begrenzt oder auf offline zurückgegangen werden; sonst sind die Ergebnisse der geschlossenen Schleife selbst nicht glaubwürdig. Zudem wird die Drift bei langen Laufzeiten separat aufgeführt; für einen einzelnen Rollout sollte eine Höchstdauer gesetzt und mit simulierten Stunden als x-Achse beobachtet werden, ob Identität und Geometrie derselben Teilnehmer konsistent bleiben; bei Überschreiten eines Schwellenwerts wird zurückgesetzt. All dies sind bedingte Empfehlungen auf Basis des Berichts, nicht von Baidu offengelegte Verfahren.
Grenzen und offene Fragen
Apollo World ist derzeit nicht im Modellkatalog von KimiSeek; der Bericht nennt weder eine öffentliche API noch offene Gewichte oder Lizenzbedingungen. Es handelt sich um eine interne Trainings- und Validierungsinfrastruktur von Baidu; Verfügbarkeit, Bedingungen und Abrechnung einer möglichen künftigen externen Schnittstelle liegen allein bei Baidu. Der Bericht liefert keine quantitativen Ergebnisse zu Wiedergabetreue, Latenz oder Drift des Weltmodells. Die Angaben „100.000 Kilometer pro Tag“ und „entspricht etwa drei Jahren ununterbrochener Tests eines realen Testfahrzeugs“ sind als Analyse von Branchenbeobachtern gekennzeichnet, nicht als Messung von Baidu; es handelt sich um Analogien, nicht um Messwerte. Ob virtuelle Kilometer in reale Sicherheit übertragbar sind, stützt sich nur auf eine anbieterseitige Erzählung der geschlossenen Schleife; unabhängige Sim-to-Real-Validierungsdaten fehlen. Das „2+3“-Raster ist ein vom Anbieter selbst definiertes Framework; seine Verwendung als Abnahmeliste birgt ein Verzerrungsrisiko, und für physikalische Genauigkeit und Persistenz fehlen praktikable Schwellenwerte. Aussagen wie „über eine Million Kilometer im vollständig fahrerlosen End-to-End-Betrieb“ und „das einzige Unternehmen in China, das L4 mit End-to-End-Technologie in großem Maßstab betreibt“ sind Unternehmensaussagen, ohne dass eine Prüfung durch Dritte ersichtlich ist. Die Erweiterung auf Robotik und andere Szenarien wird als „erweiterbarer“ Technologie-Stack beschrieben, nicht als bereits demonstrierte Fähigkeit. Die zitierte Marktprognose für physische KI stammt von einem Drittforschungsinstitut und steht in keinem direkten Zusammenhang mit den Fähigkeiten des Modells.
Abbildungen aus dem Originalbericht