Cantina veröffentlicht apex-flash-1: Open-Weight-Schwachstellenforschungsmodell auf Basis eines GLM-5.3-Flash-Finetunings löst 40 von 60 zurückgehaltenen Aufgaben
Laut einem MarkTechPost-Bericht vom 4. Oktober 2026 hat Cantina Security gemeinsam mit Yeta Labs das Open-Weight-Modell apex-flash-1 veröffentlicht. Es wurde mit GRPO auf GLM-5.3-Flash feingetunt, unter MIT-Lizenz auf Hugging Face veröffentlicht und gibt laut eigener Angabe an, 40 von 60 zurückgehaltenen Schwachstellenaufgaben gelöst zu haben, wobei BF16-Gewichte etwa 640 GB VRAM benötigen.
Was sich geändert hat
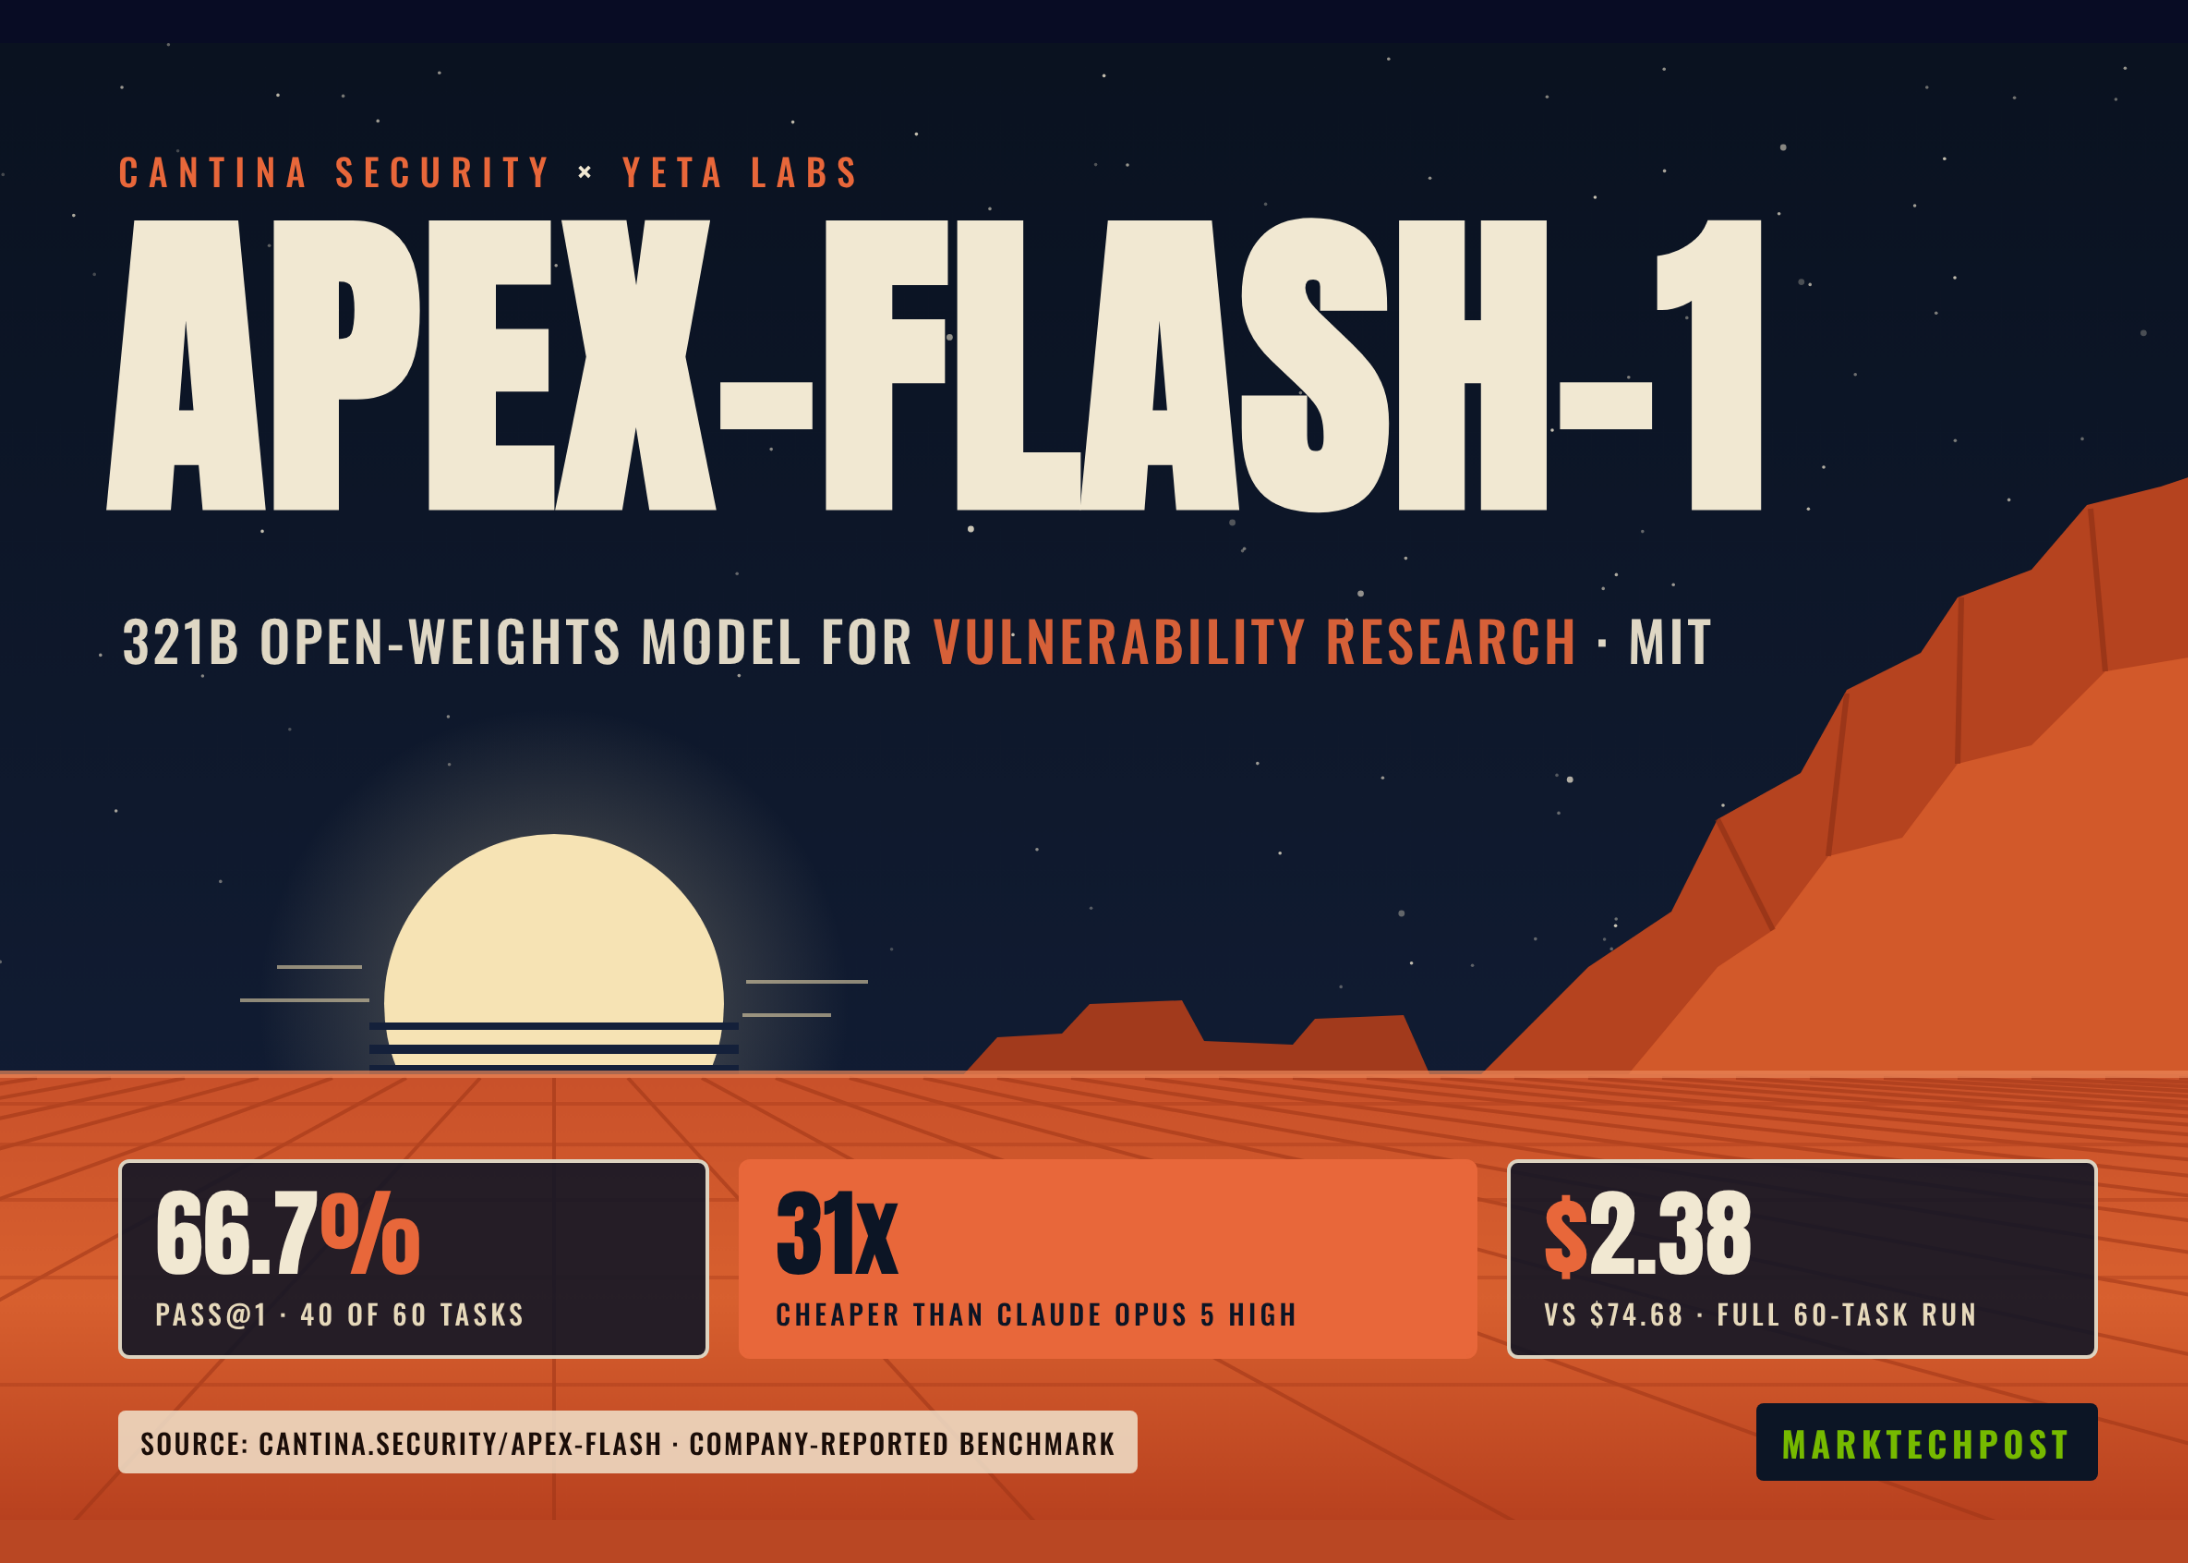
Laut einem MarkTechPost-Bericht vom 4. Oktober 2026 hat Cantina Security gemeinsam mit Yeta Labs apex-flash-1 veröffentlicht. Das Modell ist das Ergebnis eines Reinforcement-Learning-Finetunings von Z.ai's GLM-5.3-Flash (MoE, insgesamt etwa 320 Milliarden Parameter, 18 Milliarden aktiv) und die Gewichte wurden auf Hugging Face unter MIT-Lizenz veröffentlicht. Der Bericht nennt eine Gesamtparameterzahl von 321,3 Milliarden; für das Training wurden GRPO, rank-256 LoRA und selektives Vollparametertraining verwendet; die Daten bestehen aus 150 Aufgaben, die aus 50 realen Schwachstellenfällen abgeleitet wurden, wobei jeder Fall drei Varianten umfasst: geführtes White-Box, fokussiertes White-Box und fokussiertes Black-Box. Unter den Falltypen entfallen 72 % auf Autorisierungs-, Identitäts- und Berechtigungsumfangsfehler, 18 % auf Buchhaltungs- und numerische Genauigkeitsfehler, der Rest auf Zeitvalidierung, Geschäftsregeln und SSRF. Der Bericht zitiert die Modellkarte, wonach Rollouts in einem Codex-Agent-Harness ausgeführt werden. Zur Bewertung wählte Cantina aus 20 zurückgehaltenen Fällen 60 Aufgaben aus und ließ jedes Modell einmal laufen: apex-flash-1 löste 40/60 (66,7 % pass@1, etwa 2,38 US-Dollar), das Basismodell GLM-5.3-Flash 36/60 (60,0 %, etwa 4,56 US-Dollar) und Claude Opus 5 High 43/60 (71,7 %, etwa 74,68 US-Dollar). Der Bericht erwähnt außerdem eine experimentelle Variante apex-flash-1-abliterated, deren Verweigerungsverhalten geändert wurde und die nicht separat evaluiert wurde. Cantina positioniert es als Arbeitsmodell, das von größeren Modellen orchestriert wird, für Verteidiger-Szenarien mit lokaler, selbstkontrollierter Bereitstellung. Es ist anzumerken, dass die genannten Benchmarks und Kosten interne, vom Anbieter selbst berichtete Daten sind.
Auswirkungen für Entwickler
Die Auswirkungen auf Entwickler lassen sich in drei Ebenen unterteilen. Erstens Lizenz- und Nutzungsgrenzen: Der Bericht gibt an, dass die Gewichte unter MIT-Lizenz veröffentlicht wurden, was etwas anderes ist als "die Gewichte sind herunterladbar" – MIT ist eine Lizenzklausel, die kommerzielle Nutzung und Weiterverbreitung relativ klar regelt, aber maßgeblich sind die LICENSE- und NOTICE-Dateien im offiziellen Repository; der Bericht erläutert nicht Punkt für Punkt, ob eine separate Nutzungsrichtlinie beiliegt. Zweitens die Bereitstellungskostenstruktur: Der Bericht gibt an, dass BF16-Gewichte etwa 640 GB VRAM benötigen, was nicht auf einer einzelnen Karte machbar ist; Selbsthosting erfordert Mehrkartenknoten oder quantisierte Portierungen; der Bericht erwähnt, dass es bereits eine 4-Bit-Portierung in der Community gibt, nennt aber keine Qualitätsbewertung. Der Einfluss der Quantisierung auf Schwachstellenausnutzungsaufgaben ist unbekannt und muss selbst verglichen werden. Drittens die Aufgabenanpassung: 72 % der Trainingsdaten konzentrieren sich auf Autorisierungs-, Identitäts- und Berechtigungsumfangsfehler; die Leistung bei solchen Aufgaben lässt sich nicht auf Speichersicherheit, Nebenläufigkeit, Kryptografie oder Lieferketten-Schwachstellen übertragen. Die Bewertung sollte nach Fehlerkategorien geschichtet statistisch erfolgen und nicht nur den gesamten pass@1 betrachten. Darüber hinaus positioniert der Bericht das Modell als "Arbeitsmodell", das von größeren Modellen orchestriert wird, was nahelegt, dass die erwartete Integrationsweise ein Ausführungsschritt in einem Agent-Harness ist; der Grad der Ausrichtung von Schnittstellen und Tool-Aufrufprotokollen wirkt sich direkt auf die Nutzbarkeit aus. Zum aktuellen Katalogstatus: apex-flash-1 hat keinen exakten Treffer im KimiSeek-Live-Katalog. Wenn der Aufruf des Basismodells GLM-5.3-Flash erforderlich ist, gibt es einen gleichnamigen Eintrag im Katalog, aber die Kataloginformationen belegen nur die aktuelle Aufrufbarkeit und können nicht als Beleg für die Benchmarks, Preise oder Gewichte des Berichts dienen.
Integration und Bewertung
Das Folgende sind Empfehlungen und bedingte Analysen, keine Tatsachenbehauptungen aus dem Bericht. Empfehlung eins: Führen Sie zunächst einen kleinen Vergleich nach Fehlerkategorien durch, bevor Sie in Selbsthosting investieren. Die konkrete Änderung im Bericht ist, dass 72 % der Trainingsdaten auf Autorisierungs-, Identitäts- und Berechtigungsumfangsfehler konzentriert sind; die entsprechende Entscheidung ist, ob apex-flash-1 oder das Basismodell GLM-5.3-Flash gewählt wird, unter der Voraussetzung, ob die Zielaufgaben in diese Kategorien fallen; das messbare Bewertungskriterium ist der Vergleich der pass@1-Differenz zwischen beiden auf 20 bis 30 eigenen zurückgehaltenen Autorisierungsaufgaben. Wenn die Verbesserung weniger als etwa 5 Prozentpunkte beträgt, lohnt sich der zusätzliche Betriebsaufwand für eine Mehrkarten-Bereitstellung nicht. Empfehlung zwei: Legen Sie eine Erfolgsschwelle für Tool-Aufrufe bei der Agent-Integration fest. Der Bericht gibt an, dass Rollouts in einem Codex-Agent-Harness ausgeführt werden, und nennt Codelesen, Tool-Aufrufe, Schwachstellenausnutzungsentwicklung und -validierung als Zielkompetenzen; die entsprechende Entscheidung ist, es als Ausführenden und nicht als Planer im Agent einzusetzen, unter der Voraussetzung, dass Ihr Harness-Tool-Schema dem Trainingsumfeld ähnelt; das messbare Bewertungskriterium ist die Erfassung der formalen Gültigkeitsrate und der End-to-End-Abschlussrate bei 50 echten Tool-Aufrufen. Wenn die formale Gültigkeitsrate unter etwa 95 % liegt, sollte zuerst eine Ausgabeprüfungsschicht vor der Anbindung hinzugefügt werden. Empfehlung drei (bedingt): Ob bei unzureichendem VRAM eine 4-Bit-Community-Portierung gewählt werden sollte. Der Bericht erwähnt, dass eine 4-Bit-Portierung existiert, aber keine Qualitätsdaten vorliegen; die entsprechende Entscheidung ist die Abwägung zwischen dem Warten auf offizielle Quantisierung und der Übernahme der Community-Portierung, unter der Voraussetzung, ob Ihre Aufgaben empfindlicher auf numerische Genauigkeit oder auf Durchsatz reagieren; das messbare Bewertungskriterium ist, dieselbe Gruppe von 60 Aufgaben vor und nach der Quantisierung auszuführen und den Rückgang der gelösten Anzahl zu vergleichen. Wenn der Rückgang 3 bis 5 Aufgaben übersteigt, ist sie nicht als direkter Ersatz für BF16 bei der automatisierten Schwachstellenvalidierung geeignet.
Grenzen und offene Fragen
Alle Benchmark-Daten (66,7 % pass@1, 40/60, etwa 2,38 US-Dollar usw.) sind von Cantina selbst berichtete interne Ergebnisse, die Stichprobe stammt aus 20 zurückgehaltenen Fällen mit insgesamt 60 Aufgaben, ist klein und die Aufgabenverteilung wurde nicht vollständig offengelegt; eine unabhängige Reproduktion steht aus. Der Bericht legt die Bewertungsregeln, ob mehrere Versuche erlaubt waren und die Kriterien für "gelöst" nicht offen; pass@1 kann je nach Implementierung unterschiedliche Bedeutungen haben. Die Variante apex-flash-1-abliterated wurde nicht separat evaluiert; die Auswirkungen der geänderten Verweigerungshaltung auf die Sicherheit sind völlig unbekannt. Bezüglich des Hardwarebedarfs nennt der Berichtstext etwa 640 GB, die Quertabelle etwa 642 GB und die Parametertabelle BF16 328 GB – mehrere Zahlen sind inkonsistent; bei der Auswahl ist die tatsächliche Gewichtsdateigröße im offiziellen Repository maßgeblich; für die 4-Bit-Community-Portierung gibt es keine Qualitätsdaten. Zur diesmaligen Katalogprüfung: Die Version apex-flash-1 erscheint derzeit nicht im KimiSeek-Live-Katalog. Jegliche in diesem Artikel erwähnte API-Verfügbarkeit oder Aufrufkosten beziehen sich auf den Anbieter oder Drittanbieter und bedeuten nicht, dass sie direkt auf dieser Plattform aufgerufen werden können; das Basismodell GLM-5.3-Flash hat einen gleichnamigen Eintrag im Katalog, aber diese Kataloginformation spiegelt nur die aktuelle Aufrufbarkeit wider und stellt keinen Beleg für die Benchmarks oder Preise des Berichts dar. Das Berichtsdatum ist der 4. Oktober 2026; die darin enthaltenen Kostenvergleiche und Schlussfolgerungen sind zeitgebunden und sollten nicht als aktueller Stand betrachtet werden; bei Preisinformationen ist die offizielle Preisseite maßgeblich.