EmbeddingGemma 2 als offene Gewichte: 740 Mio. Parameter, gemeinsamer 768-dimensionaler Raum, Code- und Audio-Retrieval als neue Variablen
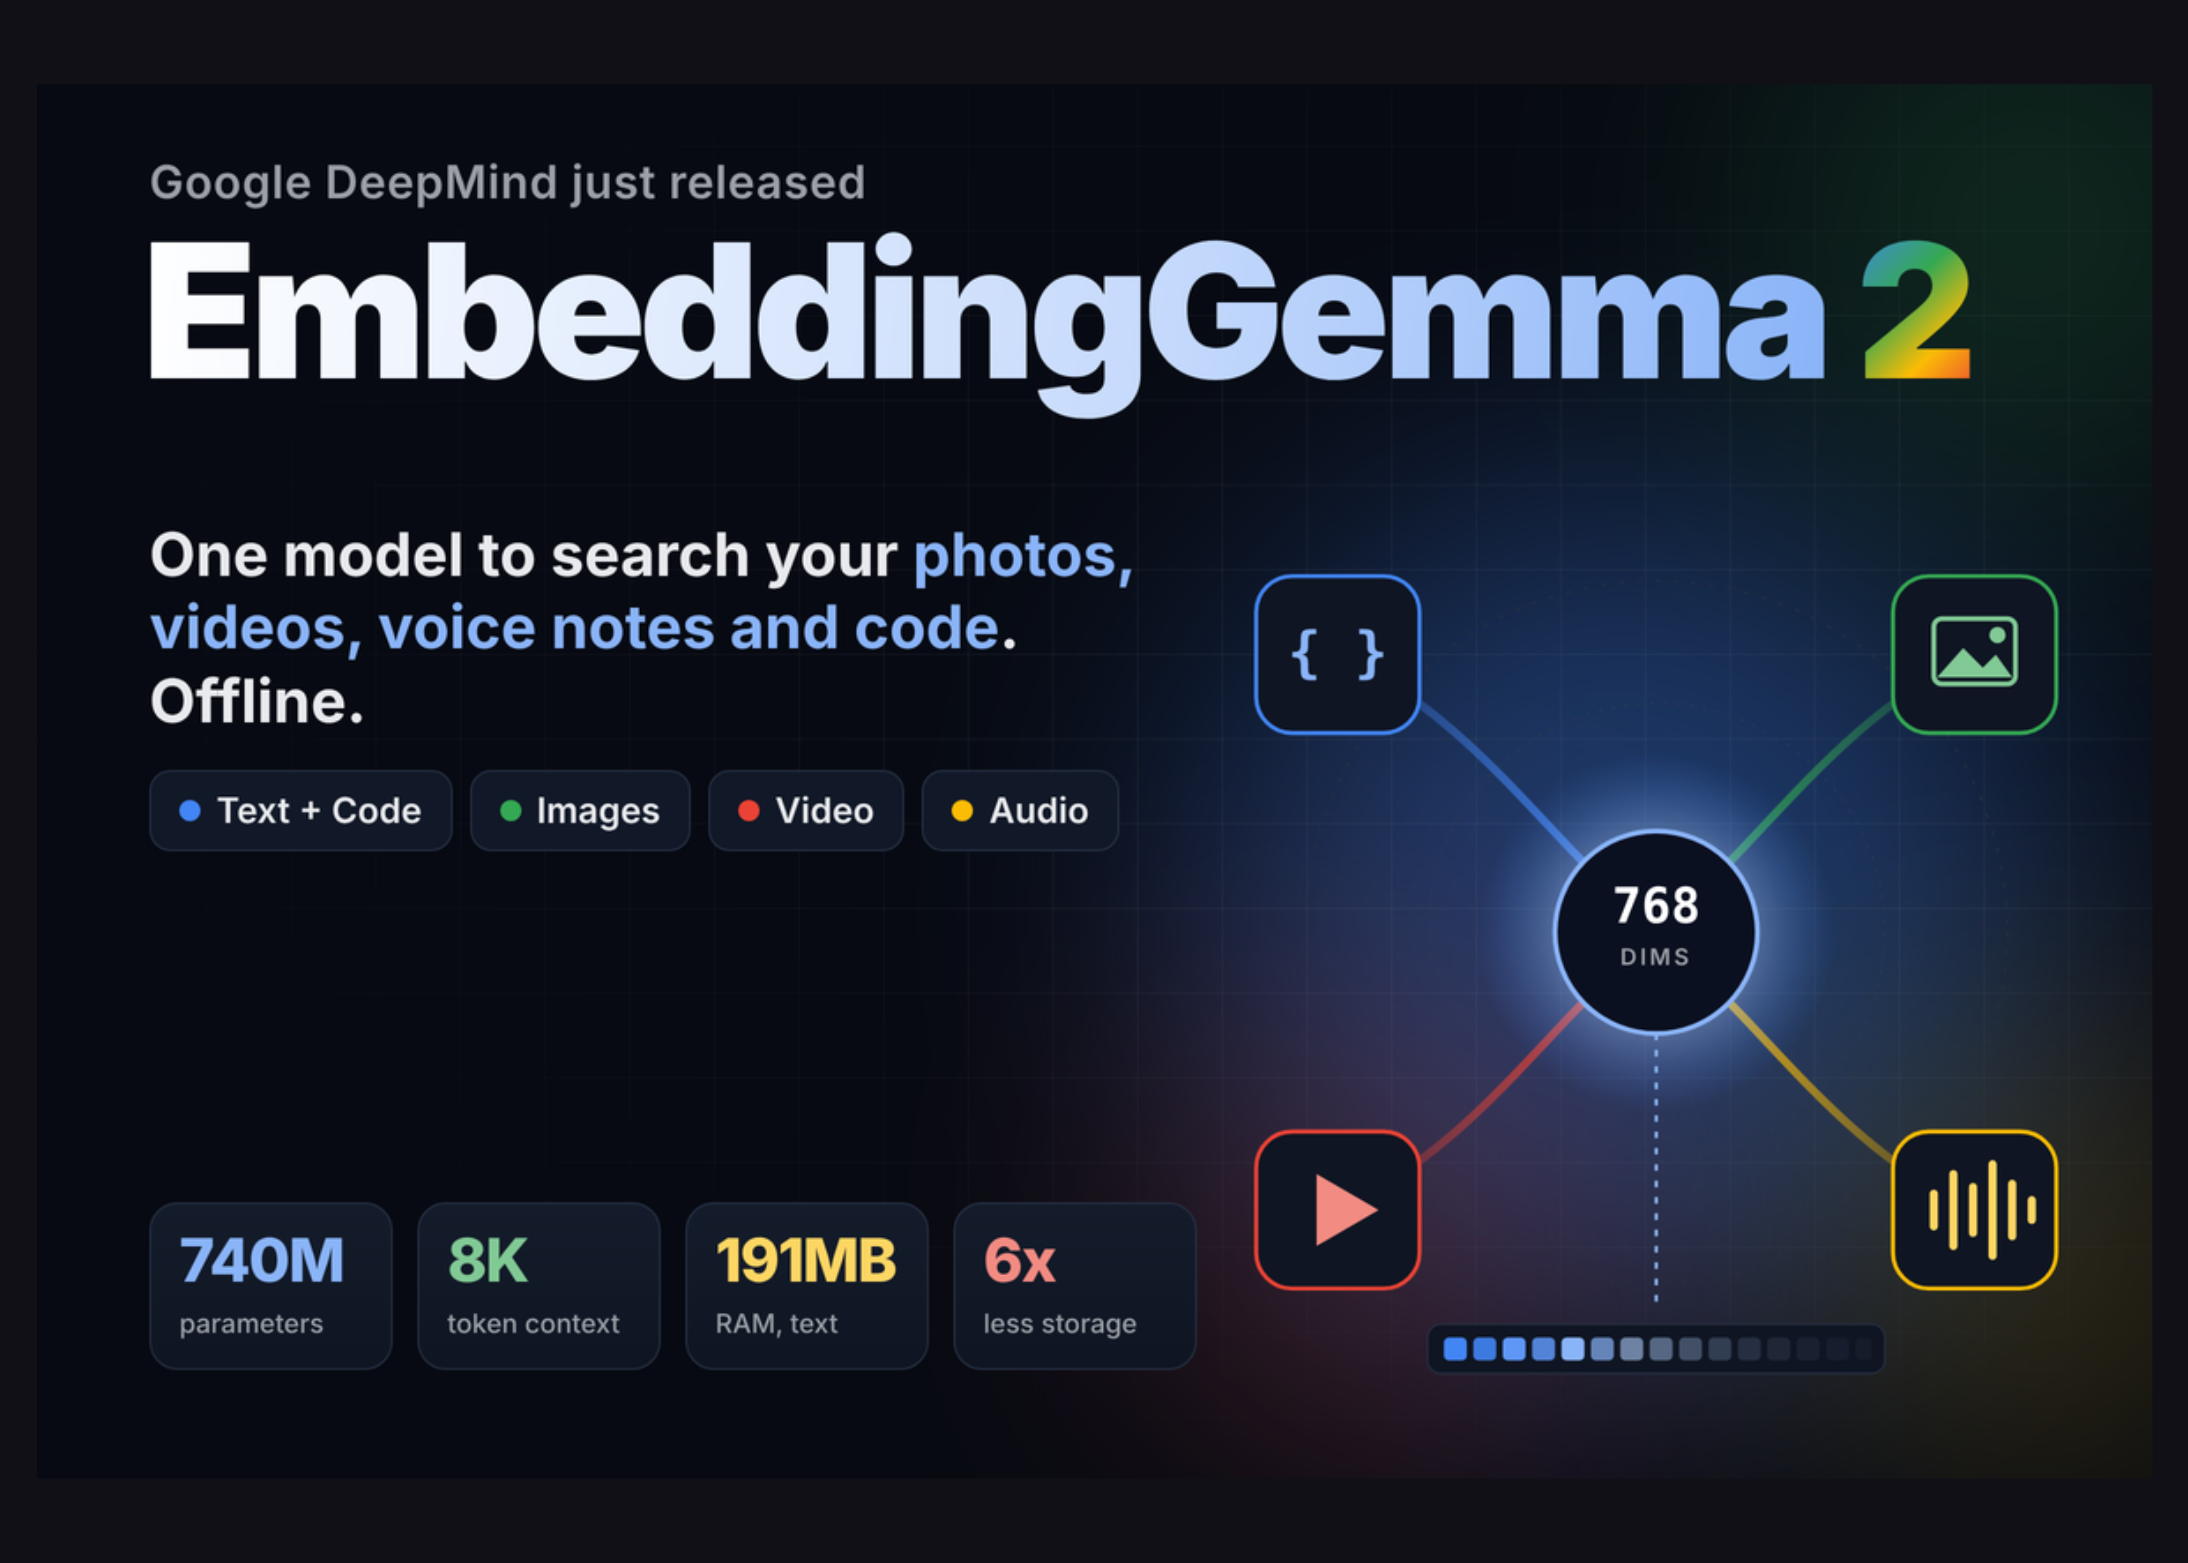
Laut einem MarkTechPost-Bericht vom 6. Oktober 2026 hat Google DeepMind EmbeddingGemma 2 veröffentlicht: ein multimodales Embedding-Modell mit offenen Gewichten, 740 Mio. Parametern, 8K-Kontext und Apache-2.0-Lizenz, das Text, Code, Bilder, Videos und Audio in denselben 768-dimensionalen Raum abbildet. Der Text-Backbone mit 270 Mio. Parametern lässt sich separat laden.
Was sich geändert hat
Laut einem MarkTechPost-Bericht vom 6. Oktober 2026 hat Google DeepMind EmbeddingGemma 2 veröffentlicht, ein multimodales Embedding-Modell mit offenen Gewichten auf Basis der Gemma-4-Architektur unter Apache-2.0-Lizenz. Es bildet verschiedene Modalitäten mit modularen Encodern in denselben 768-dimensionalen Vektorraum ab: Der Text- und Code-Backbone umfasst rund 270 Mio. Parameter (130 Mio. Transformer plus 140 Mio. Embedder), ein visueller Encoder mit 170 Mio. Parametern ist optional, ein Audio-Encoder mit 300 Mio. Parametern ebenfalls, vollständig geladen sind es rund 740 Mio. Parameter; Entwickler können nur die benötigten Teile laden. Das Kontextfenster beträgt 8192 Token, laut Bericht viermal so groß wie das der ersten Generation und ausreichend für etwa 29 Bilder, 58 Videoframes oder 5,5 Minuten Audio. Laut Model Card stieg MTEB Code v1 von 68,76 der Vorgängergeneration auf 78,68, MTEB multilingual v2 von 61,15 auf 61,36, und neue Werte kamen hinzu: MIEB lite Bild 64,64, MMEB v2 Gesamtwert 59,01 sowie MAEB Audio 49,39. Dem Bericht zufolge sind die Gewichte auf Hugging Face und Kaggle verfügbar, mit Betriebswegen über Ollama, llama.cpp GGUF, LiteRT, sentence-transformers v6.1.0+, vLLM, SGLang, MLX, LM Studio und MediaPipe; die Vektorspeicherung wird von Qdrant unterstützt, das Fine-Tuning von Unsloth; MRL erlaubt das Kürzen von Vektoren auf 512, 256 oder 128 Dimensionen.
Auswirkungen für Entwickler
Für Entwickler liegt die entscheidende Veränderung dieser Veröffentlichung nicht in der Parameterzahl, sondern darin, dass derselbe Vektorraum zugleich Code und Audio abdeckt und sich der Text-Backbone separat laden lässt. Das verändert direkt drei Auswahlentscheidungen. Erstens brauchte die Retrieval-Schicht multimodaler RAG-Systeme bisher oft zwei Embedding-Modelle für Text und Bild, zwei Indizes und eine Score-Normalisierung; der Bericht besagt, dass Abfragevektoren aus einer reinen Textkonfiguration zu Dokumentvektoren des vollständigen Modells passen können. Sollte sich das reproduzieren lassen, könnte man zunächst mit dem 270-Mio.-Parameter-Backbone einen Index aufbauen und später visuelle oder Audio-Encoder ergänzen, ohne die Datenbank neu aufzubauen. Zweitens rückt der Anstieg im Code-Retrieval-Benchmark (laut Bericht rund 9,92 Punkte bzw. rund 14 Prozent) das Modell in die Kandidatenliste für semantische Suche in Codebasen, doch das sind Zahlen aus einer Hersteller-Model-Card und keine Aussage über die Leistung im eigenen Repository. Drittens ergibt sich ein anderer Kompromiss als bei Alis Qwen3-VL-Embedding-2B: Letzteres berichtete laut Bericht in eigenen MMEB-v2-Tests 73,2 Punkte, hat etwa 2,7-mal so viele Parameter und unterstützt kein Audio; EmbeddingGemma 2 betont dagegen 8K-Kontext, Speicherbedarf am Edge und Audio-Unterstützung. Zu beachten ist, dass offene Gewichte nicht mit einer uneingeschränkten Open-Source-Lizenz gleichzusetzen sind: Apache 2.0 ist eine permissive Lizenz, doch Herkunft der Trainingsdaten und Anforderungen an die Downstream-Compliance müssen selbst geprüft werden. Zudem enthält der aktuelle Modellkatalog von KimiSeek keinen Eintrag namens EmbeddingGemma 2; diese Version ist derzeit nicht auf KimiSeek verfügbar. Die im Bericht genannte Verfügbarkeit bezieht sich auf externe Kanäle wie Hugging Face, Kaggle oder Ollama; sollte es künftig ein API-Angebot geben, gilt die Seite des jeweiligen Anbieters.
Integration und Bewertung
Das Folgende sind Empfehlungen und Bedingungsanalysen, keine berichteten Fakten. Empfehlung eins: Zuerst klären, ob Cross-Modal-Retrieval überhaupt nötig ist. Wer nur chinesischen Text und Code verarbeitet und bereits ein ausgereiftes Text-Embedding-Modell nutzt, sollte EmbeddingGemma 2 als A/B-Kandidaten behandeln statt sofort zu ersetzen; zunächst mit denselben eigenen Abfragen und Dokumenten Recall-Experimente fahren und mit Recall@10 und nDCG@10 bewerten, nicht nur mit MTEB-Werten. Enthält die Workload tatsächlich gemischte Text-Bild-Inhalte oder die Suche in Sprachnotizen, lohnt es sich, die Annahme des gemeinsamen Vektorraums vorrangig zu prüfen: Index mit dem 270-Mio.-Text-Backbone aufbauen, dieselben Text-Bild-Dokumente mit dem vollständigen Modell einbetten und die Konsistenz der Ähnlichkeiten über Konfigurationen messen. Driftet die Relevanzreihenfolge deutlich, braucht jede Konfiguration einen eigenen Index. Empfehlung zwei: Abwägung zwischen Dimension und Speicher. Laut Bericht sinkt MTEB multilingual bei 256 Dimensionen nur leicht von 61,36 auf 60,41, während MMEB bei 128 Dimensionen auf 45,65 fällt; die offizielle Empfehlung sieht 128 Dimensionen vor allem für reinen Text vor. Ist der Engpass der Speicherbedarf der Vektordatenbank und das Szenario reiner Text, kann man zuerst auf 256 Dimensionen umstellen und testen. Geht es um Bild- oder Videosuche, sollten 768 Dimensionen beibehalten und auf eigenen Daten der Recall-Unterschied zwischen 256 und 768 Dimensionen verglichen werden; erst dann mit einer akzeptablen Recall-Verlustschwelle entscheiden. Empfehlung drei: Lock-in-Risiko im Deployment-Stack. Es gibt viele Laufzeitoptionen; die Wahl sollte sich am Ziel Server oder Edge orientieren, und Vektordimension, Prompt-Vorlagen (die im Bericht genannten Prompt-Namen SearchQuery und Document) sowie Quantisierungsmethode gehören gemeinsam in die Konfiguration. Vor und nach der Quantisierung je einmal mit einem festen Regressionsset laufen lassen und die Recall-Unterschiede vergleichen. Für die Bewertung unbedingt eigene Unternehmensdaten statt öffentlicher Ranglisten verwenden, denn die mehrsprachige Qualität blieb im Bericht nahezu unverändert; die Verbesserungen konzentrieren sich auf Code und die neuen Modalitäten.
Grenzen und offene Fragen
Alle genannten Benchmarks, Speicherbedarfs- und Latenzwerte stammen aus der Google-Model-Card oder aus Angaben des Forschungsteams, sind also Herstellerberichte und nicht unabhängig von Dritten reproduziert; die 191 MB und 567 MB am Edge sind der aktive Speicher nach Quantisierung auf einem bestimmten Gerät (Pixel 11 Pro) und lassen sich nicht ohne Weiteres auf andere Hardware übertragen. Der Bericht legt Zusammensetzung der Trainingsdaten und Sprachverteilung nicht offen; die tatsächliche Leistung in chinesischen Szenarien muss selbst überprüft werden. Im modellübergreifenden Vergleich sind die 73,2 Punkte von Qwen3-VL-Embedding-2B dessen eigene MMEB-v2-Angabe; einzelne Vergleiche und Werte aus verschiedenen Ranglisten lassen sich nicht direkt nebeneinanderstellen. Außerdem erscheint die Version EmbeddingGemma 2 derzeit nicht im Modellkatalog von KimiSeek; dieser Artikel behandelt sie daher nicht als auf KimiSeek verfügbares Modell. Die im Bericht erwähnte Veröffentlichung der Gewichte, das Ziehen per Ollama und die Unterstützung durch diverse Laufzeiten beziehen sich auf Veröffentlichungen externer Anbieter oder Communities; maßgeblich für Verfügbarkeit und künftige Preise sind die offiziellen Seiten der jeweiligen Plattform. Der Bericht nennt eine ML-Kit-Unterstützung für Android, die innerhalb weniger Wochen erscheinen soll; das ist ein Plan und keine vollendete Tatsache und sollte nicht zur Grundlage der Terminplanung gemacht werden.
Abbildungen aus dem Originalbericht