EmbeddingGemma 2 veröffentlicht: 740-Millionen-Parameter-Multimodal-Embedding-Modell unter Apache 2.0
Laut einem offiziellen Blog von Google DeepMind vom 6. Oktober 2026 wurde EmbeddingGemma 2 unter der Apache-2.0-Lizenz veröffentlicht, mit 740 Millionen Parametern. Es soll Text, Code, Bilder, Audio und Video in einen einheitlichen Embedding-Raum abbilden und 8K-Kontext sowie kürzbare Vektordimensionen unterstützen.

Was sich geändert hat
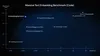
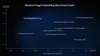
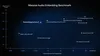
Laut einem am 6. Oktober 2026 veröffentlichten offiziellen Blog von Google DeepMind stellt Google DeepMind EmbeddingGemma 2 vor, ein multimodales Embedding-Modell für On-Device-Inferenz. Das Modell basiert auf der Gemma-4-Architektur, hat 740 Millionen Parameter und wird unter der Apache-2.0-Lizenz veröffentlicht. Die Quelle gibt an, dass es Kombinationen aus Text, Code, Bildern, Audio und Video nativ in einen einheitlichen Embedding-Raum abbilden kann und auf Technologie aus derselben Quelle wie Gemini Embedding setzt. Zu den von der Quelle berichteten Designpunkten gehören: für reine Text-Szenarien mindestens etwa 270 Millionen Parameter, ein visueller Encoder mit etwa 170 Millionen und ein Audio-Encoder mit etwa 300 Millionen als optionale Module; durch Matryoshka-Repräsentationslernen können die Ausgabevektoren von 768 Dimensionen auf 512, 256 oder 128 Dimensionen gekürzt werden, was laut Quelle bis zu etwa 6-fache Speichereinsparung bringt; das Kontextfenster beträgt 8K Token, laut Quelle das Vierfache von EmbeddingGemma 1, und kann etwa 5,5 Minuten Audio, 29 Bilder oder 58 Videoframes verarbeiten. Die von der Quelle genannten Benchmark-Daten umfassen einen Anstieg von MTEB Code von 68,76 auf 78,68, also eine Verbesserung um 9,92 Punkte bei Code-Aufgaben, und die Angabe, dass bei multimodalen Embedding-Modellen unter 1 Milliarde Parametern führende Ergebnisse erzielt werden. Die Quelle gibt außerdem an, dass nach Quantisierung auf einem Google Pixel 11 Pro die reinen Textgewichte etwa 191 MB aktiven Speicher benötigen und das vollständige multimodale Modell etwa 567 MB. Die Gewichte sind auf Hugging Face und Kaggle verfügbar; laut Quelle steht die Unterstützung im Gemini Enterprise Agent Platform Model Garden kurz bevor, und eine für On-Device optimierte Version befindet sich in der LiteRT Community auf Hugging Face.
Auswirkungen für Entwickler
Für Entwickler besteht die zentrale Veränderung dieser Veröffentlichung darin, dass die Fähigkeitsgrenze von Embedding-Modellen sich von Text auf Audio, Video und Code erweitert und die Gewichte unter Apache 2.0 veröffentlicht werden, sodass sie selbst feinabgestimmt und weiterverbreitet werden können. Das unterscheidet sich von geschlossenen Embedding-Diensten, die nur über Hersteller-APIs aufgerufen werden können. Zu beachten ist: Apache 2.0 ist eine Offenheit auf Lizenzebene, und ob Gewichte herunterladbar sind, ist davon zu trennen; die Lizenzinformationen in diesem Bericht stammen aus dem Quelltext, und vor der tatsächlichen Nutzung sollten Modellkarte und Lizenzdatei geprüft werden. Die Quelle gibt an, dass EmbeddingGemma 2 denselben Text-Tokenizer und Audio-Encoder wie Gemma 4 nutzt, was bedeutet, dass bei einer Kombination von Embedding-Modell und generativem Modell in derselben On-Device-Pipeline die Quelle einen geringeren Gesamtspeicherverbrauch erwartet, was direkte Auswirkungen auf die Bereitstellungskosten von Offline-RAG und On-Device-Agenten hat. Kürzbare Vektordimensionen sind eine weitere praktische Variable: Speicherung und Recall-Qualität von Vektordatenbanken stehen in der Regel in einem Spannungsverhältnis mit sinkender Dimension, und die Abwägung zwischen 128 und 768 Dimensionen muss anhand der eigenen Datenmenge gemessen werden, statt einfach die Werbeaussagen der Quelle zu übernehmen. Die Quelle erwähnt außerdem, dass die verfügbare Inferenz- und Deployment-Toolchain transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama, LMStudio sowie browser-seitig transformers.js und WebGPU umfasst, und nennt Qdrant für die Vektorspeicherung. Diese Toolnamen sind von der Quelle aufgeführte Deployment-Optionen und bedeuten nicht, dass diese Plattform das Modell bereits integriert oder verifiziert hat; diese Version hat derzeit keinen exakten Eintrag im Echtzeitkatalog von KimiSeek, und die von der Quelle genannten Download- und On-Device-Deployment-Möglichkeiten verweisen auf Kanäle der Herausgeber wie DeepMind und Hugging Face, nicht auf ein API-Angebot dieser Plattform.
Integration und Bewertung
Empfehlung eins: Entscheiden Sie zuerst, ob Sie multimodale Embeddings benötigen, und dann, ob Sie das vollständige Modell brauchen. Die Quelle berichtet, dass das vollständige multimodale Modell auf dem Pixel 11 Pro nach Quantisierung etwa 567 MB aktiven Speicher benötigt, reiner Text etwa 191 MB, und dass visuelle und Audio-Encoder optionale Module sind. Wenn Ihr Retrieval-Korpus nur Text und Code enthält, können Sie zunächst nur den Textpfad laden; nur wenn tatsächlich Audio- und Videorecherche benötigt wird, sollten Sie die entsprechenden Encoder einbeziehen. Ein praktikables Bewertungskriterium ist: auf dem Zielgerät oder der minimal akzeptablen Serverkonfiguration Kaltstartlatenz, Spitzenwert des dauerhaften Speichers und Embedding-Durchsatz pro Sekunde zu messen und zu prüfen, ob das Latenzbudget noch eingehalten wird. Empfehlung zwei: Führen Sie für die MRL-gekürzten Dimensionen ein eigenes Recall-Experiment durch, statt direkt die Standard-768-Dimensionen zu verwenden. Die Quelle nennt die drei Stufen 512, 256, 128 sowie eine Speichereinsparung von bis zu 6-fach, aber ob die Retrieval-Qualität akzeptabel ist, hängt von Ihrem Korpus und Ihrer Query-Verteilung ab. Als Bewertungskriterium kann dienen: auf einem eigenen annotierten oder manuell beurteilten Retrieval-Set die Unterschiede zwischen 768 Dimensionen und 256 sowie 128 Dimensionen bei Recall@10 und durchschnittlicher Query-Latenz zu vergleichen und niedrigere Dimensionen nur dann zu verwenden, wenn der Qualitätsverlust innerhalb Ihrer Geschäftsschwelle liegt. Empfehlung drei: Wenn Code-Retrieval das Hauptszenario ist, können Sie die von der Quelle berichtete MTEB-Code-Verbesserung als zu reproduzierenden Gegenstand betrachten. Als Bewertungskriterium kann dienen: in Ihrer eigenen Codebasis mit demselben Query-Set Trefferquote und sprachübergreifende Retrieval-Leistung von EmbeddingGemma 1 und EmbeddingGemma 2 getrennt zu messen, da absolute Werte öffentlicher Benchmarks keinen relativen Vergleich auf einer privaten Codebasis ersetzen. All dies sind Empfehlungen und bedingte Analysen auf Basis der Quellinformationen und keine von der Quelle berichteten Tatsachen.
Grenzen und offene Fragen
Zunächst muss klargestellt werden: EmbeddingGemma 2 hat derzeit keinen exakten Eintrag im Echtzeitkatalog von KimiSeek, diese Plattform hat das Modell nicht im Angebot, und die von der Quelle genannten Download- und On-Device-Deployment-Möglichkeiten verweisen auf Kanäle der Herausgeber wie DeepMind und Hugging Face, nicht auf ein API-Angebot dieser Plattform. Zweitens stammen die Benchmark-Werte in der Quelle (einschließlich des Anstiegs von MTEB Code von 68,76 auf 78,68 und der Aussage, unter 1 Milliarde Parametern führend zu sein) aus Angaben des Herausgebers; der Blog listet keine vollständigen Evaluationsbedingungen, Vergleichsmodelllisten und Evaluationsversionen auf und kann daher nicht als unabhängig verifiziertes Ergebnis gelten; die tatsächliche Leistung muss selbst reproduziert werden. Drittens beruhen die von der Quelle genannten Speicher- und Speicherplatzdaten (etwa 191 MB, etwa 567 MB, bis zu 6-fache Einsparung) auf einer bestimmten Quantisierungsmethode und dem Gerät Google Pixel 11 Pro und gelten möglicherweise nicht bei anderer Hardware oder Quantisierungskonfiguration. Viertens nennt die Quelle keinen tatsächlichen Zahlenwert für den angeblichen gemeinsamen Speichervorteil durch den geteilten Tokenizer und Audio-Encoder mit Gemma 4. Fünftens ist die Unterstützung im Gemini Enterprise Agent Platform Model Garden in der Quelle als „kurz bevorstehend“ gekennzeichnet, was eine planerische Aussage ist und nicht bedeutet, dass sie derzeit bereits verfügbar ist; diese Plattform bietet auch keinen API-Zugang zu diesem Modell. Preise und Verfügbarkeit ändern sich mit der Zeit; Leser sollten sich nach den aktuellen Preis- und Modellkarten der jeweiligen Herausgeber richten.
Abbildungen aus dem Originalbericht