GLM 5.3 auf Amazon Bedrock: 753B-MoE über verwaltete API, explizites Prompt-Caching und Cross-Region-Inferenz im Fokus
Laut einem offiziellen AWS-Blogbeitrag vom 5. Oktober 2026 ist Z.ais GLM 5.3 auf Amazon Bedrock für berechtigte Unternehmenskunden verfügbar, aufrufbar über OpenAI-kompatible Responses/Chat Completions sowie Bedrock Invoke/Converse, mit implizitem und explizitem Prompt-Caching, US- und Global-Cross-Region-Inferenzprofilen und einem Weg, es über den offenen Penetrationstest-Agenten Strix anzusteuern.
Was sich geändert hat
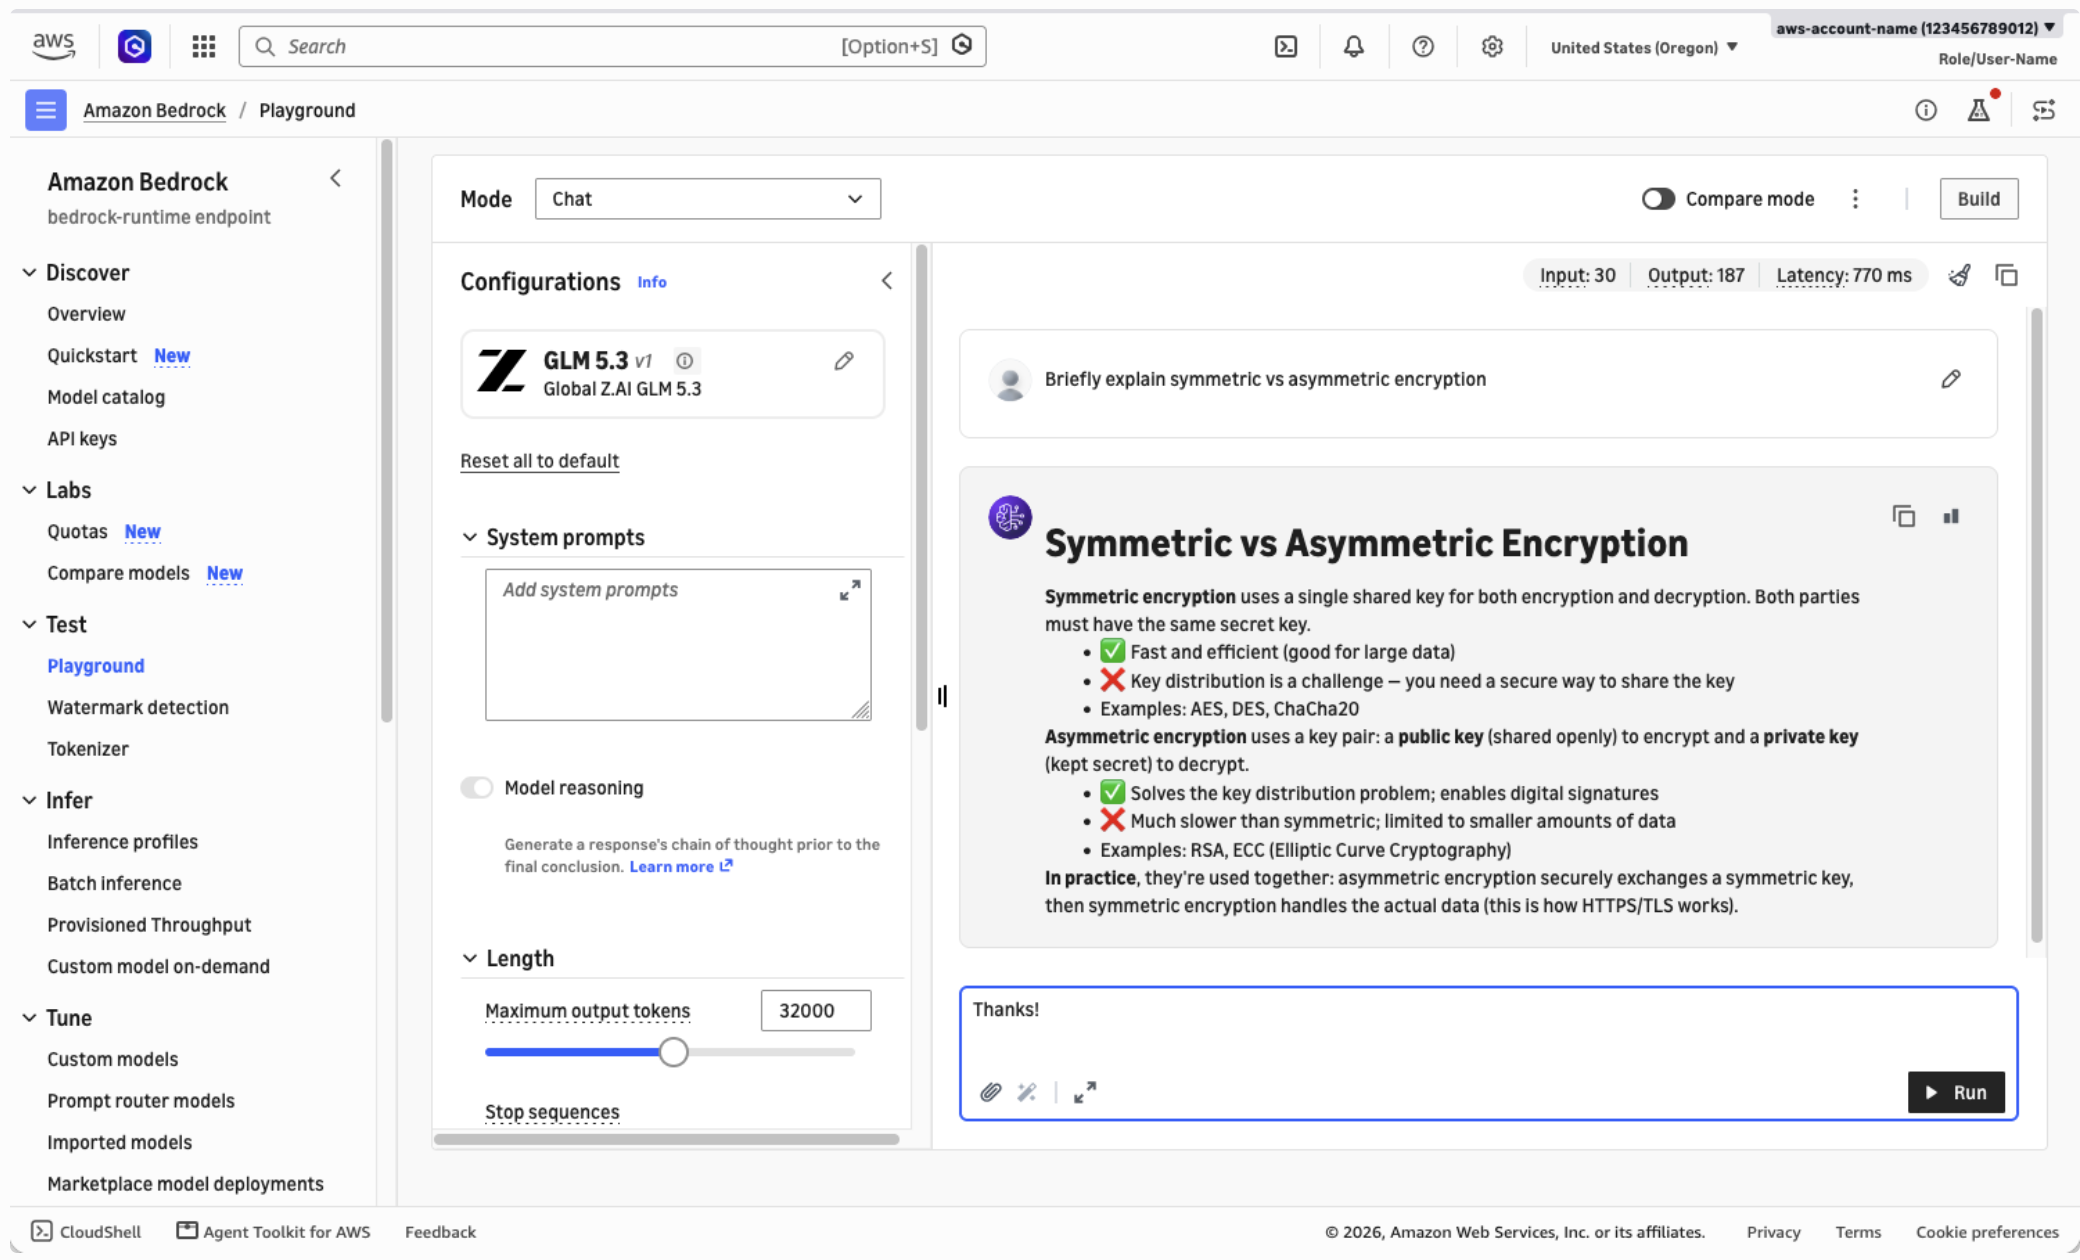
Laut einem offiziellen AWS-Blogbeitrag vom 5. Oktober 2026 ist Z.ai (Zhipu AI) GLM 5.3 auf Amazon Bedrock für berechtigte Unternehmenskunden verfügbar. Dem Beitrag zufolge ist GLM 5.3 den auf Hugging Face Hub veröffentlichten Informationen zufolge ein Mixture-of-Experts-Modell (MoE) mit 753B Parametern, optimiert für Coding- und langlaufende Agenten-Aufgaben; Z.ai berichtet von herausragender Leistung bei Sicherheitsaufgaben und einem Ergebnis von 84,5 Punkten im CyberGym-Benchmark zum Veröffentlichungszeitpunkt. Gegenüber GLM 5, das früher in diesem Jahr auf Bedrock erschien, nennt der Beitrag drei Änderungen: Z.ai zufolge ist das Modell wettbewerbsfähig in Coding-Benchmarks wie DeepSWE, Terminal Bench 3.0 und FrontierSWE und verbessert sich in einem internen Coding-Benchmark um 50 Prozent gegenüber GLM 5.2, ohne direkten Vergleich zu GLM 5, da die Benchmarks seit GLM 5.1 selbst aktualisiert wurden; die Sicherheitsfähigkeit wird als "emerging" beschrieben; die Bedrock-Integration ist vollständiger. Zur Anbindung: Das Modell ist über den bedrock-runtime-Endpunkt mit den OpenAI-kompatiblen Responses- und Chat-Completions-APIs aufrufbar und unterstützt zudem Bedrock Invoke und Converse; AWS empfiehlt für neue Anwendungen vorrangig die OpenAI-kompatiblen APIs und kurzfristige Credentials statt langlebiger API-Keys. Das Modell wird über zwei Cross-Region-Inferenzprofile bereitgestellt, us.zai.glm-5.3 und global.zai.glm-5.3, mit den drei Service-Tiers Flex, Priority und Standard.
Auswirkungen für Entwickler
Für Entwickler, die Hosting-Pfade für chinesische Modelle evaluieren, liegt die substanzielle Änderung nicht darin, dass "das Modell stärker ist", sondern in der Vervollständigung der Aufrufoberfläche und der Kostenkontrollmöglichkeiten. Erstens: Dass Bedrock sowohl OpenAI-kompatible Schnittstellen als auch natives Invoke/Converse bietet, bedeutet, dass Änderungen an bestehendem OpenAI-SDK-Code auf base_url, Authentifizierung (mit aws-bedrock-token-generator kurzfristige Tokens aus AWS-CLI-Credentials beziehen) und Modellkennung konzentriert sind, statt die Aufrufschicht neu zu schreiben; für Teams mit mehreren bestehenden OpenAI-kompatiblen Adaptern liegen die Migrationskosten damit vor allem bei Credentials und Routing, nicht in der Geschäftslogik. Zweitens: Explizites Prompt-Caching wird von AWS als "empfohlen" gekennzeichnet; bei Agenten-Lasten, die in jeder Runde System-Prompts, Tool-Definitionen oder Repository-Dateien erneut senden, wirkt sich das direkt auf Input-Token-Kosten und Time-to-First-Token aus, weshalb die Cache-Trefferrate zu einer beobachtbaren Engineering-Kennzahl wird. Drittens: Cross-Region-Inferenzprofile entkoppeln, "an welche Region die Anfrage geht" von "wo tatsächlich verarbeitet wird"; Unternehmenskunden müssen Datenresidenz und Compliance-Auslegung neu bewerten, statt anzunehmen, dass Anfragen lokal ausgeführt werden. Viertens: Die Strix-Dokumentation führt GLM 5.3 derzeit als Standardmodell und kann auf Bedrock verweisen, wodurch Inferenz für hochsensible Lasten wie Sicherheitstests in der Kontrolle des eigenen AWS-Kontos bleibt – eine sinnvolle Option für Sicherheitsteams, die aber Autorisierungsumfang und Compliance-Beurteilung berührt und nicht einfach "out of the box" gleichgesetzt werden darf. Zu beachten: Die genannten Fähigkeitsbeschreibungen stammen ausschließlich aus dem einseitigen AWS-Blog und von Z.ai selbst berichteten Benchmarks; unabhängige Reproduktionen liegen nicht vor.
Integration und Bewertung
Empfohlen wird eine Evaluierung nach folgenden konditionalen Regeln; diese sind Einschätzungen auf Basis der Quelle, keine bestätigten Schlussfolgerungen. Erstens, ob auf OpenAI-kompatible Schnittstellen umgestellt wird: Ist die bestehende Anwendung bereits auf dem OpenAI-SDK aufgebaut und wird der volle Funktionsumfang expliziten Cachings benötigt, sollte laut AWS vorrangig die OpenAI-kompatible Responses-API gewählt werden; ist der bestehende Code eng an Bedrock Converse gebunden oder soll die Aufrufschicht mit anderen Bedrock-Modellen geteilt werden, spart die Beibehaltung der nativen Schnittstelle Änderungen. Voraussetzung ist, dass das Konto über die Berechtigungen bedrock:InvokeModel, bedrock:InvokeModelWithResponseStream und bedrock:CallWithBearerToken verfügt. Messbares Kriterium: mit demselben langen System-Prompt zwei Gesprächsrunden fahren, prüfen, ob input_tokens_details.cached_tokens in der Antwort ungleich null ist, und Input-Token-Abrechnung sowie Time-to-First-Token zwischen beiden Durchläufen vergleichen. Zweitens, ob explizites Caching aktiviert wird: Sendet die Last in jeder Runde große statische Kontexte (System-Prompts, Tool-Definitionen, Repository-Ausschnitte) erneut, wird laut Quelle der Wechsel in den explicit-Modus von prompt_cache_options mit gesetztem prompt_cache_breakpoint empfohlen; ist der Kontext kurz oder ändert sich häufig, genügt implizites Caching, und der Wartungsaufwand für Marker lohnt nicht. Voraussetzung ist, dass jeder Breakpoint mindestens 1.024 Token umfasst, um cachefähig zu sein; Markierungen in kurzen Prompts sind wirkungslos. Messbares Kriterium: Anteil der Cache-Treffer-Token und Rückgang der Ende-zu-Ende-Latenz unter derselben Last sowie die Bestätigung, dass die Breakpoint-Aufteilung semantische Grenzen nicht verletzt. Drittens, welches Cross-Region-Profil gewählt wird: Teams mit US-Nutzern oder bestehenden Compliance-Anforderungen an die us-Region sollten us.zai.glm-5.3 evaluieren, bei Bedarf an breiterer Abdeckung global.zai.glm-5.3; Grundlage sind Datenresidenzanforderungen und gemessene Latenz, nicht die Standardwahl "global". Messbares Kriterium: P50/P95-Latenz bei Anfragen aus der Ziel-Quellregion sowie ein schriftliches Compliance-Ergebnis zur Verarbeitungsregion. Viertens, Service-Tiers: Für unkritische Aufgaben wie Batchverarbeitung und Offline-Analysen Flex zur Kostenoptimierung evaluieren, für latenzempfindliche Anfragen wie interaktive Coding-Assistenten Priority, Standard als Standardbasislinie. Voraussetzung ist, dass die Tier-Wahl den Stückpreis ändert; die aktuelle Abrechnung unbedingt in der Konsole prüfen. In jedem Fall zunächst einen kleinen Vergleich mit eigener Codebasis und echten Agenten-Trajektorien fahren, statt das Produktions-Standardmodell direkt zu ersetzen.
Grenzen und offene Fragen
Die Version GLM 5.3 erscheint derzeit nicht im Live-Katalog von KimiSeek; die genannte Bedrock-Verfügbarkeit, Modellkennungen und Abrechnungsmodalitäten beziehen sich auf die Seite von AWS und Z.ai und sagen nichts über die Verfügbarkeit auf KimiSeek aus. Der KimiSeek-Katalog enthält andere Einträge wie GLM-5.3, GLM-5.3 Flash und GLM-5.2; diese sind andere Versionen oder Vertriebskanäle, woraus nicht geschlossen werden kann, dass die hier beschriebene Bedrock-Version auf KimiSeek verfügbar ist. Die Leistungsangaben in der Quelle, einschließlich CyberGym 84,5, 50 Prozent Verbesserung im internen Coding-Benchmark gegenüber GLM 5.2 sowie der "Wettbewerbsfähigkeits"-Aussagen zu DeepSWE, Terminal Bench 3.0 und FrontierSWE, sind Selbstauskünfte von Z.ai oder AWS-Wiedergaben; unabhängige Reproduktionen fehlen, und die Benchmark-Versionen wurden seit GLM 5.1 aktualisiert, weshalb Quervergleiche vorsichtig zu behandeln sind. AWS gibt ausdrücklich an, GLM 5.3 richte sich an "berechtigte Unternehmenskunden"; ob normale Konten direkt freischalten können und ob alle Regionen verfügbar sind, sagt die Quelle nicht. Der Originaltext erwähnt zudem, dass LiteLLM damals bedrock/global.zai.glm-5.3 noch nicht auflösen konnte und Converse-Route sowie Inferenzprofil-ARN explizit angegeben werden mussten – eine damals bekannte Einschränkung, deren Behebung ungewiss ist. Die Angabe, Strix nutze GLM 5.3 als Standardmodell, stammt aus einer Dokumentationsbeschreibung "zum Redaktionszeitpunkt" und kann sich geändert haben. Preise und Tier-Stückpreise werden mit der Zeit angepasst; maßgeblich sind die aktuellen Preisseiten von AWS und KimiSeek. Die Sicherheitstest-Beispiele gelten nur für eigene oder schriftlich autorisierte Anwendungen; der Quelltext bricht im Abschnitt zu AWS Continuum ab.
Abbildungen aus dem Originalbericht