JD Logistics „Super Brain“ 3.0: Sekunden für die Routenplanung, fünf Industriemodelle, keine Angaben zu offenen Gewichten oder API
Laut einem Artikel von InfoQ China vom 6. November 2026 hat JD Logistics sein Large Model „Super Brain“ auf Version 3.0 weiterentwickelt und gibt an, die optimale Routenplanung für Hunderte Millionen Pakete von Minuten- auf Sekundenebene verkürzt zu haben. Das System bestehe aus fünf supply-chain-nativen Modellen – PreX, OptiX, OmniX, GeoX und EmbodiedX – und decke über 3600 Lager sowie mehr als 600.000 Mitarbeiter ab; die automatisierte Fahrzeugdisposition liege bei 86 Prozent. Der Artikel nennt weder offene Gewichte noch eine Open-Source-Lizenz oder eine Schnittstelle, die Dritte direkt nutzen könnten.
Was sich geändert hat
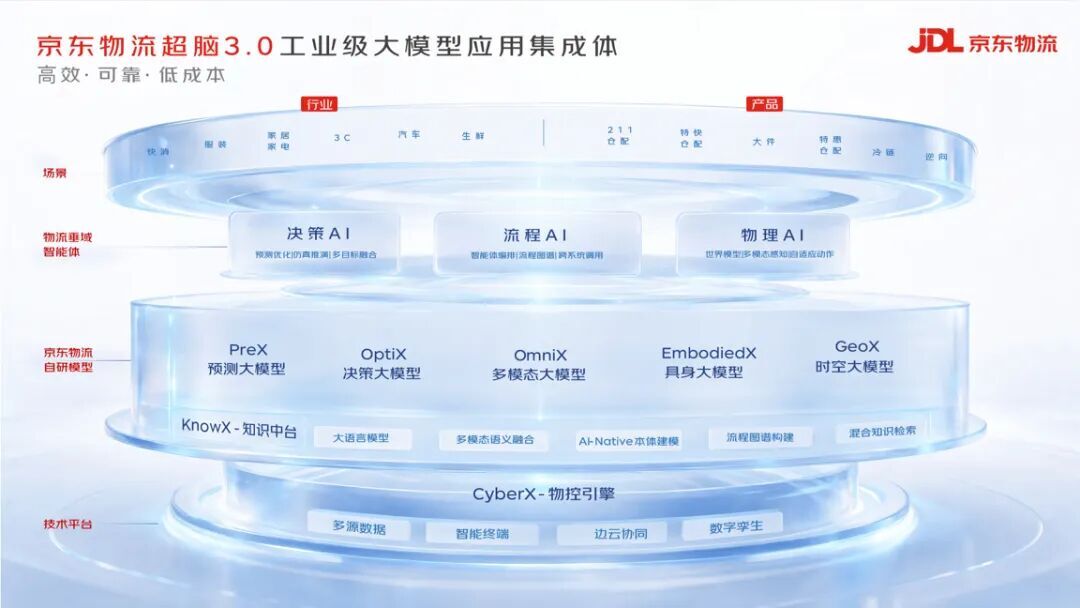
Laut einem am 6. November 2026 veröffentlichten Artikel von InfoQ China hat JD Logistics sein Large Model „Super Brain“ auf Version 3.0 weiterentwickelt. Der Artikel beschreibt es als industrielle Anwendungsintegration, in der die gesamte Kette vom Lager bis zur Zustellung von KI gesteuert werde. Im Vergleich zu 2.0 sei 3.0 effizienter, widerstandsfähiger und kostengünstiger im Betrieb und verkürze die Lösungszeit für die end-to-end optimale Routenplanung von Hunderten Millionen Paketen von Minuten- auf Sekundenebene. Das System besteht dem Artikel zufolge aus fünf supply-chain-nativen Modellen: PreX prognostiziert Veränderungen von Angebot und Nachfrage aus mehrdimensionalen dynamischen Daten; OptiX kombiniert Optimierung, Reinforcement Learning und generative Modellfähigkeiten, um unter Nebenbedingungen wie Lagernetz, Bestand, Transport, Personal und Geräten globale Lösungen zu finden; OmniX versteht Bilder, Videos, Raum und Objekte einheitlich; GeoX ordnet Adressen, Positionen, Routen und Zeit in ein einheitliches raum-zeitliches Koordinatensystem ein; EmbodiedX wandelt Wahrnehmung und Entscheidung in für Roboter ausführbare Aktionen um. Der Artikel beschreibt das System als Einheit aus Entscheidungs-KI, Prozess-KI und physischer KI: Die Entscheidungsebene modelliert Aufträge, Bestand, Lagernetz, Fahrzeuge, Verkehrslage, Wetter sowie Bild-, Video- und Positionsdaten einheitlich. Die Prozessebene verbindet die Daten von Lager, Transport, Sortierung und Zustellung, vereinheitlicht die Definitionen von Mensch, Ware, Fahrzeug, Lager, Auftrag und Gerät und zerlegt Entscheidungen in ausführbare Aufgaben, die sie vergibt, verfolgt und bei Ausnahmen bearbeitet. Die physische Ebene wird von der CyberX-Materialsteuerungsengine angetrieben, die Roboter „Zhi Lang“, den Sortierroboterarm „Yi Lang“ und das autonome Lieferfahrzeug „Du Lang“ steuert und Ergebnisse zurückspeist – ein geschlossener Kreis aus Wahrnehmung, Prognose, Entscheidung, Ausführung und Rückmeldung. Weitere im Artikel genannte Zahlen: über 3600 Lager und mehr als 600.000 Mitarbeiter; 86 Prozent automatisierte Fahrzeugdisposition; 13,8 Prozent Effizienzsteigerung bei Lagerarbeitern; der End-to-End-Supply-Chain-Service „Jinghui“ für Händler erreiche nach eigenen Angaben im Durchschnitt über 80 Prozent Next-Day-Erfüllung und könne automatisch Nachbestellvorschläge machen und Umschichtungen ausführen; „Yi Lang“ laufe in mehreren Logistikparks rund um die Uhr und habe kumuliert den Griff und das Stapeln von über zehn Millionen echten Paketen validiert; „Du Lang“ werde an mehreren Standorten in China sowie in Saudi-Arabien erprobt. Der Artikel nennt zudem, dass diese Fähigkeiten derzeit für Branchen wie Fertigung und Einzelhandel geöffnet würden.
Auswirkungen für Entwickler
Zunächst ist zwischen prüfbaren und nicht prüfbaren Angaben zu trennen. Alle genannten Zahlen stammen aus der Darstellung von JD Logistics. Der Artikel nennt weder Modellparameter, Trainingsdatenumfang, Benchmark-Methodik, Inferenzhardware noch den statistischen Zeitraum; auch offene Gewichte, eine Open-Source-Lizenz, ein Model Card oder eine öffentliche API für Dritte werden nicht erwähnt. Für Entwickler liest sich das eher wie ein Betriebsbericht über ein internes System als wie ein Modell, das sich herunterladen, hosten oder pro Token aufrufen ließe. Auch die Messgrößen bleiben offen. „Sekundenebene“ lässt nicht erkennen, ob es sich um einen Mittelwert oder eine Tail-Latenz handelt, und ebenso wenig, bei welcher Auftragsgröße, welchem Lösungszeitlimit und welcher Hardware gemessen wurde. Bei der automatisierten Fahrzeugdisposition von 86 Prozent ist nicht klar, ob sich der Nenner auf alle Fahrzeuge oder nur auf solche unter bestimmten Bedingungen bezieht. Für die 13,8 Prozent Effizienzsteigerung bei Lagerarbeitern fehlen Kontrollgruppe und Messzeitraum. Solche operativen Kennzahlen sollte man als noch zu prüfende Herstellerangaben behandeln und nicht als direkt auf das eigene Geschäft übertragbare Leistungserwartung. Übertragbar ist weniger die konkrete Zahl als die Aufgabenteilung der Architektur: Prognose, Lösung unter Nebenbedingungen, multimodale Wahrnehmung, raum-zeitliches Verständnis und physische Steuerung werden in getrennte Module zerlegt, und vor der Orchestrierung gleicht eine Prozessebene die Entity-Definitionen über Systeme hinweg ab. Diese Reihenfolge adressiert das Problem, dass eine Entscheidung berechenbar ist, aber nicht umgesetzt werden kann. Der Preis ist ebenso klar: Jede zusätzliche semantische Vereinheitlichungsschicht bedeutet zusätzliche Mapping-Objekte und Fehlerquellen, die dauerhaft gepflegt werden müssen – lohnend ist sie nur, wenn die Daten tatsächlich über heterogene Systeme verteilt sind. Unklar bleibt auch die „Öffnung für Branchen“: Der Artikel sagt nicht, ob sie als Produkt, SDK, API oder Projektgeschäft erfolgt, und nennt weder Zugangsbedingungen noch Abrechnungsmodalitäten. Am klarsten beschrieben ist noch „Jinghui“ für Händler – doch das ist ein Supply-Chain-Service, keine Modellschnittstelle. Eine Anbindung bedeutet, Auftrags-, Bestands-, Lagernetz- und Erfüllungsdaten an den Anbieter zu geben und die Leistung für das jeweilige Händlerszenario Punkt für Punkt abzunehmen.
Integration und Bewertung
Die folgenden Hinweise sind bedingte Analysen und Empfehlungen, keine im Artikel gemachten Aussagen. Teams, die ein Large Model in Disposition oder Orchestrierung einbinden wollen, können zunächst mit zwei Punkten aus dem Artikel kleine kontrollierte Versuche durchführen. Erstens: Dass Prozess-KI zuerst die Definitionen von Mensch, Ware, Fahrzeug, Lager, Auftrag und Gerät vereinheitlicht und erst dann Aufgaben orchestriert, lohnt eine eigene Prüfung. Zu entscheiden ist, ob Sie Ihrer Agenten-Orchestrierung eine einheitliche semantische Schicht für Entities und Regeln voranstellen. Voraussetzung ist, dass die Daten tatsächlich über mehrere Systeme verteilt sind und dasselbe Geschäftsobjekt in verschiedenen Schritten unterschiedlich definiert wird; gibt es ohnehin nur eine Datenquelle, erhöht diese Schicht nur Latenz und Wartungsaufwand. Messbar wäre: dieselbe Charge historischer Tickets einmal über den Pfad „zuerst Vereinheitlichung“ und einmal über „direkte end-to-end-Zerlegung durch das Modell“ laufen lassen und dabei Feldzuordnungsfehler, Retry-Rate, manuelle Übernahmen und End-to-End-Latenz vergleichen; die ersten beiden Werte sollten sinken, die Latenz nicht deutlich steigen. Zweitens: Entscheidungs-KI führt Prognose und Lösung unter Nebenbedingungen in einem rollierenden Regelkreis zusammen und behauptet, Entscheidungen bei Änderungen von Aufträgen, Straßen und Kapazitäten sekundengenau zu aktualisieren. Zu entscheiden ist, ob ein generatives Modell bei Dispositionsaufgaben direkt den fertigen Plan liefern soll oder ob Prognose, Lösung und Ausführungsrückmeldung in drei getrennten Stufen bewertet werden. Voraussetzung sind harte Nebenbedingungen (Fristen, Kosten, Kapazität) und hohe Fehlerkosten; bei reinen Ranking- oder Empfehlungsaufgaben kann ein Ein-Modell-Ansatz bleiben. Messbar wäre per Replay historischer Aufträge ein Vergleich von Verletzungsrate der Nebenbedingungen, Kostendifferenz zur bestehenden Regelbasis und Erholungszeit nach eingebrachten Störungen. Drittens: Der Teil zur physischen KI lässt sich lokal nicht nachbilden und nur über Pilot- oder Beschaffungsprozesse prüfen. Wer Roboterarme oder autonome Fahrzeuge bewerten will, sollte zuerst die Bandbreite der Paketformen am Einsatzort eingrenzen und dann beobachtbare Kennzahlen verlangen – Betriebsstunden in Folge, Greiferfolgsquote, Schadensquote und Häufigkeit manueller Eingriffe – statt Formulierungen wie „regelmäßiger Betrieb“ zu akzeptieren. Ein weiterer sehr kostengünstiger Schritt gilt für jede ähnliche Darstellung: Schreiben Sie in die Bewertungsmatrix direkt, welche Angaben der Anbieter liefern muss – Latenzperzentile, Problemgröße, Hardwareausstattung, Messfenster und Kontrollgruppen-Design. Ohne diese Angaben lassen sich die Zahlen des Anbieters nicht in Ihre eigene Kapazitätsplanung übersetzen.
Grenzen und offene Fragen
Alle Leistungs- und Effizienzzahlen im Artikel stammen von JD Logistics, sind nicht von Dritter Seite reproduziert und sollten nicht als übertragbare Fähigkeitsbasis gelten. Der Artikel beschreibt nur die Aufgabenteilung der fünf Modelle; Angaben zu Parameterumfang, Lizenzbedingungen, Veröffentlichung von Gewichten und Inferenzkosten, die für eine Auswahl nötig wären, fehlen. Die konkrete Form der „Öffnung für Branchen wie Fertigung und Einzelhandel“, die Zugangshürden und die Abrechnung werden nicht erläutert; auch der tatsächlich nutzbare Umfang von „Jinghui“ muss bei JD Logistics erfragt werden. Ausdrücklich gilt: Das Large Model „Super Brain“ 3.0 von JD Logistics ist derzeit nicht im Modellkatalog von KimiSeek enthalten, es gibt dort keinen entsprechenden Eintrag, und dieser Artikel behandelt es nicht als über diese Seite aufrufbares Modell. Für die genannten externen Dienste sowie ihre Verfügbarkeit, Spezifikationen und Abrechnung gelten ausschließlich die Angaben von JD Logistics. Sollte das System künftig eine API oder Gewichte veröffentlichen, ist eine Anbindung weiterhin anhand der oben genannten messbaren Kriterien gesondert zu prüfen.
Abbildungen aus dem Originalbericht