JetBrains veröffentlicht Mellum2.1 als Open Weights unter Apache 2.0: 12B-MoE-Coding-Agent mit quantisierten Varianten
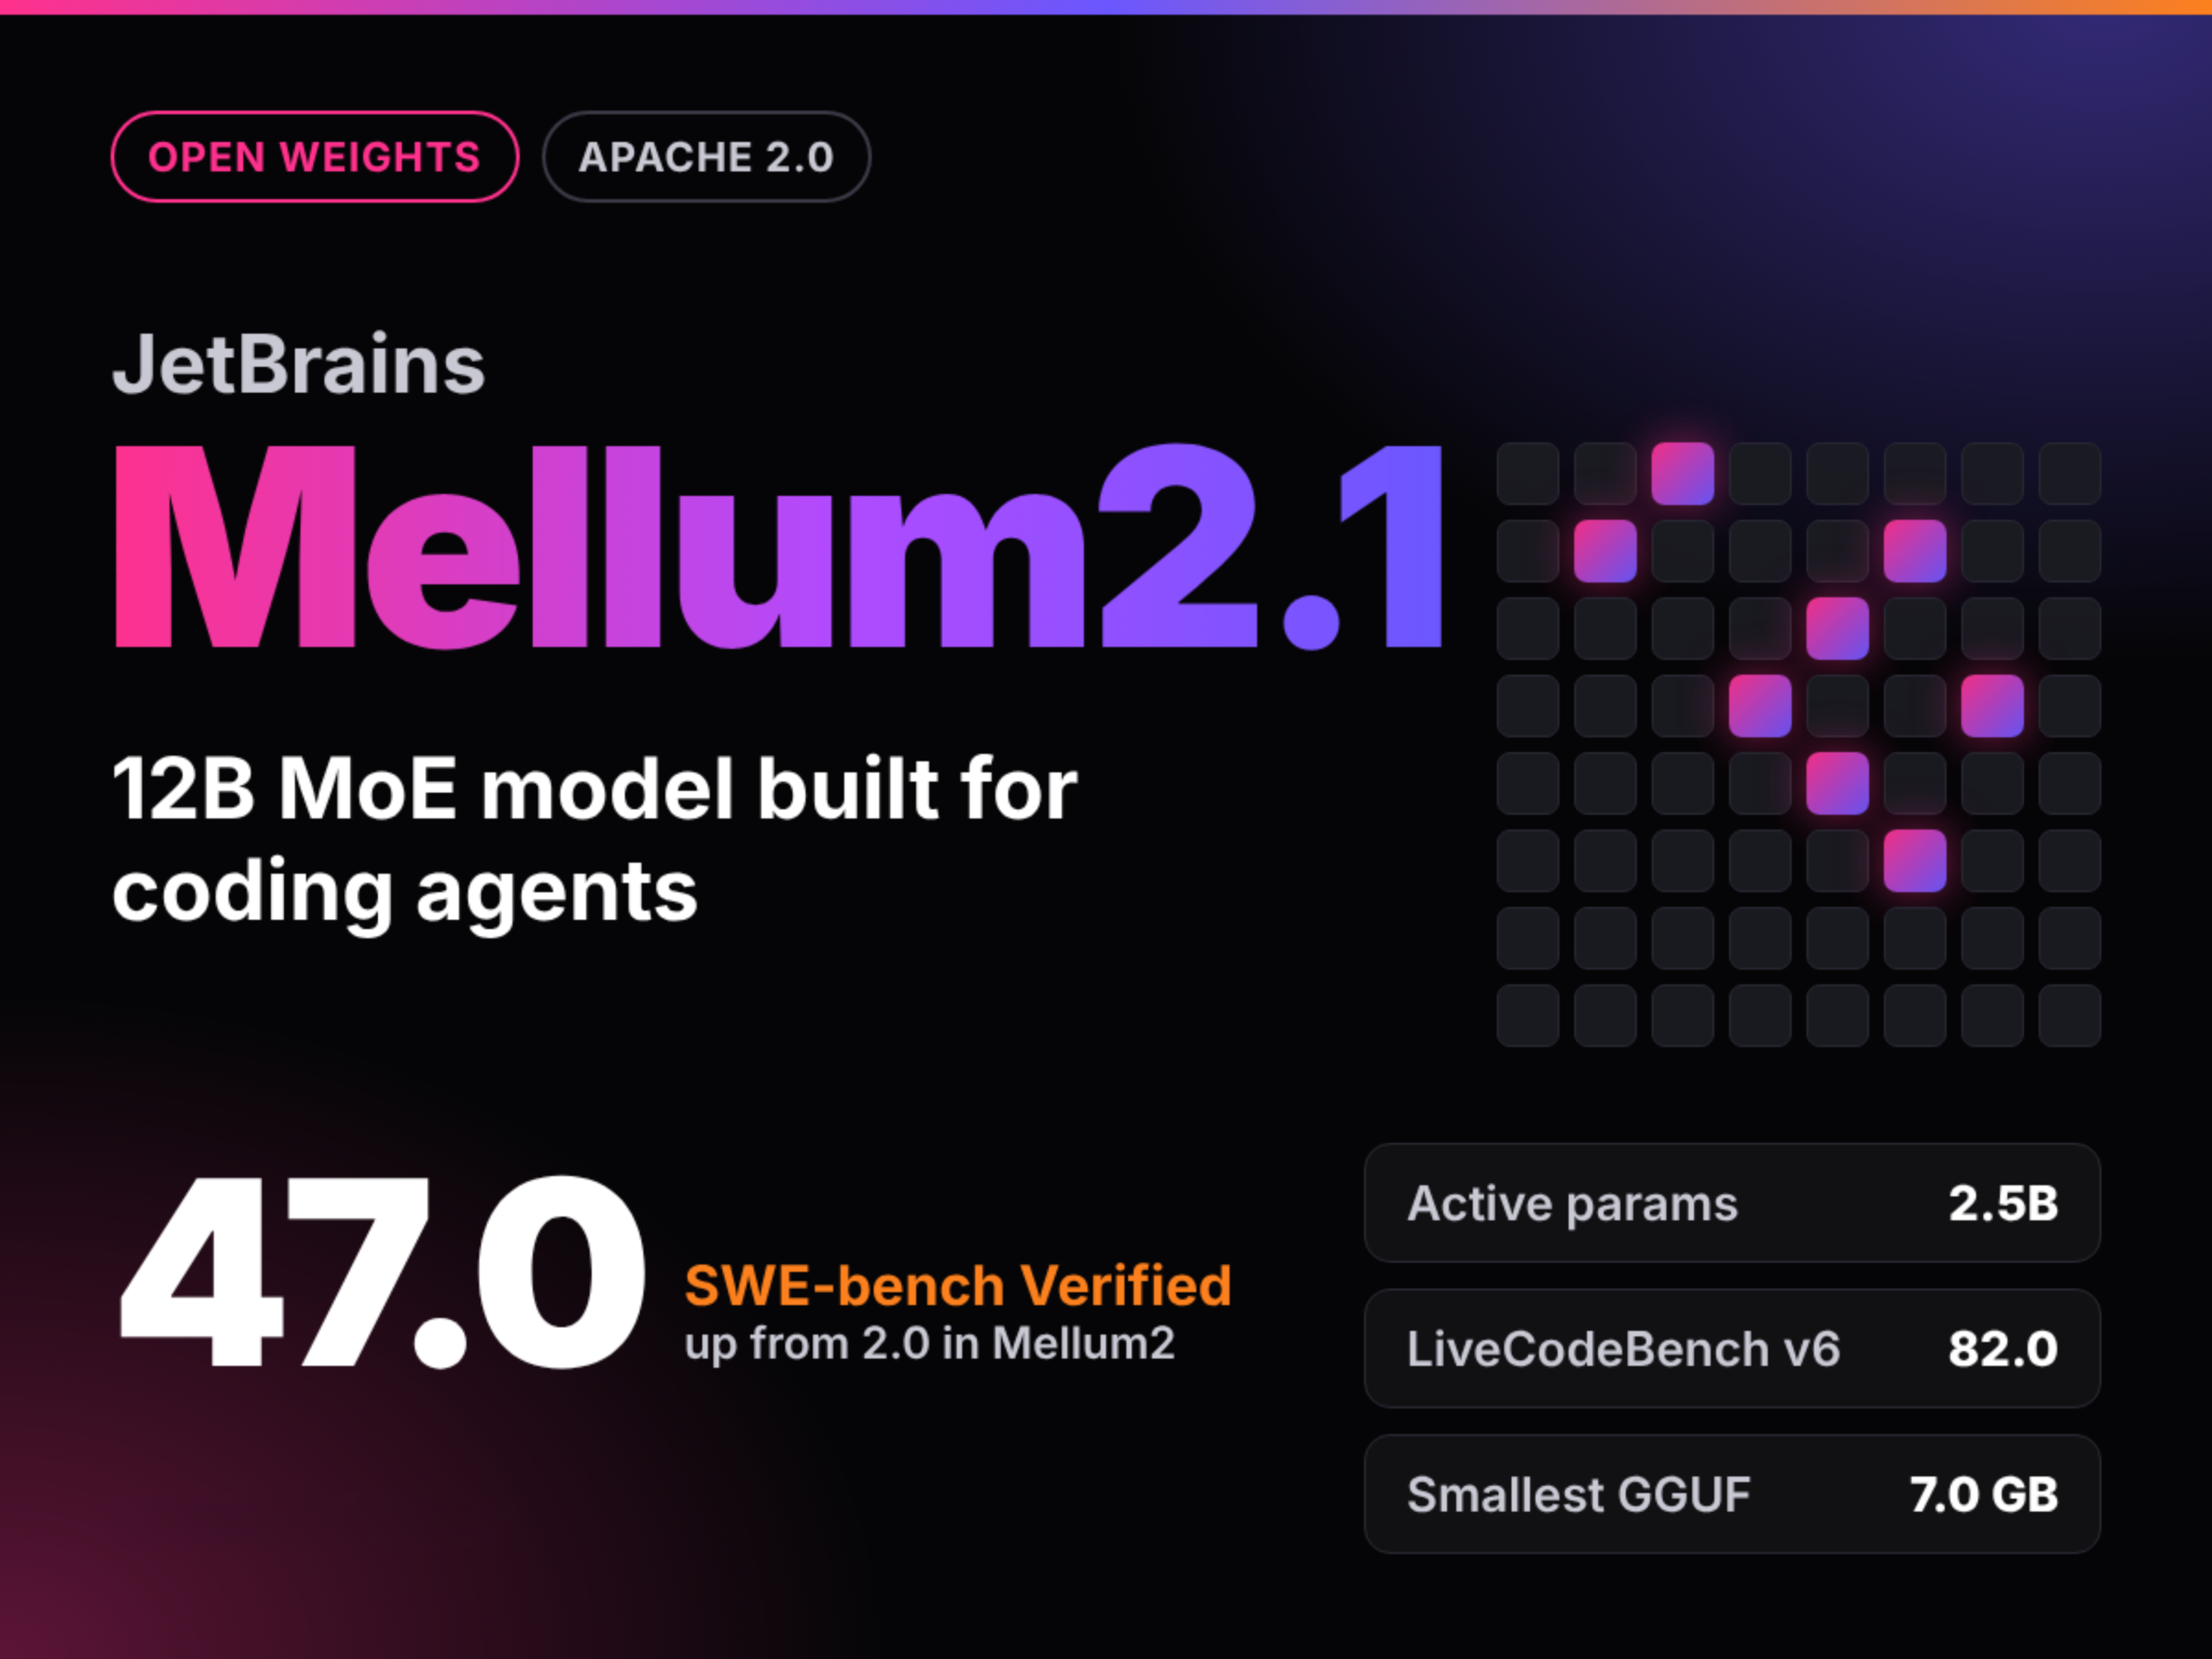
MarkTechPost berichtete am 8. Oktober 2026, dass JetBrains Mellum2.1 unter der Apache-2.0-Lizenz veröffentlicht hat, und zwar Mellum2.1-12B-A2.5B-Thinking: ein MoE-Thinking-Modell mit 12B Gesamtparametern und 2,5B pro Token aktivierten Parametern. Die Architektur sei gegenüber der Vorgängergeneration unverändert; die Verbesserungen stammten überwiegend aus Reinforcement Learning in echten Code-Repositories, wobei SWE-bench Verified laut Bericht von 2,0 auf 47,0 stieg.
Was sich geändert hat
MarkTechPost berichtete am 8. Oktober 2026, dass JetBrains Mellum2.1 veröffentlicht hat, wobei der Checkpoint-Name Mellum2.1-12B-A2.5B-Thinking lautet und die Gewichte unter der Apache-2.0-Lizenz auf Hugging Face bereitgestellt werden. Es handelt sich um ein Mixture-of-Experts-Reasoning-Modell mit 12B Gesamtparametern und 2,5B pro Token aktivierten Parametern, 28 Schichten, 64 Experten, 8 pro Token aktiviert, mit GQA (32 Query-Heads, 4 KV-Heads), wobei 3 von 4 Schichten ein gleitendes Fenster von 1024 Token nutzen, Kontext 131072 Token, Vokabular 98304, Gewichte in bfloat16. Der Bericht gibt an, die Architektur sei gegenüber dem im Juni 2026 als Open Source veröffentlichten Mellum2 Thinking unverändert, und die Verbesserungen stammten fast vollständig aus dem Post-Training: RL sei zum Hauptbestandteil des Trainings geworden, ergänzt um Mathematik-, Wettbewerbsprogrammier-, Wissenschafts-, Tool-Calling- und Software-Engineering-Aufgaben, trainiert in echten Code-Repositories mit Shell- und Dateibearbeitungswerkzeugen, wobei bestandene Tests belohnt wurden. Laut Bericht stieg unter JetBrains' eigener Evaluierung SWE-bench Verified von 2,0 auf 47,0, SWE-bench Pro von 0,0 auf 28,0, Terminal-Bench 2.1 von 0,6 auf 17,4, LiveCodeBench v6 erreichte 82,0, BFCL v4 62,3, HarmBench sank von 21,5 auf 8,5; Qwen3.5-9B liege bei SWE-bench Verified (50,0), SWE-bench Pro (38,0), GPQA Diamond (77,8) und AIME 25/26 (86,7) weiterhin vorn.
Auswirkungen für Entwickler
Die Bedeutung dieser Veröffentlichung für selbst gehostete Coding-Agenten konzentriert sich auf drei Punkte, die alle auf der Darstellung des Berichts und nicht auf unabhängiger Reproduktion beruhen. Erstens werden die Gewichte unter der Apache-2.0-Lizenz veröffentlicht, was eine Open-Weights-Veröffentlichung mit klarer Lizenzierung darstellt und nicht bloß herunterladbare Gewichte; allerdings sind alle im Bericht genannten Benchmark-Werte von JetBrains selbst gemeldet, und die offizielle Qwen-Modellkarte weicht bei LiveCodeBench v6 und GPQA Diamond für dasselbe Modell deutlich von JetBrains' Evaluierungsverfahren ab, was zeigt, dass die Werte empfindlich auf das Evaluierungsframework reagieren und nicht direkt als herstellerübergreifend vergleichbare Schlussfolgerungen dienen können. Zweitens machen 2,5B aktivierte Parameter zusammen mit 131072 Token Kontext und GGUF-Quantisierung lokale Sub-Agenten in Consumer- oder Single-GPU-Umgebungen machbar: Der Bericht listet Versionen mit BF16 24,3 GB, Q8_0 12,9 GB, Q4_K_M 8,1 GB (First-Token-Übereinstimmungsrate 88,0 %) und MXFP4_MOE 7,0 GB (85,6 %). Entwickler sollten darauf achten, ob der Fähigkeitsverlust nach der Quantisierung innerhalb der Toleranz ihrer eigenen Aufgaben liegt, statt nur auf die Dateigröße. Drittens gibt der Bericht an, dass der Durchsatz unter hoher Last auf einer einzelnen H200 nahezu doppelt so hoch wie bei Qwen3.5-9B sei und MTP im Einzelanfrage-Szenario etwa 1,6-fache Beschleunigung bringe, doch der für vLLM-Spekulativdekodierung vorgesehene MTP-Head sei als „demnächst verfügbar“ gekennzeichnet, was bedeutet, dass aktuelle Deployments diese Beschleunigung nicht direkt nutzen können. Für Teams, die Coding-Agenten einsetzen, ist dies eher ein Kandidat für eine kostengünstige Ausführungseinheit als ein Ersatz für ein universelles Reasoning-Arbeitspferd: Der Bericht zeigt Rückstände bei Terminal-Bench 2.1 und wissensbezogenen Benchmarks.
Integration und Bewertung
Es empfiehlt sich eine aufgabenbezogen geschichtete Validierung statt eines Austauschs des gesamten Stacks. Entscheidung eins: Wenn die Workload aus hochparalleler Code-Vervollständigung mit kurzen Schritten oder Sub-Agent-Ausführungseinheiten besteht, kann ein 12B/2,5B-aktiviertes MoE-Deployment vorrangig geprüft werden, sofern mehr als eine GPU mit ausreichendem Speicher sowie eine vLLM- oder SGLang-Umgebung vorhanden sind. Der Bericht nennt als Startkonfiguration vLLM mit --reasoning-parser qwen3; für Tool-Calling müssen --enable-auto-tool-choice --tool-call-parser hermes ergänzt werden, und als Sampling-Parameter werden temperature 0,6, top_p 0,95 und top_k 20 empfohlen; gemessen werden sollte der Durchsatz pro Token und die Kosten pro Aufgabe auf gleicher Hardware, nicht nur der Benchmark-Wert. Entscheidung zwei: Wenn die Workload aus langkettigen Repository-weiten Fehlerbehebungen besteht, sollte zunächst ein kleiner Vergleich mit eigenen Repositories durchgeführt werden, der Aufgaben-Erfolgsrate und Fehlermuster mit Modellen wie Qwen3.5-9B vergleicht, da die im Bericht selbst gemeldeten 47,0 bei SWE-bench Verified unter den 50,0 von Qwen3.5-9B liegen und der Abstand bei Terminal-Bench 2.1 deutlicher ist; Voraussetzung hierfür ist, dass das Unternehmen bereits über automatisch auswertbare Testsätze verfügt, und gemessen werden sollten die End-to-End-Aufgaben-Erfolgsrate sowie die durchschnittliche Schrittzahl. Entscheidung drei: Für lokale oder Offline-Szenarien können zunächst die quantisierten Versionen Q4_K_M und MXFP4_MOE getestet werden, sofern die Aufgaben unempfindlich gegenüber Abweichungen im First-Token-Verhalten sind; gemessen werden sollte die Differenz zwischen quantisierter Version und BF16-Referenz bei First-Token-Übereinstimmungsrate und tatsächlicher Genauigkeit auf einem eigenen Prompt-Set. Zudem ist zu beachten, dass die im Bericht beschriebene Verfügbarkeit die vom Anbieter veröffentlichten Gewichte und die Unterstützung durch Inferenz-Frameworks meint und die Anbindung den jeweiligen Framework-Dokumentationen zu entnehmen ist.
Grenzen und offene Fragen
Wesentliche Einschränkungen sind klarzustellen: Mellum2.1 erscheint nicht im Echtzeit-Modellkatalog von KimiSeek; diese Version ist derzeit nicht auf KimiSeek gelistet, und die im Bericht genannten Gewichte, GGUF- und vLLM/SGLang-Deployment-Wege beziehen sich auf die Veröffentlichung von JetBrains und bedeuten nicht, dass sie hier verfügbar sind. Alle Leistungszahlen stammen aus JetBrains' eigener Meldung bzw. dessen einheitlichem Evaluierungsverfahren, einschließlich SWE-bench, Terminal-Bench, LiveCodeBench und BFCL, und wurden nicht unabhängig reproduziert; der Bericht selbst weist darauf hin, dass die offizielle Qwen-Modellkarte und JetBrains' Evaluierung für dasselbe Modell unterschiedliche Werte ergeben, weshalb Quervergleichs-Schlussfolgerungen mit Vorsicht zu behandeln sind. Die First-Token-Übereinstimmungsrate quantisierter Versionen ist nicht gleichbedeutend mit der Aufgaben-Genauigkeit; die GGUF-Liste im Bericht und die Angabe, dass GGUF noch in Arbeit sei, weichen voneinander ab, sodass tatsächlich verfügbare Dateien und Qualität selbst geprüft werden müssen. Der MTP-Head ist als demnächst verfügbar gekennzeichnet, die vLLM-Spekulativdekodierungs-Beschleunigung ist derzeit noch nicht nutzbar. Darüber hinaus sind konkrete Aufrufpreise und Abrechnungsmodalitäten den Preisseiten des Anbieters zu entnehmen; dieses Artikel nennt keine konkreten Zahlen.