Alaya-DFlash2: Jiuzhang Yunji veröffentlicht spekulative Dekodierlösung für GLM-5.3, laut Hersteller 3,41-fache Dekodierbeschleunigung bei 32k-Kontext
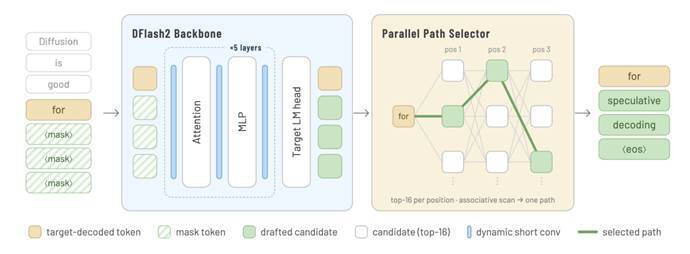
Laut einem InfoQ-Bericht vom 20. Oktober 2026 hat Jiuzhang Yunji die spekulative Dekodierbeschleunigung Alaya-DFlash2 für GLM-5.3 veröffentlicht, bestehend aus einem parallel entwerfenden Draft-Modell und einem Pfadauswahlmechanismus, samt offengelegten Gewichten. In der Herstellerbewertung erreicht die Dekodiergeschwindigkeit bei Einzel-Concurrency auf 8×H200 mit TP=8 das 3,41-Fache der nativen Autoregression, und die Akzeptanzlängen bei niedrig-entropischem Kontext von 1k bis 32k liegen über denen der beiden Vergleichslösungen. Diese Zahlen und Vergleiche stammen aus Herstellerselbsttests und warten auf unabhängige Reproduktion.
Was sich geändert hat
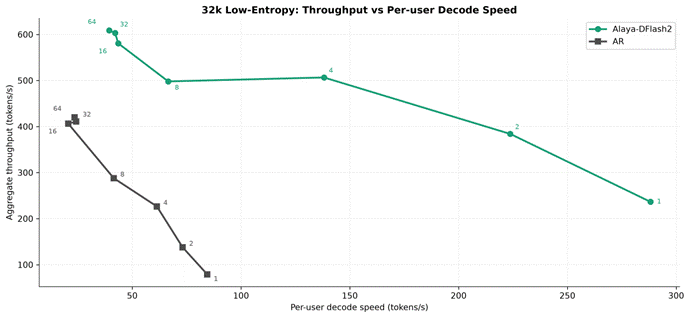
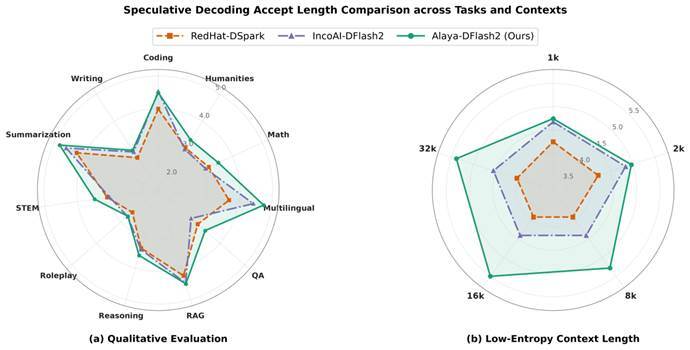
Laut einem InfoQ-Bericht vom 20. Oktober 2026 hat Jiuzhang Yunji die spekulative Dekodierbeschleunigung Alaya-DFlash2 für GLM-5.3 vorgestellt. Sie besteht aus einem parallel entwerfenden Draft-Modell und einem Pfadauswahlmechanismus; die Gewichte wurden unter dem Namen AlayaNeW/GLM-5.3-DFlash2 veröffentlicht, wobei der Bericht keine konkreten Lizenzbedingungen für Open Source nennt. Dem Bericht zufolge wurde das Draft-Modell auf Basis der AlayaNeW-Rechen-Engine von Jiuzhang Yunji rund um GLM-5.3 trainiert. Zur Bewertung nennt der Bericht Daten für die Umgebung 8×H200 mit TP=8: Die Dekodiergeschwindigkeit bei Einzel-Concurrency beträgt etwa 288,2 tokens/s gegenüber etwa 84,5 tokens/s bei nativer Autoregression, also das 3,41-Fache; der entsprechende Gesamtdurchsatz der Ausgabe steigt von 78,95 auf 236,47 tokens/s. Mit steigender Concurrency verringert sich der Vorteil: Bei 4-facher Concurrency beträgt der Durchsatz das 2,24-Fache der nativen Autoregression, bei 64-facher Concurrency 608,71 tokens/s, eine Steigerung um 44,9 % gegenüber 420,13 tokens/s bei nativer Autoregression. Der Bericht listet zudem Akzeptanzlängen bei niedrig-entropischem Kontext auf: für 1k, 2k, 8k, 16k und 32k jeweils 4,74, 4,97, 5,28, 5,50 und 5,39, alle über den ebenfalls bewerteten IncoAI-DFlash2 und RedHat-DSpark; zudem heißt es, in 9 von 11 Aufgabentypen führe die Akzeptanzlänge, während die Typen Code und Rollenspiel nahe an IncoAI-DFlash2 lägen.
Auswirkungen für Entwickler
Für Entwickler ist spekulatives Dekodieren vor allem deshalb relevant, weil es die Kostenstruktur der Generierung auf derselben Hardware verändert, nicht die Modellfähigkeit selbst. Nach den Angaben des Berichts bleibt die Draft-Akzeptanzlänge in Langkontext-Szenarien bei etwa 5, was bedeutet, dass ein Vorwärtsdurchlauf des Hauptmodells etwa 5 Kandidaten-Token verifizieren und durchlassen kann, wodurch sich die wiederholten Dekodierrunden des Hauptmodells verringern und die Wartezeit nach dem ersten Token direkt sinkt. Für Teams, die einen eigenen GLM-5.3-Inferenzdienst betreiben, bedeutet dies, Dekodierdurchsatz zu gewinnen, ohne das Hauptmodell zu wechseln oder die Ausgabeverteilung zu ändern; der Preis ist das zusätzliche Laden eines Draft-Modell-Gewichtssatzes sowie entsprechender Speicher- und Scheduling-Overhead. Der Bericht zeigt zugleich, dass der Gewinn mit der Concurrency variiert: Bei Einzel-Concurrency ist die Geschwindigkeitssteigerung am größten, bei 64-facher Concurrency verengt sich der Gesamtdurchsatzgewinn auf 44,9 %, was nahelegt, dass der Nutzen eher in Interaktionsszenarien mit niedriger Concurrency liegt und der Durchsatzzuwachs pro Einheit bei Diensten mit hoher Concurrency begrenzt bleibt. Zu beachten ist: Alle Zahlen stammen aus Herstellerselbsttests, die Testumgebung ist fest auf TP=8 und 8×H200 gelegt, die Akzeptanzlänge hängt von der konkreten Datenverteilung ab, und außerhalb niedrig-entropischer Kontexte können die Ergebnisse anders ausfallen; die Offenlegung von Gewichten bedeutet nicht, dass die Lizenzbedingungen klar sind, sodass vor kommerzieller Nutzung die Lizenzinformationen im Repository geprüft werden müssen.
Integration und Bewertung
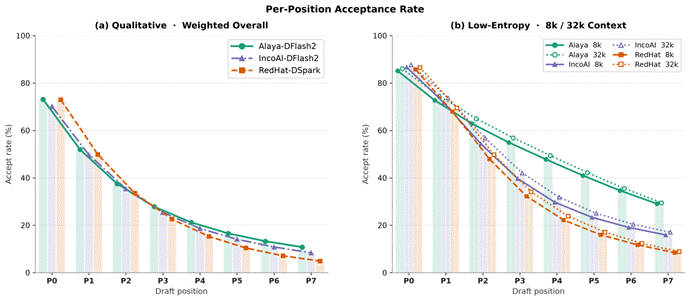
Empfohlen wird, die Entscheidung an den folgenden Bedingungen auszurichten, statt die Bewertungsergebnisse direkt zu übernehmen. Die erste Entscheidung ist, ob das Draft-Modell eingeführt wird. Besteht die Inferenzlast überwiegend aus Langkontext-Aufgaben mit niedriger bis mittlerer Concurrency wie Langdokument-Fragen oder RAG-Zusammenfassungen, stützen die im Bericht genannten Akzeptanzlängen von über 5 bei 16k bis 32k einen Vergleichstest mit echtem Verkehr; besteht die Last überwiegend aus kurzen Anfragen mit hoher Concurrency, steigt der Durchsatz bei 64-facher Concurrency laut Bericht nur um 44,9 %, sodass zunächst zu berechnen ist, ob der zusätzliche Speicherbedarf und Scheduling-Aufwand des Draft-Modells den Aufwand rechtfertigen. Als Bewertungskriterium kann dienen: auf eigenen 32k-Proben die gemessene Akzeptanzlänge und die Latenz zwischen Token messen; liegt die Akzeptanzlänge deutlich unter dem Berichtsniveau oder senkt der Speicherzuwachs die Concurrency-Obergrenze, dann nicht einführen. Die zweite Entscheidung betrifft die Konfiguration von Anzahl der Draft-Positionen und Verifikations-Batches. Der Bericht zeigt, dass die Akzeptanzrate in späteren Draft-Positionen noch nennenswert ist (bei 32k Position 5: 49,43 %, Position 8: 29,51 %), was dafür spricht, die Verifikationstiefe tiefer als standardmäßig zu wählen; dieser Gewinn gilt jedoch nur, wenn die Akzeptanzrate in späteren Positionen auf eigenen Daten ebenfalls erhalten bleibt. Nimmt die Akzeptanzrate bei Aufgabentypen wie Code und Rollenspiel, in denen der Bericht keinen Vorsprung ausweist, schnell ab, verschwendet eine längere Draft-Länge nur Rechenleistung. Als Bewertungskriterium kann dienen: die Trefferquote je Position erfassen, die Position bestimmen, an der die Akzeptanzrate eine festgelegte Schwelle unterschreitet, und die Draft-Länge entsprechend abschneiden. All dies sind bedingte Hinweise auf Grundlage der Berichtsdaten, keine vom Hersteller gegebene Deployment-Empfehlung.
Grenzen und offene Fragen
Alle Leistungsdaten im Bericht stammen aus Selbsttests von Jiuzhang Yunji; es gibt keine unabhängige Reproduktion, und Testdatensätze, Prompt-Vorlagen und Dekodierparameter wurden nicht offengelegt. Die Akzeptanzlänge hängt stark von der Datenverteilung ab und muss sich auf eigenem Verkehr nicht reproduzieren. Die Bewertungsumgebung ist fest auf 8×H200 und TP=8 gelegt; das Verhalten auf anderer Hardware und mit anderen Parallelkonfigurationen ist unbekannt. Die im Bericht genannte Offenlegung als Open Source nennt nur eine Gewichtsadresse, aber keinen Lizenztyp; die Verfügbarkeit von Gewichten bedeutet nicht, dass die Lizenzbedingungen beliebige kommerzielle Nutzung oder Weitergabe erlauben, maßgeblich sind die Erklärungen im Repository. Zudem ist Alaya-DFlash2 eine eigenständige Draft-Modelllösung für GLM-5.3 und nicht mit dem Hauptmodell selbst zu verwechseln; GLM-5.3 hat im aktuellen KimiSeek-Katalog tatsächlich einen entsprechenden Eintrag, doch die Beschleunigungslösung Alaya-DFlash2 selbst ist nicht als aufrufbares Modell bei KimiSeek gelistet, und die betreffende Verfügbarkeit richtet sich nach Hersteller und Gewichts-Repository.
Abbildungen aus dem Originalbericht