Kimi K3.1 Pro Highspeed bei Bedrock: Standard-Reasoning-Stufe max, Grenzen bei Flex und explizitem Caching
AWS gibt in einem Blogbeitrag vom 10. November 2026 an, Kimi K3.1 Pro Highspeed sei in Amazon Bedrock verfügbar und nutze die Endpunkte und APIs von K3; Moonshot AI gibt die Ausgabegeschwindigkeit mit dem 2- bis 3-Fachen von K3.1 Pro an. Die Standard-Reasoning-Stufe max, die Latenzkosten der Flex-Stufe und das Fehlen expliziten Cachings in Converse sind drei Punkte, die vor der Anbindung geklärt werden müssen.
Was sich geändert hat
AWS kündigte in einem Machine-Learning-Blogbeitrag vom 10. November 2026 an, dass Kimi K3.1 Pro Highspeed von Moonshot AI in Amazon Bedrock verfügbar ist. Der Beitrag beschreibt das Modell als nachtrainierte Version von Kimi K3: Sie nutze dieselbe offene Gewichtsarchitektur der 3T-Klasse und dasselbe Kontextfenster von einer Million Token, sei aber mit deutlich mehr Rechenleistung für das Nachtraining trainiert worden. Laut Moonshot AI richtet sich dieses Training auf langfristige Agentenaufgaben, soll faktische Fehler reduzieren und die Fähigkeiten bei Finanzmodellierung, Bürodokumenten sowie beim Programmieren für Game-Engines, 3D-Szenen und CAD-Skripte verbessern. Die Generierungsrate der Ausgabe-Token sei höher; Moonshot AI gibt die Geschwindigkeit mit dem 2- bis 3-Fachen von Kimi K3.1 Pro an. In Bedrock übernimmt das Modell Endpunkte, APIs und Funktionen von Kimi K3, sodass Anwendungen, die K3 bereits nutzen, nur die Modell-ID ändern müssen. Unterstützt werden Tool-Aufrufe, strukturierte Ausgaben, konfigurierbares Reasoning, Bildeingaben und Streaming-Ausgaben. Der Zugriff erfolgt über drei regionenübergreifende Inferenzprofile (global, us, in); Anforderungen an den Datenstandort bestimmen die Wahl des Profils. AWS zufolge werden Daten innerhalb der eigenen Datengrenze verarbeitet, nicht mit Moonshot AI geteilt und nicht zum Trainieren von Modellen verwendet; für Inferenzanfragen sei stets Zero Data Retention aktiv, und Betreiber könnten Prompts und Vervollständigungen während der Inferenz nicht einsehen. Die K3.1-Reihe wurde bereits zuvor berichtet; neu ist hier der verwaltete Bedrock-Kanal und die damit festgelegten Optionen für Reasoning und Abrechnung.
Auswirkungen für Entwickler
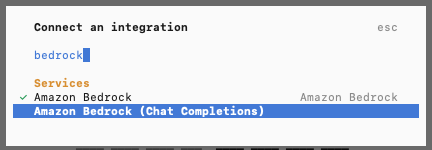
Die praktischen Auswirkungen für die Anbindung liegen vor allem bei der Schnittstellenform und den Standardwerten, nicht bei der Modellqualität selbst. Teams, die bereits das OpenAI SDK nutzen, können base_url auf den Bedrock-Runtime-Endpunkt richten und den Modellnamen ändern; die Authentifizierung erfolgt jedoch über kurzlebige Bearer-Token, die aus AWS-Anmeldedaten erzeugt werden. IAM benötigt die Berechtigungen InvokeModel und InvokeModelWithResponseStream, bei Bearer-Token zusätzlich CallWithBearerToken. Bedrock bietet sowohl OpenAI-kompatible Chat Completions und Responses als auch die eigenen Converse- und Invoke-APIs; AWS empfiehlt die ersteren. Zweitens ist das Reasoning standardmäßig auf Maximum gesetzt: Das Modell denkt immer erst nach und antwortet dann; ohne gesetzte Stufe gilt max. Bei Aufgaben mit kleinem Antwortraum wie Klassifikation, Feldextraktion oder kurzen Frage-Antwort-Paaren erhöht das direkt Latenz und Ausgabe-Token. Beim Auswerten von Converse-Antworten muss zudem der Textblock gezielt gewählt werden, da die Antwort mit einem Reasoning-Block beginnen kann. Drittens die Stufung: Laut AWS kostet Flex die Hälfte des Standard-Preises, dafür kann die Antwortzeit länger sein, und das On-Demand-Kontingent wird von Standard, Priority und Flex gemeinsam genutzt; Traffic nach Flex zu verlagern schafft also kein zusätzliches Kontingent. Die Stufe wird pro Anfrage angegeben, innerhalb einer Anwendung sind Mischungen möglich. Viertens die Schnittstellengrenze beim Caching: Explizites Prompt-Caching gilt für Chat Completions, Responses und Invoke, nicht für Converse. Vor dem Breakpoint müssen mindestens 256 Token stabiler Inhalt stehen, gecachte Inhalte bleiben mindestens 30 Minuten erhalten, Schreibvorgänge werden mit einem höheren Satz als Standard-Eingaben abgerechnet, Lesezugriffe mit einem Rabattsatz und zählen nicht auf das Eingabe-Token-Kontingent pro Minute. Bei Agenten und Programmierassistenten, die Systemanweisungen, Tool-Definitionen und Repository-Konventionen in jeder Runde erneut senden, beeinflusst die Cache-Trefferquote die Rechnung oft stärker als der Stückpreis. Der Beitrag erklärt außerdem, warum die Ausgabegeschwindigkeit bei Programmieragenten wichtiger ist: Dateien lesen, Änderungen planen, Code bearbeiten, Tests ausführen und Fehler beheben bilden eine Kette serieller Aufrufe, bei der jeder Schritt auf das Ende des vorigen wartet; mehr Token pro Zeiteinheit verkürzen den gesamten Zyklus. All dies sind strukturelle Änderungen auf der Kanalseite und keine unabhängige Bestätigung der Modellqualität.
Integration und Bewertung
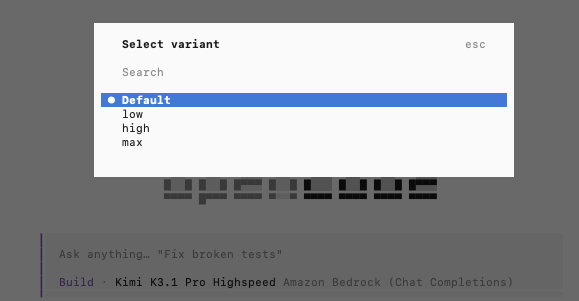
Die folgenden bedingten Analysen und Empfehlungen beruhen auf dem Bericht; es handelt sich um Empfehlungen, nicht um verifizierte Tatsachen. Entscheidung eins: Die Reasoning-Stufe explizit in die Konfiguration schreiben. Laut Bericht gilt ohne gesetztes reasoning_effort standardmäßig max; wählbar sind low, high und max, wobei in Responses dieselbe Einstellung über reasoning.effort erfolgt. Bei Lasten wie Klassifikation, Feldextraktion, kurzen Frage-Antwort-Paaren oder Vorlagen-Umschreibungen, deren Antwortraum klein ist, empfiehlt es sich, die Stufe je nach Aufgabentyp auf low oder high festzulegen und max nur auf Pfaden mit echtem Mehrschritt-Reasoning beizubehalten. Voraussetzung sind eigene Evaluationsergebnisse je Stufe statt einer intuitiven Herabsetzung; wenn die Kette harte Formatvorgaben für die Ausgabe hat, sollte außerdem geprüft werden, ob eine niedrigere Stufe weniger Felder in strukturierten Ausgaben liefert. Messkriterium: Auf demselben eigenen Aufgabensatz Erfolgsquote und Median der Ausgabe-Token von low und max vergleichen; sinkt die Erfolgsquote nur innerhalb eines akzeptablen Bereichs, während die Ausgabe-Token deutlich zurückgehen, gehört die Stufe in die Konfiguration statt in den Standardwert. Entscheidung zwei: Die Service-Stufe pro Anfrage wählen und prüfen, welche tatsächlich greift. Laut AWS kann Flex langsamer, aber günstiger sein; die Stufe ist pro Anfrage einstellbar, und alle drei Stufen teilen sich das Kontingent. Bei Offline-Evaluationen, Batch-Zusammenfassungen oder Hintergrundschritten in Agenten, die nicht auf einzelne Antwortzeiten angewiesen sind, kann ein kleiner Teil des Traffics auf Flex laufen, während synchrone, nutzerseitige Anfragen bei Standard oder Priority bleiben. Voraussetzung ist, anhand der Dimensionen ServiceTier und ResolvedServiceTier in CloudWatch zu bestätigen, welche Stufe die Anfrage tatsächlich bedient hat, denn Flex anzufordern und von Flex bedient zu werden sind zwei verschiedene Dinge, und gemischte Stufen verändern zugleich Tail-Latenz und Kontingentverbrauch. Messkriterium: p95-Latenz und Kosten pro tausend Aufgaben derselben Charge unter Flex und Standard; erst wenn die Kosten sinken und die Tail-Latenz im eigenen Timeout-Budget bleibt, sollte der Anteil erhöht werden. Entscheidung drei: Die Cache-Verfügbarkeit als Auswahlkriterium für die Schnittstelle behandeln, nicht als nachträgliche Optimierung. Explizites Caching ist in Converse nicht verfügbar, vor dem Breakpoint sind mindestens 256 Token stabiler Inhalt nötig, und der Cache bleibt mindestens 30 Minuten erhalten. Läuft der Dienst bereits auf Converse und enthält der Kontext lange stabile Präfixe (Systemanweisungen, Tool-Definitionen, Repository-Konventionen), ist zu entscheiden, ob man für explizites Caching auf Chat Completions oder Responses wechselt oder sich auf automatisches Caching verlässt: Der Wechsel kann die Trefferquote erhöhen, verlangt aber einen geänderten Aufrufpfad und akzeptiert höhere Abrechnungssätze für Cache-Schreibvorgänge. Messkriterium: Zuerst in den Nutzungsdaten die Zahl der Cache-Token prüfen und bestätigen, dass sie größer als null ist; dann Eingabekosten und Latenz bis zum ersten Token vor und nach der Aktivierung vergleichen und zugleich prüfen, dass die Trefferquote nach leichter Anpassung der Breakpoint-Position nicht deutlich einbricht. Ein weiterer Punkt sollte in der Architekturprüfung festgelegt werden: Das globale Profil kostet pro Token weniger als geografische Profile, bei Anforderungen an den Datenstandort bleibt jedoch nur us oder in; eine spätere Änderung betrifft die Deployment-Topologie. Wer Kimi K3 bereits produktiv in Bedrock nutzt, sollte als minimale Prüfung eine Aufgabengruppe parallel gegen K3 und Highspeed laufen lassen und die Zeit bis zum Abschluss einer Aufgabe sowie die Zahl der Wiederholungen bei Fehlern vergleichen, statt nur die Geschwindigkeit des ersten Pakets zu betrachten.
Grenzen und offene Fragen
Zwei Unsicherheiten sind zu beachten. Erstens ist die Angabe vom 2- bis 3-Fachen eine selbst berichtete Geschwindigkeit von Moonshot AI; der AWS-Blogbeitrag nennt keine Benchmark, Messmethode oder Parallelitätsbedingungen. Der tatsächliche Unterschied hängt von der Ausgabelänge und der genutzten Stufe ab und ist keine unabhängig reproduzierte Schlussfolgerung. Zweitens beschreibt die Formulierung "offene Gewichtsarchitektur der 3T-Klasse" die Architektur, während Bedrock einen verwalteten Inferenzdienst liefert: Ob die Gewichte herunterladbar sind und unter welcher Lizenz sie veröffentlicht werden, lässt sich daraus nicht ableiten; dafür sind die offizielle Veröffentlichung und der Lizenztext von Moonshot AI zu prüfen. Selbst wenn Gewichte herunterladbar sind, bedeutet offene Gewichte nicht automatisch eine Open-Source-Lizenz. Eine weitere leicht zu verwechselnde Stelle: Laut Originaltext beziehen sich mehr Nachtrainings-Rechenleistung, weniger faktische Fehler und die Verbesserungen bei Finanzmodellierung, Bürodokumenten, Game-Engines, 3D und CAD-Skripten auf den Vergleich mit Kimi K3; zwischen Highspeed und Nicht-Highspeed von K3.1 Pro nennt der Beitrag als Unterschied vor allem die Generierungsrate der Ausgabe-Token. Eine detaillierte Fähigkeitsgegenüberstellung der beiden Varianten und unabhängige Evaluationsdaten zu Highspeed enthält er nicht. Die Angabe, der Cache bleibe "mindestens 30 Minuten" erhalten, nennt nur eine Untergrenze, keine Obergrenze; die Latenzkosten von Flex werden nur qualitativ beschrieben. Unterstützte Regionen, Kontingente und Preise sollten anhand der Modellkarte, der Seite zur regionalen Verfügbarkeit und der Preisseite von Bedrock geprüft werden, da sich diese Angaben ändern. Im Katalog der Website gab es bei dieser Prüfung bereits einen gleichnamigen Eintrag; Preise und Kontingente sind dort auf der Preisseite zu finden. Die Katalogaufnahme und die Verfügbarkeit in Bedrock sind jedoch zwei unabhängige Dinge, und erstere bestätigt letztere nicht.
Abbildungen aus dem Originalbericht