Kimi K3.1 Pro veröffentlicht: 2,8T/104B MoE mit 1M Kontext, API verfügbar
Laut einem Marktechpost-Bericht vom 23. Oktober 2026 hat Moonshot AI mit Kimi K3.1 Pro das erste Modell der K3.1-Reihe veröffentlicht. Es nutzt eine MoE-Architektur mit 2,8T Gesamtparametern und 104B aktiven Parametern, unterstützt einen Kontext von 1M Token und ist in der Kimi-API verfügbar. Die API-Preise liegen unter denen von K3; offene Gewichte werden für November 2026 erwartet. Die selbst gemeldeten Benchmarks liegen beim Coding nahe der Frontier, fallen aber bei wissenschaftlichen Terminal-Aufgaben deutlich ab.
Was sich geändert hat
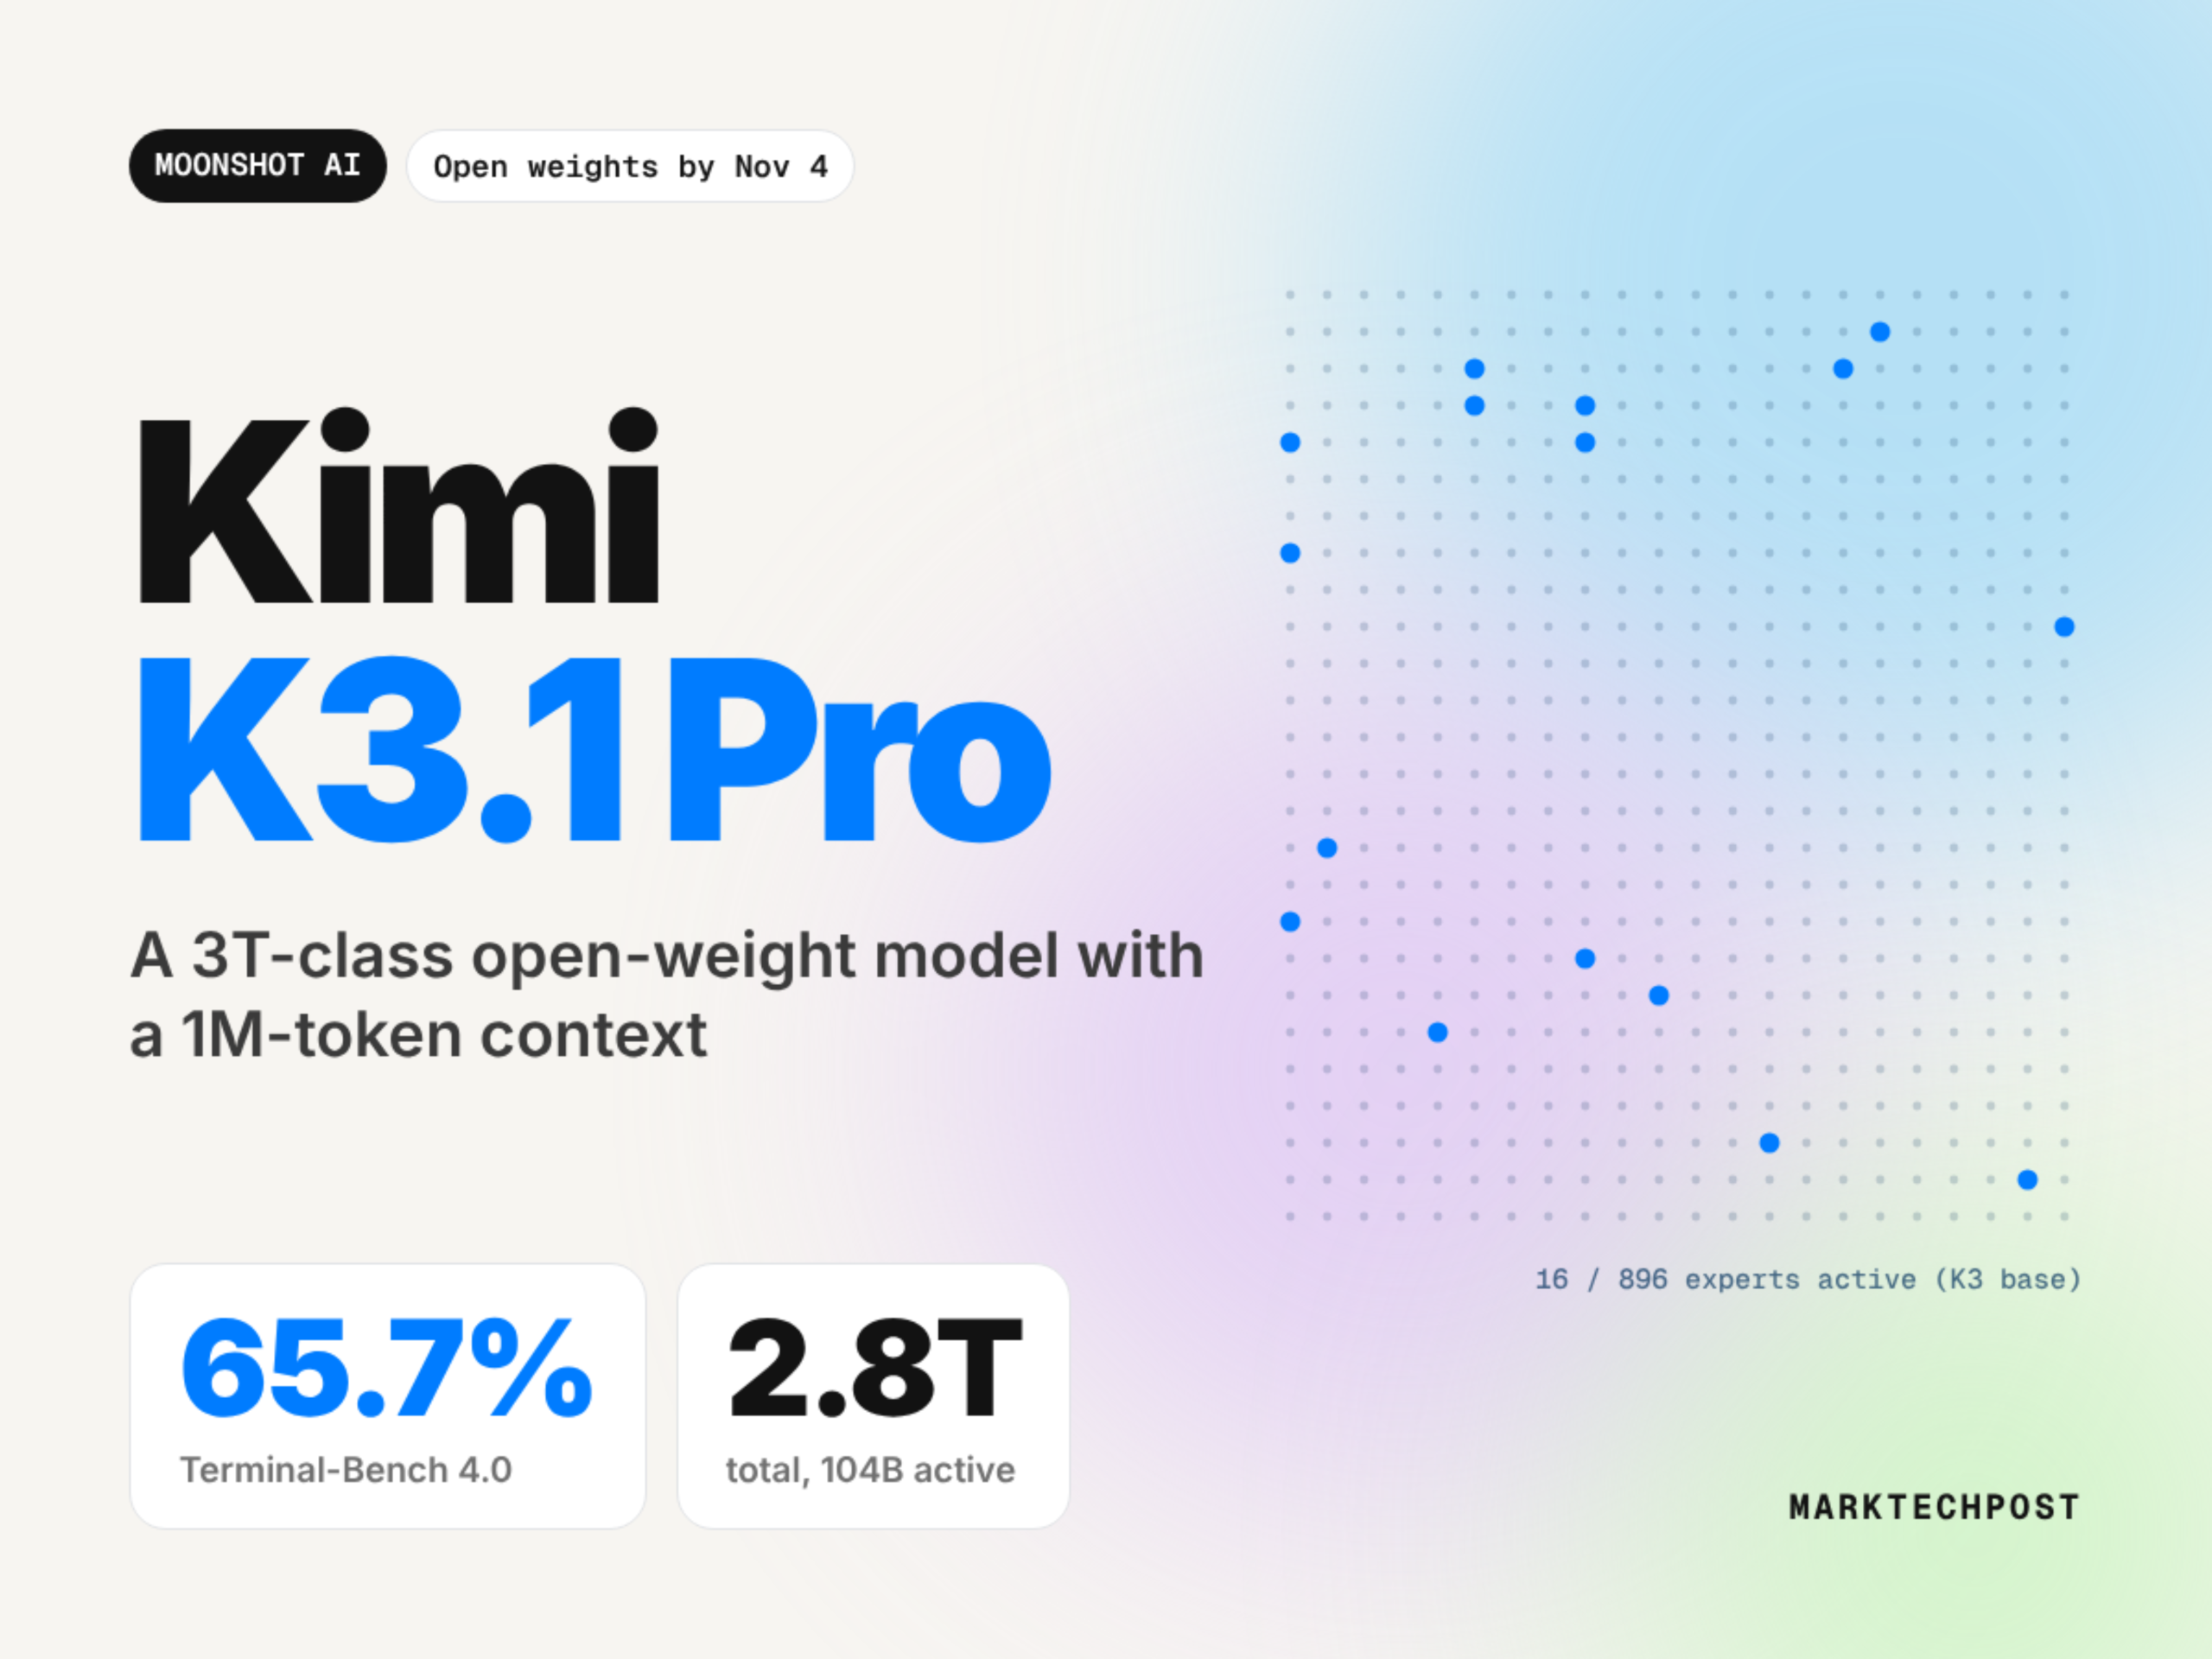
Laut einem Marktechpost-Bericht vom 23. Oktober 2026 hat Moonshot AI mit Kimi K3.1 Pro das erste Modell der K3.1-Reihe veröffentlicht. Es handelt sich um eine nachtrainierte Version von K3, für die der Bericht deutlich höheren Nachtrainings-Rechenaufwand und gemeinsames Reinforcement Learning über Hunderte nachgelagerte Bereiche angibt. Die Quelle nennt 2,8T Gesamtparameter und 104B aktivierte Parameter (MoE); die K3-Basisarchitektur verwendet Kimi Delta Attention und Attention Residuals, aktiviert über Stable LatentMoE 16 von 896 Experten und unterstützt 1M Token Kontext. Die API akzeptiert Text, Bilder und Videos. Zeitgleich wurde eine Highspeed-Variante veröffentlicht, die laut offiziellem Blog 2- bis 3-mal schneller sein soll. Die API-Kennungen lauten kimi-k3.1-pro und kimi-k3.1-pro-highspeed, der Endpunkt ist OpenAI-kompatibel. Der Bericht zitiert die Quelle dahingehend, dass die API-Preise unter K3 liegen und Cache-Treffer separat abgerechnet werden; offene Gewichte sind noch nicht veröffentlicht und werden für November 2026 erwartet. Alle Benchmark-Daten sind von Moonshot selbst gemeldet und größtenteils mit maximalem Inferenzaufwand und im Claude-Code-Harness erzielt: Terminal-Bench 4.0 erreicht 65,7 %, SWE-Marathon 51,7, Terminal-Bench Science 0.1 nur 38,1; auf dem internen Kimi Hallu Bench Hard sinkt die aussagenbezogene Halluzinationsrate von 23,4 % bei K3 auf 8,3 %. Die Schnellstart-Dokumentation nennt mehrere praktische Einschränkungen: Der Denkmodus ist immer aktiv, der Inferenzaufwand ist in low, high und max unterteilt (Standard max); Temperatur 1.0 und top-p 0.95 sind feste Werte; die Ausgabe beträgt standardmäßig 131.072 Token, maximal 1.048.576; visuelle Eingaben akzeptieren keine öffentlichen Bild-URLs, sondern erfordern Base64 oder eine hochgeladene Datei-ID.
Auswirkungen für Entwickler
Die unmittelbaren Auswirkungen auf Entwickler konzentrieren sich auf drei Punkte: Integrationsweg, Kostenstruktur und Verhalten bei langem Kontext. Erstens ist dies das erste Modell der K3.1-Reihe; die Darstellung beschreibt es als nachtrainierte Iteration von K3 und nicht als völlig neue Architektur, was die Migration im Vergleich zu einem Generationswechsel günstiger machen könnte. API-Kennungen und Parameter des Denkmodus müssen jedoch neu bestätigt werden: Da der Denkmodus immer aktiv ist und der Inferenzaufwand standardmäßig max beträgt, müssen Aufrufpfade, die bisher auf deaktiviertes Reasoning oder manuelle Steuerung des Denkbudgets setzten, neu entworfen werden, sonst fallen Latenz und Token-Verbrauch höher aus als erwartet. Zweitens akzeptiert das Modell laut Quelle über die API Text, Bilder und Videos, aber ausdrücklich keine öffentlichen Bild-URLs; Base64 oder eine hochgeladene Datei-ID sind erforderlich. Das ist eine konkrete Einschränkung für Aufbau, Größe und Upload-Ablauf multimodaler Pipelines. Drittens bedeuten 1M Kontext und eine maximale Ausgabe von 1.048.576 Token, dass größere Repositories oder Logs direkt in eine einzelne Anfrage passen. Die Quelle weist jedoch darauf hin, dass die vollständige Assistant-Nachricht zurückgegeben werden sollte, und K3 warnte bereits, dass das Verwerfen von Reasoning-Verlauf im Harness zu instabiler Ausgabe führen kann. Werden Reasoning-Verläufe weiterhin abgeschnitten, kann der Nutzen des langen Kontexts verloren gehen. Zur Preisgestaltung nennt die Quelle für die Standardversion 2 US-Dollar pro Million Token Eingabe und 10 US-Dollar Ausgabe, für Highspeed 4/20 US-Dollar und damit weniger als die 3/15 US-Dollar von K3; dies ist die am Berichtstag wiedergegebene Herstellerpreisangabe. Maßgeblich sind die KimiSeek-Preisseite und die tatsächliche Abrechnung; Preise ändern sich. Wichtig: K3.1 Pro ist derzeit nicht im Echtzeit-Modellkatalog von KimiSeek aufgeführt; die in der Quelle genannte API-Verfügbarkeit bezieht sich auf die Herstellerseite.
Integration und Bewertung
Empfohlen wird, zwei unabhängige Entscheidungen zu verfolgen; beide sind bedingte Analysen und keine Schlussfolgerungen der Quelle. Entscheidung eins: ob bestehende Coding- oder Terminal-Agenten von K3 auf K3.1 Pro migriert werden. Die von der Quelle berichtete Änderung besteht in durchgängig besseren Coding-Benchmarks und niedrigeren Preisen, während wissenschaftliche Terminal-Aufgaben deutlich schlechter abschneiden. Die Wahl hängt von der Zusammensetzung der eigenen Workloads ab: Stehen repository-weites Coding, SWE-artige Fehlerbehebungen und Terminal-Automatisierung im Vordergrund, ist ein kleiner grauer Test möglich; enthält die Mischung viele wissenschaftliche Berechnungen, Simulationen oder forschungsnahe Terminal-Aufgaben, sollten bestehende Modelle beibehalten oder parallel geroutet werden. Messbare Bewertungskriterien: auf dem eigenen Coding-Aufgabensatz K3 und K3.1 Pro bei Aufgabenabschlussrate und Anteil manuell zu korrigierender Fälle vergleichen, zugleich die für gleiche Qualität nötige Gesamttokenzahl erfassen und mit der von der Quelle wiedergegebenen Preisstruktur die Kosten pro Aufgabe berechnen; erst wenn die Abschlussrate nicht sinkt und die Kosten pro Aufgabe fallen, sollte der Verkehr ausgeweitet werden. Entscheidung zwei: ob die Highspeed-Variante aktiviert wird. Die Quelle berichtet, Highspeed sei 2- bis 3-mal schneller, aber teurer pro Einheit, und der Inferenzaufwand sei fest auf max gesetzt. Die Wahl hängt von Interaktionslatenz-Anforderungen ab: Für Inline-Vervollständigung in der IDE oder Agent-Schleifen mit Mensch-Maschine-Wechsel, bei denen die durch festes max-Reasoning entstehende Ausgabelänge tolerierbar ist, sollte Highspeed vorrangig getestet werden; für Batch-Offline-Aufgaben mit Kostenempfindlichkeit ist die Standardversion sinnvoller. Bewertungskriterien: bei fester Nebenläufigkeit die End-to-End-P95-Latenz und die pro Sekunde abgeschlossenen Aufgaben messen und prüfen, ob die Latenzsenkung den höheren Stückpreis aufwiegt. Gemeinsame Voraussetzung beider Entscheidungen: zuerst prüfen, ob die Parameterbeschränkungen der Schnellstart-Dokumentation zum bestehenden Client passen, insbesondere feste Temperatur und top-p sowie die fehlende Unterstützung öffentlicher URLs bei visuellen Eingaben; vor jedem Wechsel sollte ein Rückschalter erhalten bleiben, da offene Gewichte noch nicht veröffentlicht sind und kurzfristig kein Self-Hosting möglich ist.
Grenzen und offene Fragen
Klarzustellen ist: Kimi K3.1 Pro steht derzeit nicht im Echtzeit-Modellkatalog von KimiSeek; die in der Quelle genannte API-Verfügbarkeit bezieht sich auf die Herstellerseite, und vor der Integration sind Herstellerdokumentation und tatsächlicher Katalog maßgeblich. Die meisten Benchmark-Zahlen der Quelle sind von Moonshot selbst gemeldet und größtenteils mit maximalem Inferenzaufwand und im Claude-Code-Harness erzielt; die Vergleichsdiagramme stammen von der Hersteller-Vergleichsseite und wurden nicht auf Wettbewerberseiten bestätigt, taugen also nicht als unabhängig verifizierte Leistungsaussage; einige Siege stammen aus internen Benchmarks. Der deutliche Rückstand bei wissenschaftlichen Terminal-Aufgaben ist eine von der Quelle selbst genannte Schwäche, doch auch seine konkreten Werte folgen der Selbstauskunft. Offene Gewichte werden für November 2026 erwartet; dieser Zeitpunkt ist eine von der Quelle wiedergegebene Erwartung und kann sich ändern. Derzeit ist kein Self-Hosting möglich, und die Größe von 2,8T deutet auf einen Multi-Node-Servicebetrieb hin. Die Preise sind am Berichtstag wiedergegebene Herstellerangaben und können jederzeit angepasst werden. Anfrage-Parameterbeschränkungen, der immer aktive Denkmodus und feste Temperaturwerte stammen aus der von der Quelle zitierten Schnellstart-Dokumentation; tatsächliches Verhalten ist anhand der neuesten Herstellerdokumentation zu prüfen. Zudem wurde die Modellveröffentlichung bereits in jüngeren Berichten behandelt; der Wert dieser Quelle liegt in ergänzenden Integrationsbeschränkungen und technischen Details, nicht in der Erstbestätigung.