Kyutai veröffentlicht CADRE Video-Autoencoder: Aktionslatenz im Weltmodell unter 230 Millisekunden, Gewichte nicht für kommerzielle Nutzung
Laut einem Bericht von MarkTechPost vom 23. Oktober 2026 hat Kyutai CADRE veröffentlicht, einen kausalen Diffusions-Repräsentations-Autoencoder. Das Paper gibt an, dass sein Weltmodell auf einer einzelnen H100 mit 20 fps läuft und innerhalb von 185 bis 216 Millisekunden antwortet. Der Code steht unter MIT, die Hugging-Face-Gewichte jedoch unter CC BY-NC 4.0, was eine kommerzielle Nutzung ausschließt; die Quelle nennt zugleich Schwächen wie die Aktionsverfolgung bei Roboter-Manipulation.
Was sich geändert hat
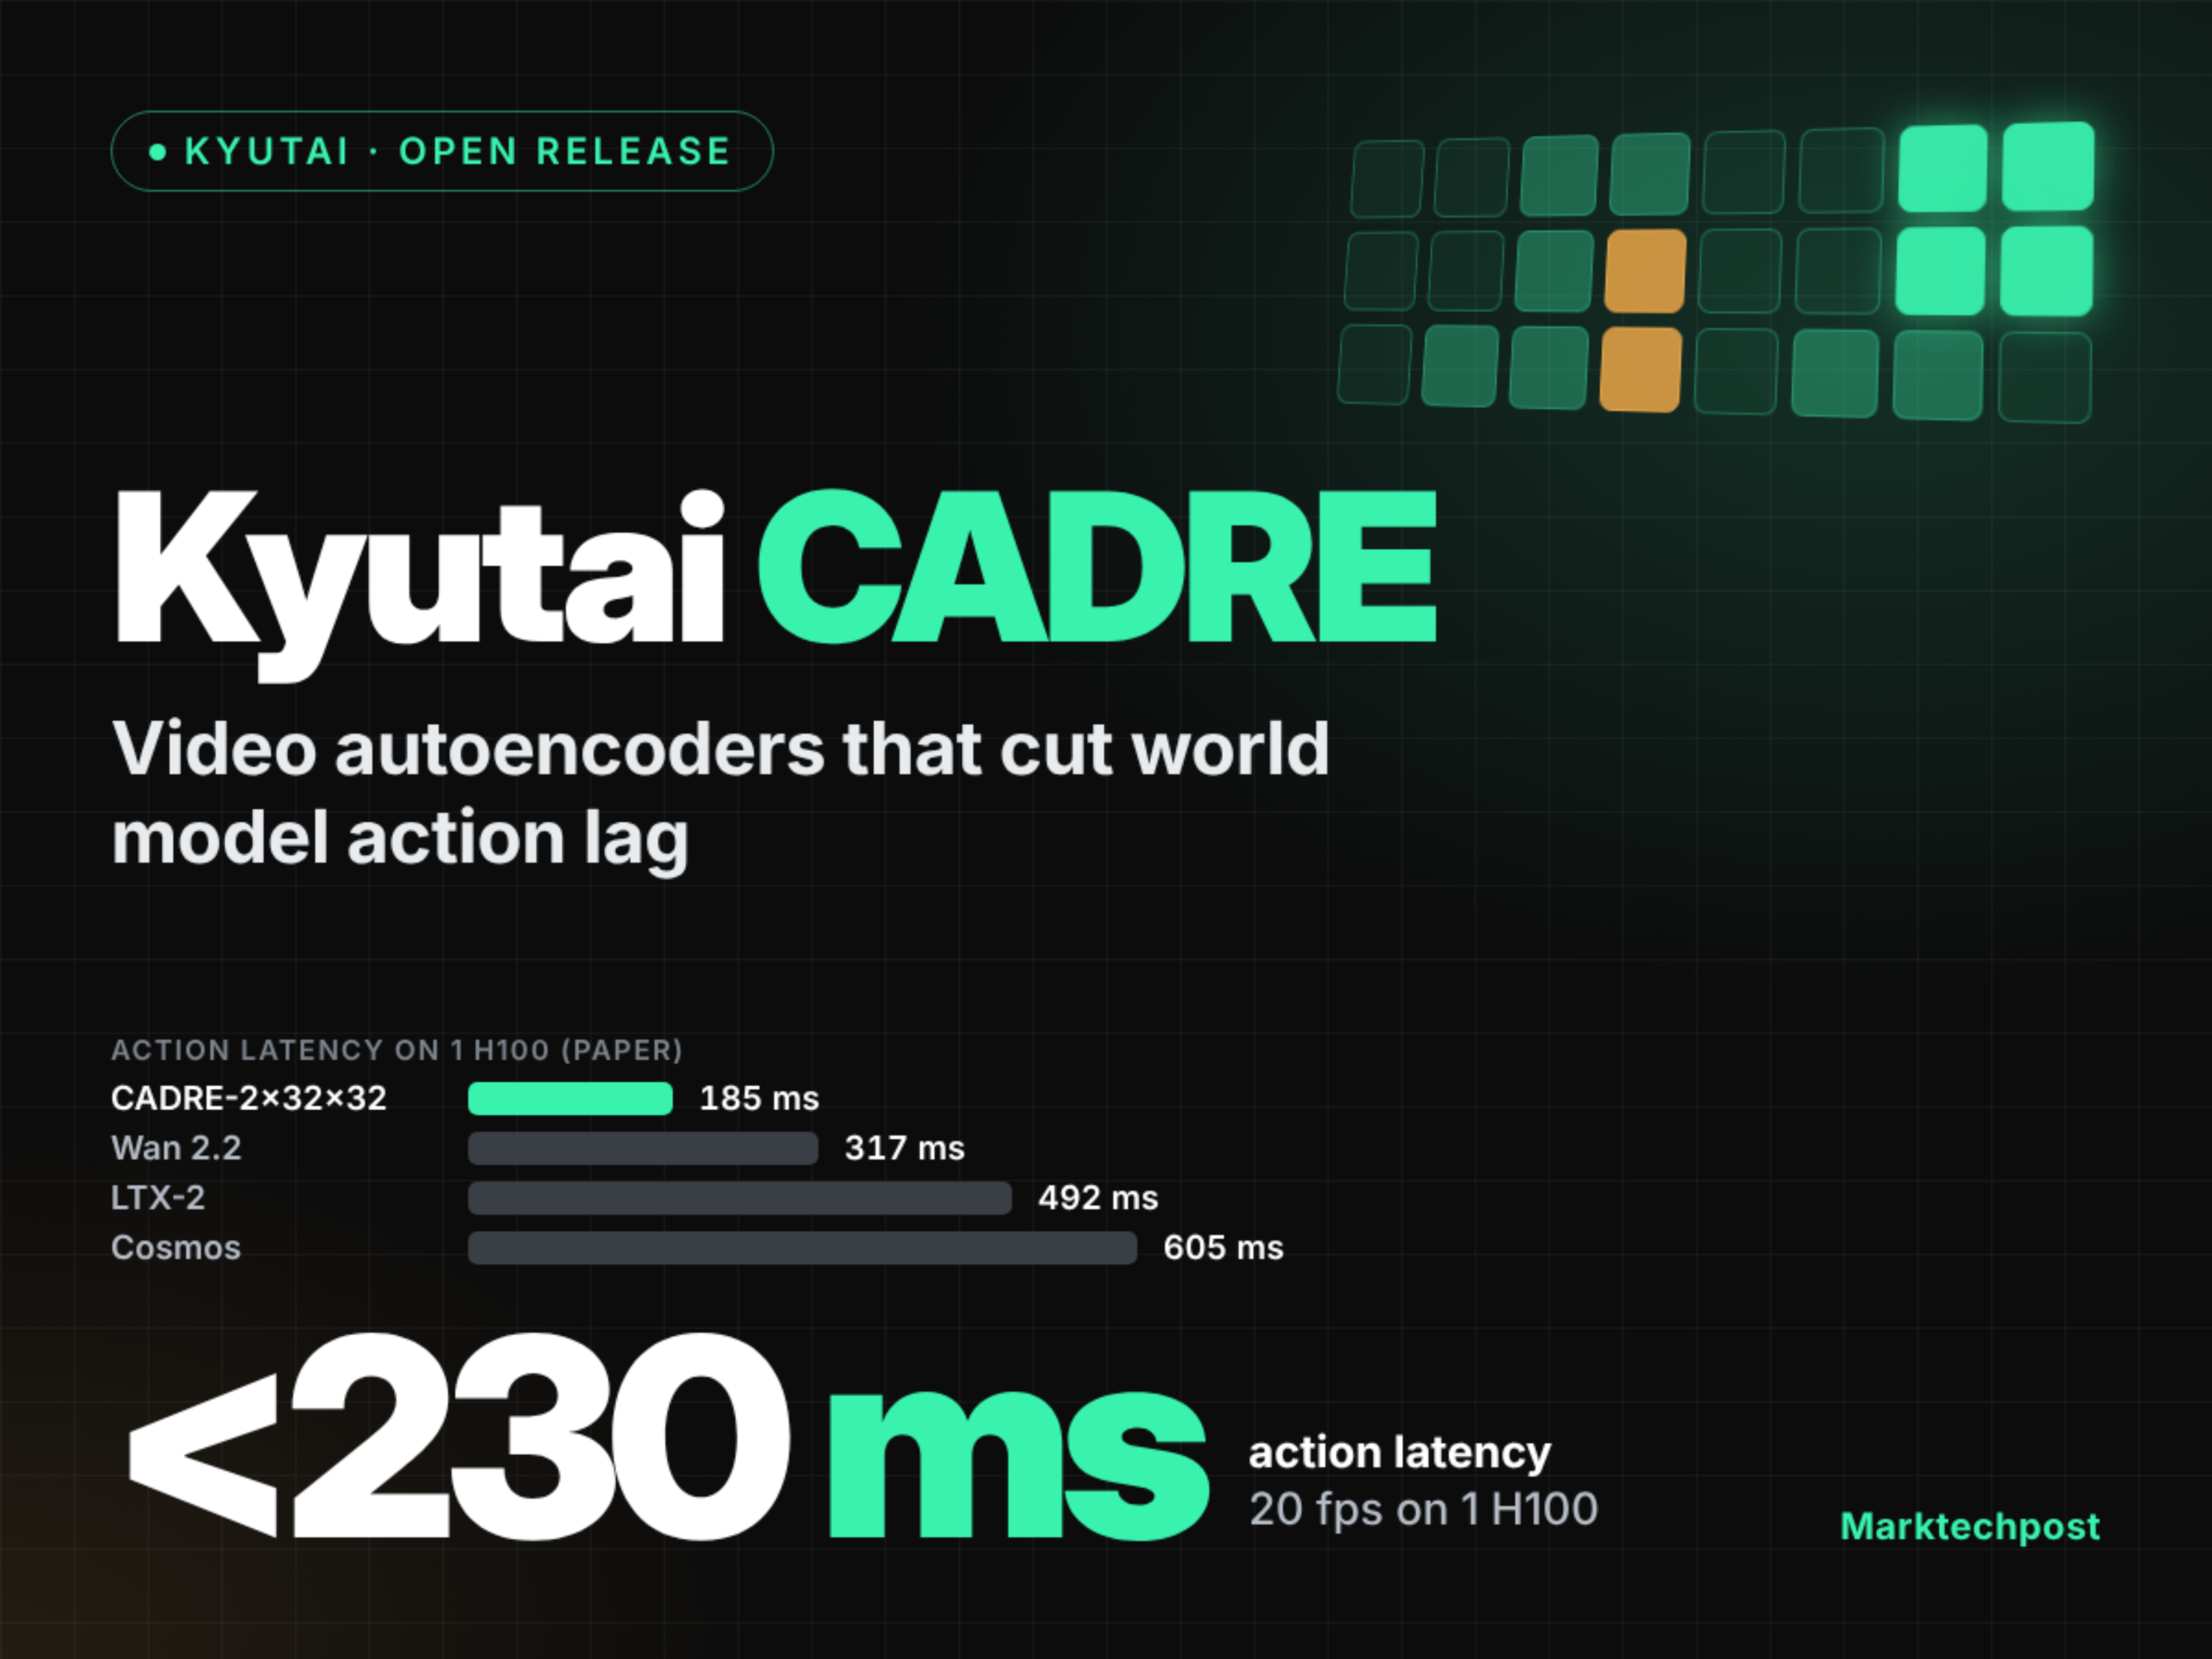
Laut einem Bericht von MarkTechPost vom 23. Oktober 2026 hat Kyutai CADRE veröffentlicht, eine Gruppe von Video-Autoencodern für aktionskonditionierte interaktive Weltmodelle. Das zugrunde liegende Problem ist: Die meisten Weltmodelle übernehmen Autoencoder aus der Text-zu-Video-Generierung und packen mehrere Frames in eine latente Variable, sodass jede Aktion warten muss. Die Kompressionsrate wird als τ×s×s angegeben, wobei τ für die Anzahl der Frames pro latenter Variable und s für den räumlichen Faktor steht; das Paper nennt als Latenz τ/f plus Generierungs- und Dekodierungszeit. Der CADRE-Encoder übernimmt den MIRA-Ansatz: Ein eingefrorenes DINOv3 extrahiert Patch-für-Patch-Merkmale, die dann durch eine trainierte 3D-Faltung zu 64-Kanal-Latenten komprimiert werden; zwischen den 7 Varianten ändert sich nur dieser Engpass. Der Decoder ist ein kausaler Diffusions-Transformer mit 24 Blöcken, der blockweise streamt und durch progressives Selbst-Destillieren die 1- oder 2-Schritt-Dekodierung erlernt. Die Quelle gibt an, dass der Autoencoder auf etwa 76.000 Stunden aus 23 öffentlichen Videoquellen trainiert wurde, die Web-, Roboter-, Fahr- und Spielvideos abdecken. Die berichteten Daten zeigen, dass CADRE-2×32×32 auf einer einzelnen H100 in bf16 mit Batch 1 in 185 Millisekunden antwortet und 23,4 fps hält, CADRE-2×16×16 bei 216 Millisekunden liegt; zum Vergleich: der Wan-2.2-Autoencoder bei 317 Millisekunden, LTX-2 bei 492 Millisekunden, Cosmos bei 605 Millisekunden, DC-AE ist schneller, arbeitet aber Frame für Frame. Diese Zahlen und Vergleiche stammen von Kyutai selbst und wurden nicht unabhängig reproduziert.
Auswirkungen für Entwickler
Die praktischen Auswirkungen für Entwickler konzentrieren sich auf drei Ebenen. Erstens verändert sich die Zusammensetzung des Latenzbudgets: CADRE drückt die Blockwartezeit von mehreren Hundert Millisekunden im τ=8-Szenario auf die Größenordnung von τ=2, was bedeutet, dass unter der Vorgabe von 20 fps und der für das menschliche Auge wahrnehmbaren Schwelle von 230 Millisekunden das ursprünglich von der Blocklatenz verbrauchte Budget an den Controller oder die Rendering-Stufe zurückgegeben werden kann; das eignet sich für interaktive Simulationen und Roboter-Wiedergabe-Bewertungen, die empfindlich auf Aktionsverfolgung reagieren. Zweitens wird die Kompressionsrate zu einer explizit einstellbaren Variable: Die 7 Autoencoder unterscheiden sich nur in einem Engpass, und laut Quelle sind in 48 Vergleichen 42 in der Geschwindigkeit vergleichbar und in der Qualität besser, sodass Entwickler den räumlichen und den zeitlichen Faktor als unabhängige Regler behandeln können, statt eine feste Kompression eines einzelnen Video-VAE zu akzeptieren. Drittens gibt es Lizenz- und Deployment-Einschränkungen: Der Code steht unter MIT, die Gewichte jedoch unter CC BY-NC 4.0, und die Quelle stellt ausdrücklich fest, dass dies kommerzielle Nutzung ausschließt; kommerzielle Produkte können daher nur die Methode übernehmen oder selbst trainieren, aber die Gewichte nicht direkt weitergeben. Die Quelle weist außerdem darauf hin, dass jedes Weltmodell mit 288×512 eine einzelne Umgebung abdeckt und die Übertragbarkeit auf allgemeine Modelle noch zu prüfen ist; lange latente Variablen hinterlassen sichtbare Nähte zwischen den Blöcken, wobei die Grenzüberschreitung bei τ=8 bis zu 1,6 bis 1,8 beträgt. Dies sind alles Forschungsbefunde aus dem Quellenbericht.
Integration und Bewertung
Das Folgende ist eine bedingte Analyse auf Grundlage der Quelleninformationen und keine verifizierte Tatsache. Erste Entscheidung: Wenn Ihre Arbeitslast statische oder langsam bewegte Kameraszenen umfasst, können Sie Varianten mit stärkerer zeitlicher Kompression bevorzugen, etwa Konfigurationen mit höherem τ und gröberem räumlichem Faktor; bei schnellen Kamerabewegungen sollten Sie zu Konfigurationen mit weniger Frames und größerem räumlichem Faktor wechseln, da die Quelle angibt, dass bewegte Kameras Letzteres bevorzugen und CADRE im Fahr-Szenario beim FVD deutlich besser als Wan 2.2 abschneidet. Voraussetzung ist, dass Ihr Evaluationsset Kamera-Bewegungsmuster enthält, die mit dem Deployment-Szenario übereinstimmen; messbares Kriterium ist, ob die Aktionsverfolgungsmetrik ARR oder der Fahr-FVD auf demselben Hold-out-Set Ihren Schwellenwert erreicht, und nicht nur die Rekonstruktions-PSNR. Zweite Entscheidung: Wenn Ihr Ziel Roboter-Manipulationsaufgaben sind, sollten Sie nicht annehmen, dass CADRE durchweg überlegen ist, denn laut Quelle beträgt die ARR von CADRE-2×32×32 bei Roboter-Manipulation 0,45, während Wan 2.2 bei 0,85 liegt, und auch Cosmos hat einen niedrigeren FVD. In diesem Fall sollten Sie zunächst auf lokalen Roboter-Manipulationsdaten kurze Rollout-Vergleiche der Kandidatenvarianten durchführen; Kriterium ist, dass die ARR gegenüber der Baseline nicht sinkt und die Latenz weiterhin in Ihrem Budget liegt; andernfalls behalten Sie andere Autoencoder oder Hybridlösungen bei. Bei den Evaluationsschritten empfiehlt es sich, den von der Quelle beschriebenen Ablauf zu reproduzieren: Zuerst 2 Sekunden echtes Video einspeisen, dann etwa 4,8 Sekunden generieren, gleichzeitig mit einer eingefrorenen inversen Dynamiksonde die ARR berechnen und prüfen, ob an den Blockgrenzen sichtbare Nähte auftreten, die bei größerem τ deutlicher werden. Wenn Sie ein eigenes Weltmodell trainieren möchten, beachten Sie, dass der in der Quelle genannte kausale Diffusions-Transformer mit 1,2 Milliarden Parametern für jeden Autoencoder separat trainiert wird; ein Wechsel des Autoencoders bedeutet also, dass das nachgelagerte Modell neu trainiert werden muss und nicht einfach der Encoder ausgetauscht werden kann. Vor der kommerziellen Nutzung sollten Sie die Lizenzbedingungen der Gewichte selbst prüfen und gegebenenfalls auf Autoencoder mit permissiver Lizenz wie Apache 2.0 umsteigen.
Grenzen und offene Fragen
Die Latenz-, fps-, FVD-, ARR-, PSNR- und Vergleichsangaben in der Quelle stammen von Kyutai selbst; dieser Artikel hat keine unabhängige Reproduktion und keine Tests durchgeführt. Quantisierte Versionen wurden nicht offengelegt, die Quelle nennt nur Daten für bf16, Batch 1 auf einer einzelnen H100, sodass Speicherbedarf, Multi-Batch-Durchsatz und Genauigkeitsverlust nach Quantisierung im tatsächlichen Deployment unbekannt sind. Die Quelle stellt ausdrücklich fest, dass die Gewichte unter CC BY-NC 4.0 stehen und kommerzielle Nutzung ausschließen, während der Code unter MIT steht; die beiden Lizenzen sind unterschiedlich und sollten nicht vermischt werden. Die Quelle erklärt außerdem, dass jedes Weltmodell nur eine Umgebung abdeckt, ob die Ergebnisse auf allgemeine Modelle übertragbar sind, bleibt offen, und CADRE ist bei der Aktionsverfolgung in der Roboter-Manipulation schwächer als Wan 2.2. Zu erwähnen ist, dass diese CADRE-Version derzeit nicht im Live-Katalog von KimiSeek erscheint; die in der Quelle erwähnten Hugging-Face-Downloads und Online-Demos gehören zu Kyutais eigenen Kanälen und stehen nicht mit dieser Seite in Verbindung; falls sie künftig eingeführt werden oder sich die Preisgestaltung ändert, gilt die Preisübersicht der Seite.