Liquid AI veröffentlicht LFM3: sechs Modelle der 2B-Klasse mit gemeinsamem Backbone und offenen Gewichten
Laut einem Blogbeitrag von Liquid AI vom 27. Oktober 2026 vereint LFM3 Text-, Vision-, Audio-, Omni- und Entscheidungsmodelle auf einem gemeinsamen Backbone der 1,7B-Klasse. Das Unternehmen gibt an, alle Gewichte seien offen und ein Fine-Tuning auf einer einzelnen GPU sei möglich. Entwickler müssen daher zwischen dem Omni-Einzelmodell und spezialisierten kleinen Modellen abwägen.

Was sich geändert hat
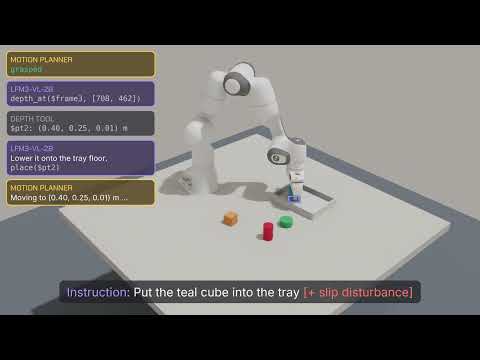
Liquid AI hat die LFM3-Reihe am 27. Oktober 2026 im offiziellen Blog veröffentlicht. Dem Blog zufolge umfasst die Reihe sechs Modelle der 2B-Klasse: LFM3-1.7B (Text), LFM3-VL-2B (Text-, Bild- und Videoeingabe), LFM3-Audio-2B (Text- und Audioeingabe, Text- und Sprachausgabe), LFM3-Omni-2B (Omni-Eingabe, Text- und Sprachausgabe) sowie die Entscheidungsmodelle d1-2B und d1-omni-2B auf Basis der Vision- und Omni-Zweige; zusätzlich gibt es LFM3-1.7B-Base für eigenes Post-Training. Laut Hersteller stammen alle Modelle von einem gemeinsamen Backbone ab, sind über Hugging Face verfügbar und lassen sich auf einer einzelnen GPU feinjustieren. Das Textmodell belege in 4-Bit-Präzision etwa 1 GB, das Kontextfenster des Backbones sei auf 256K Token erweitert. Der Blog nennt zudem Vergleichszahlen, etwa LFM3-1.7B mit 38,42 auf WebArena-Verified gegenüber 3,02 für das Vorgängermodell LFM2.5-2.6B; bei LFM3-VL-2B sei der Durchschnitt über 62 Vision-Benchmarks von 57,6 auf 71,4 gestiegen. Der Hersteller behauptet außerdem, parameternormiert sei LFM3-1.7B bei kurzen Prompts auf Edge-Geräten mit LFM2-1.2B vergleichbar und bei 8K Token Kontext rund 25 Prozent schneller. Alle diese Zahlen sind Herstellerangaben ohne bekannte unabhängige Reproduktion.
Auswirkungen für Entwickler
Die zentrale Auswirkung für Entwickler ist nicht ein weiteres Modell, sondern eine veränderte Granularität der Auswahl: Wer Multimodalität auf dem Gerät wollte, musste bisher ASR, ein Vision-Language-Modell und TTS zu einer Pipeline verketten; nun bietet der Hersteller ein Omni-Einzelmodell an. Dass daneben unimodale Modelle bestehen bleiben, deutet darauf hin, dass die Zusammenführung nicht in jedem Szenario günstiger ist. Auch die Inferenzvorgaben ändern sich: Das Vision-Modell verlangt transformers 5.21.0 oder neuer, Audio- und Omni-Modelle 5.20.2 oder neuer, d1 5.19 oder neuer, und die meisten Beispiele setzen auf trust_remote_code. Framework-Upgrade und Prüfung des benutzerdefinierten Remote-Codes werden damit zur Vorarbeit. Beim Speicher auf Edge-Geräten sind die rund 1 GB des Textmodells in 4-Bit eine planbare Größe; für Vision- und Audiomodelle nennt der Blog jedoch keinen VRAM- oder RAM-Bedarf, sodass der tatsächliche Ressourcenaufwand von Videoeingabe und Streaming-Sprachausgabe selbst gemessen werden muss. Der Blog betont die Effizienz des neuen Vision-Encoders und von LiquidCodec und nennt ein erstes Audio-Token ab 50 ms sowie Sprachsynthese mit rund 87-facher Echtzeit auf einem einzelnen CPU-Thread; solche Werte hängen stark von Hardware und Eingabelänge ab und taugen nicht direkt als Grundlage für Kapazitätsplanung. Der Hersteller stellt zudem Fine-Tuning-Notebooks für SFT, DPO, GRPO und kontinuierliches Pretraining bereit; für Teams mit eigenen Fachbegriffen und Tool-Aufrufen ist das der Teil, der vor den Benchmark-Werten ausprobiert werden sollte.
Integration und Bewertung
Empfehlung 1 (bedingte Analyse): Muss eine Edge-Anwendung Sprache und Bild in derselben Anfrage verarbeiten, vergleichen Sie zuerst das Omni-Einzelmodell mit der Kombination aus Audio- und Vision-Modell. Auslöser ist ein echter modalitätsübergreifender Zusammenhang innerhalb einer Anfrage, etwa eine gesprochene Frage zu einem Bild. Sind Audio und Video fachlich unabhängig, ist die Kontrolle mit spezialisierten Modellen meist besser. Messkriterium: Auf derselben Stichprobe realer Daten Latenz bis zum ersten Token, Gesamtdauer und Speicherspitze vergleichen und prüfen, ob das Omni-Modell bei reinen Text- oder Sprachteilaufgaben gegenüber den Spezialisten deutlich nachlässt. Empfehlung 2 (bedingte Analyse): Wer bereits einen Inferenzdienst auf Basis von LFM2.5 betreibt, sollte nicht allein wegen Herstellerzahlen wie 38,42 gegenüber 3,02 auf WebArena-Verified wechseln, sondern zuerst ein A/B mit eigenen Agenten-Trajektorien fahren. Auslöser ist eine Last, die vor allem aus Tool-Aufrufen mit langem Kontext besteht; laut Blog liegen die Vorteile vor allem bei Agentenaufgaben und langem Kontext, während der Vergleich bei kurzen Prompts parameternormiert ist und keine absolute Gleichwertigkeit bedeutet. Messkriterium: Auf einem eigenen Aufgabensatz Erfolgsquote der Tool-Aufrufe, Formatkonformität und tatsächliche Dauer pro 1.000 Token erfassen, statt nur auf öffentliche Ranglisten zu schauen. Empfehlung 3 (bedingte Analyse): Wer eher an strukturierten Entscheidungen als an Textgenerierung interessiert ist, kann prüfen, ob d1-2B die Kombination aus kleinem Sprachmodell und nachgelagerter Auswertung ersetzt. Voraussetzung ist, dass das Geschäft kalibrierte Wahrscheinlichkeitsausgaben statt natürlicher Sprache akzeptiert; braucht die nachgelagerte Stufe erklärenden Text, passt der d1-Weg nicht. Messkriterium: Mit annotierten historischen Tickets oder Belegen den Kalibrierungsfehler je Feld berechnen und die Latenz eines Vorwärtsdurchlaufs mit der bestehenden Pipeline vergleichen.
Grenzen und offene Fragen
Die Quelle ist ein Herstellerblog; Benchmark-Werte, Geschwindigkeits- und Speicherangaben sind Eigenangaben ohne unabhängige Reproduktion oder vollständige Evaluationsmethodik. Auch die internen Vergleichsmaßstäbe sollten selbst geprüft werden, etwa wenn einige Encoder-Vergleiche denselben LFM2.5-230M-Sprachbackbone nutzen. Der Blog bezeichnet alle LFM3-Modelle als offene Gewichte, nennt aber keine konkreten Lizenzbedingungen; offene Gewichte sind keine Open-Source-Lizenz, und Rechte für kommerzielle Nutzung, Weitergabe und Veröffentlichung nach Fine-Tuning ergeben sich aus Modellkarte und Lizenztext, nicht aus der bloßen Downloadbarkeit. Für die LFM3-Modelle gibt es derzeit keinen Eintrag im Online-Katalog von KimiSeek; diese Version ist dort aktuell nicht gelistet. Der Blog nennt auch keine gehostete API; die genannte Verfügbarkeit meint den Download der Gewichte von Hugging Face und den lokalen Betrieb. Falls später ein Hosting-Dienst oder eigene Preise erscheinen, gelten die offiziellen Seiten. Zudem setzen die Beispiele auf trust_remote_code, dessen Remote-Code in Produktion selbst geprüft werden muss; tatsächliche Qualität und Ressourcenbedarf von Videoeingabe, Sprachstreaming und mehrsprachiger Sprachübersetzung zeigen nur wenige Beispiele im Blog und sind selbst zu verifizieren.
Abbildungen aus dem Originalbericht