Meta gibt Muse Spark Open als offene Gewichte frei: 816-Milliarden-Parameter-MoE lokal auf zwei Mac Studio
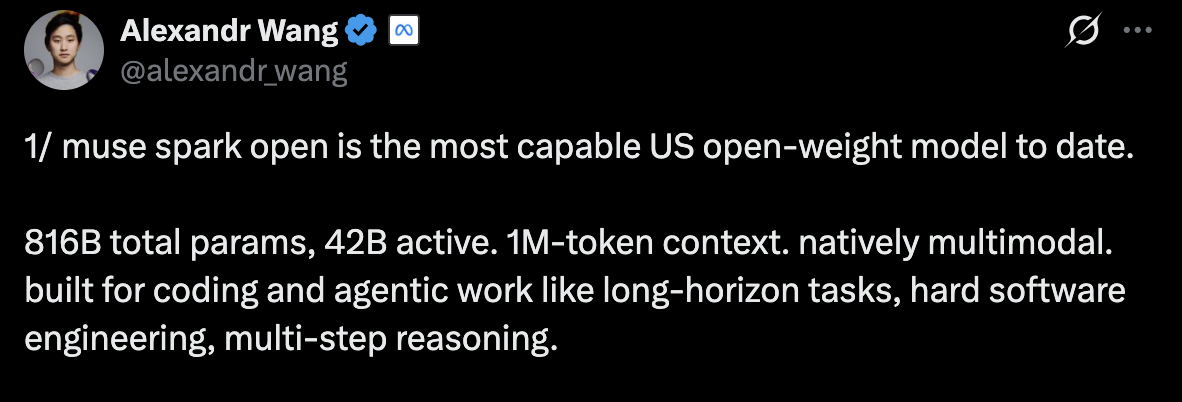
Laut einem InfoQ-Bericht vom 18. Oktober 2026 hat Meta am 15. Oktober die Gewichte von Muse Spark Open freigegeben: ein sparses MoE mit 816 Milliarden Gesamtparametern und rund 42 Milliarden aktiven Parametern, Kontext bis etwa 1,05 Millionen Token sowie Text-, Bild-, Audio- und Videoeingabe, lokal einsetzbar via MLX auf zwei M5-Ultra-Mac-Studio-Systemen; die Terminal-Bench-2.1- und DeepSWE-1.1-Ergebnisse liegen dem Bericht zufolge unter GLM 5.3 max und Kimi K3 max, die Lizenz ist die Muse Model License.
Was sich geändert hat
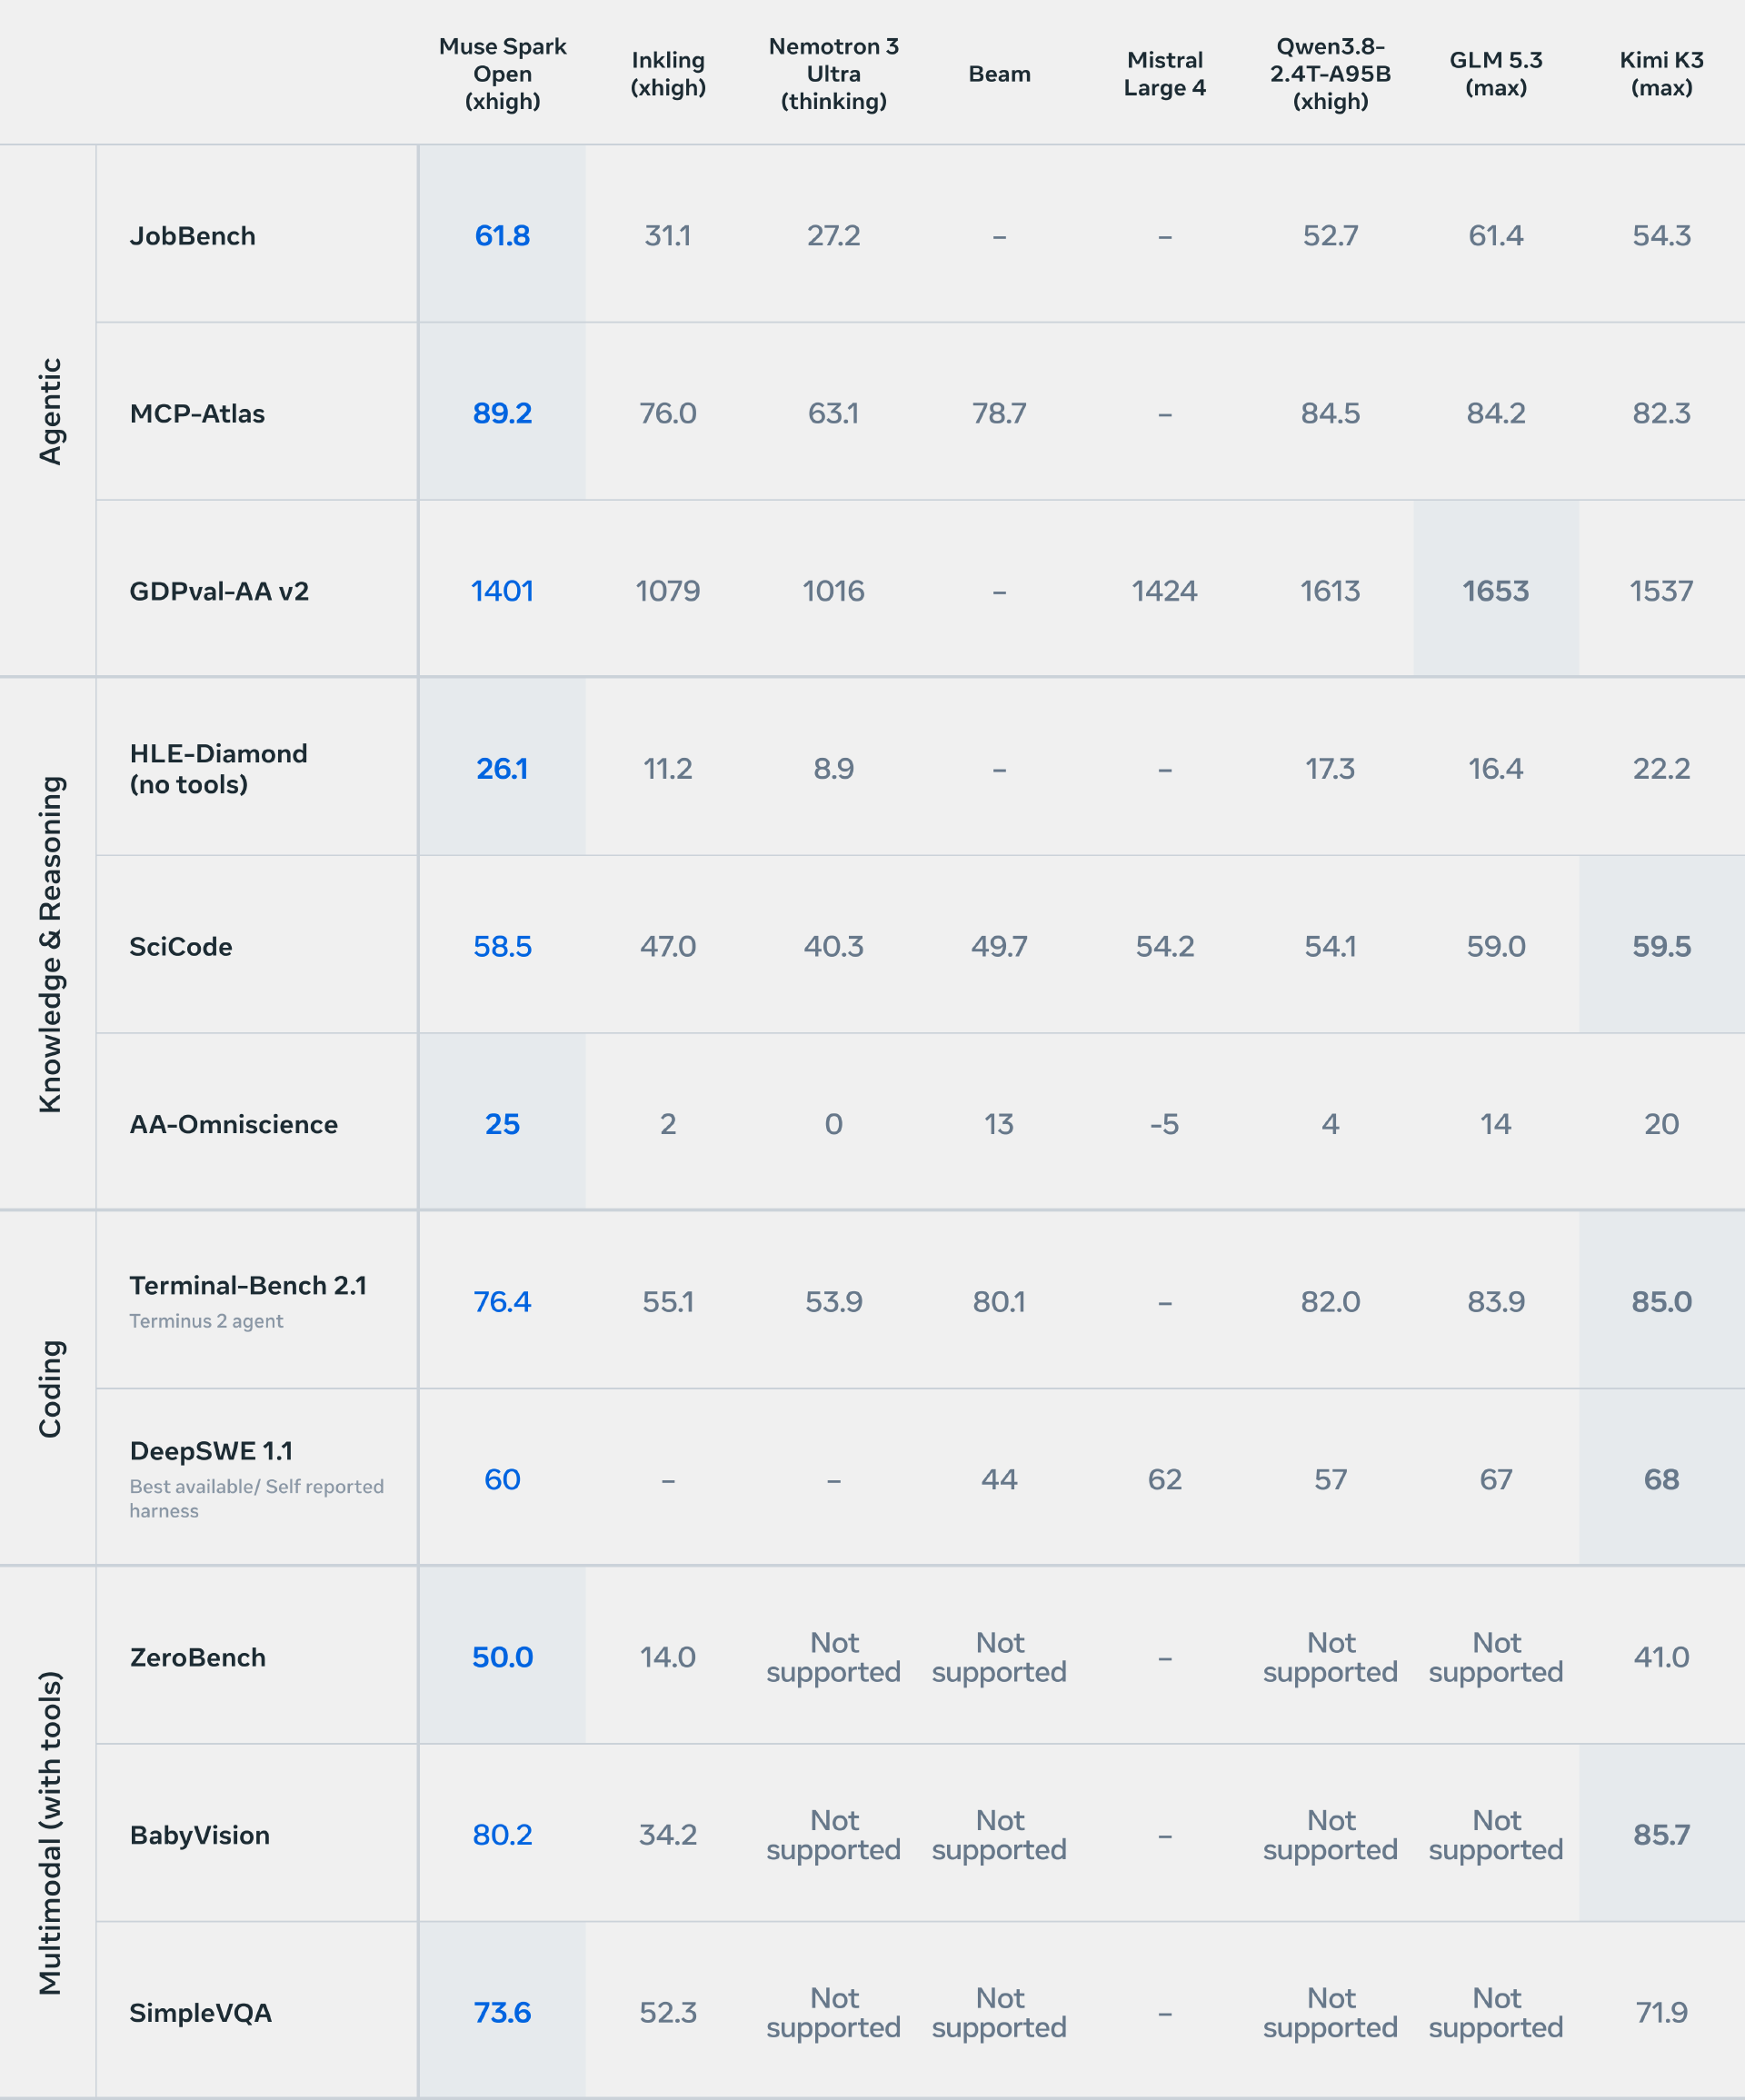
Laut einem InfoQ-Bericht vom 18. Oktober 2026 hat Meta am 15. Oktober Ortszeit die Freigabe der Modellgewichte von Muse Spark Open angekündigt, positioniert als großes Agentenmodell für Software-Engineering, langfristige Aufgabenausführung und mehrstufiges Schlussfolgern; Meta bezeichnet es laut Bericht als sein bislang leistungsfähigstes offenes US-Gewichtsmodell. Das Modell nutzt eine sparse Mixture-of-Experts-Architektur mit 816 Milliarden Gesamtparametern, pro Token rund 42 Milliarden aktive Parameter, einem Kontext von 1.048.576 Token, Eingaben aus Text, Bild, Audio und Video und Text als Ausgabe. Dem Bericht zufolge nennt Meta JobBench 61,8, MCP-Atlas 89,2 und OSWorld Verified 80,4; programmierbezogen 76,4 bei Terminal-Bench 2.1 und 60 bei DeepSWE 1.1, wobei die letzten beiden unter den chinesischen offenen Modellen GLM 5.3 max und Kimi K3 max liegen. Der lokale Betrieb erfolgt via MLX auf zwei Mac-Studio-Systemen mit M5 Ultra; Apple nennt laut Bericht über 36 Token pro Sekunde in einem verteilten Test mit vier Maschinen. Die offizielle Dokumentation gibt rund 1,65 TB für BF16-Gewichte und rund 537 GB für NVFP4 an. Die Lizenz ist die Muse Model License: Sie verlangt eine bestimmte Attributionskennzeichnung und für Lizenznehmer mit einem Gesamtjahresumsatz über 20 Millionen US-Dollar, die das Modell als Model-as-a-Service anbieten, eine Benachrichtigung und eine separate schriftliche Vereinbarung; zugleich nennt sie Ausnahmen für interne Nutzung und Forschung.
Auswirkungen für Entwickler
Für Entwickler bedeutet die Veröffentlichung nicht in erster Linie „ein weiteres herunterladbares Gewicht“, sondern zerlegt die Entscheidungsvariablen großer Modell-Deployments von der Parameterzahl in drei Punkte: Gewichtsspeicherung, Rechenaufwand pro Token und geräteübergreifende Kommunikation. Die Unterscheidung zwischen 816 Milliarden Gesamtparametern und rund 42 Milliarden aktiven Parametern ist laut Bericht entscheidend – erstere bestimmen, ob es passt, letztere, ob es rechenbar ist. Nach den im Bericht genannten Angaben erfordern rund 1,65 TB in BF16 acht B300, rund 537 GB in NVFP4 vier B300, und Apples Test nutzte NVFP4 statt BF16; das heißt, Quantisierung und Mehrrechner-Parallelität sind Voraussetzungen für ein Desktop-Deployment, keine der beiden erklärt das Ergebnis allein. Zugleich verschmelzen zwei Macs mit je 512 GB Speicher nicht zu einer Maschine mit rund 1 TB einheitlich adressiertem Speicher; maschinenübergreifend sind RDMA und MLX-Kollektivkommunikation nötig, weshalb der Skalierungsnutzen durch die Kommunikation begrenzt wird. Für Teams, die GLM 5.3 max oder Kimi K3 max bereits für Coding und langfristige Aufgaben einsetzen, bietet der Vergleich einen Kandidaten zum Ersetzen oder Ergänzen; der Bericht erinnert aber daran, dass Muse Spark Open bei Terminal-Bench 2.1 und DeepSWE 1.1 nicht führt und dass die offiziellen Demos (Ice-Cubes-iOS-Entwicklung, Frame-für-Frame-Auswahl in DaVinci Resolve) Herstellerpräsentationen sind und nicht auf unbeaufsichtigte Bewältigung gleichartiger Aufgaben verallgemeinert werden dürfen.
Integration und Bewertung
Das Folgende sind auf dem Bericht basierende Empfehlungen und Bedingungsanalysen, keine verifizierten Fakten. Erstens: Wenn Ihre Workload aus langfristigen Tool-Aufrufen besteht und Daten das lokale System nicht verlassen dürfen, können Sie Muse Spark Open zunächst über eine gehostete API auf seine Aufgabenabschlussrate prüfen und dann über Selfhosting entscheiden; im Bericht genannte Ökosystempartner sind Baseten, Fireworks AI, Groq, Modal, Nebius, Together AI und OpenRouter, die Deployment-Werkzeuge umfassen SGLang, vLLM, TensorRT-LLM, llama.cpp und MLX. Die Bedingung für oder gegen Selfhosting ist, ob Sie bereits NVFP4-fähige Beschleuniger oder zwei Macs mit großem Speicher haben; messbar sind die End-to-End-Erfolgsrate und die Latenzdifferenz pro Aufgabe für dieselbe Menge realer Tool-Aufrufe auf gehosteter API versus lokaler Inferenz. Zweitens: Bei der Abwägung zwischen NVFP4 und BF16 nennt der Bericht als Prämisse rund 537 GB für NVFP4 und rund 1,65 TB für BF16; reicht Ihr Grafikspeicher oder Unified Memory nicht, müssen Sie NVFP4 wählen, um den Preis, die Stabilität langer Kontexte nach der Quantisierung zu prüfen; messbar ist, wie stark die Informationsrückgewinnungsgenauigkeit nahe 1,05 Millionen Token und die Tool-Aufruf-Erfolgsrate gegenüber BF16 sinken. Drittens: Wenn Sie Dritten Model-as-a-Service anbieten und Ihr Gesamtjahresumsatz die im Bericht genannte Schwelle von 20 Millionen US-Dollar überschreiten könnte, sollten Sie vor dem produktiven Einsatz des Modells oder abgeleiteter Modelle klären, ob Benachrichtigung und separate schriftliche Vereinbarung gelten, und prüfen, ob Ausnahmen für interne Nutzung, Forschung und eigene Nicht-MaaS-Produkte Ihren Fall abdecken; das ist eine Lizenzfrage und erfordert juristische, nicht technische Beurteilung. Viertens: Wenn Sie mit mehreren Macs skalieren wollen, schätzen Sie die nutzbare Kapazität nicht als Summe des Maschinenspeichers; der Bericht nennt die maschinenübergreifende Kommunikation als eigenen Engpass; messbar ist, ob der Zuwachs der Token-Generierungsgeschwindigkeit bei Zwei- und Vier-Maschinen-Konfigurationen linear mit der Maschinenzahl skaliert.
Grenzen und offene Fragen
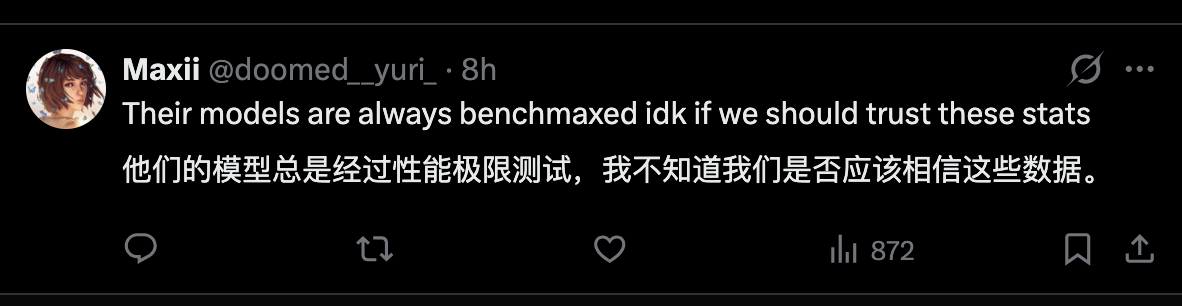
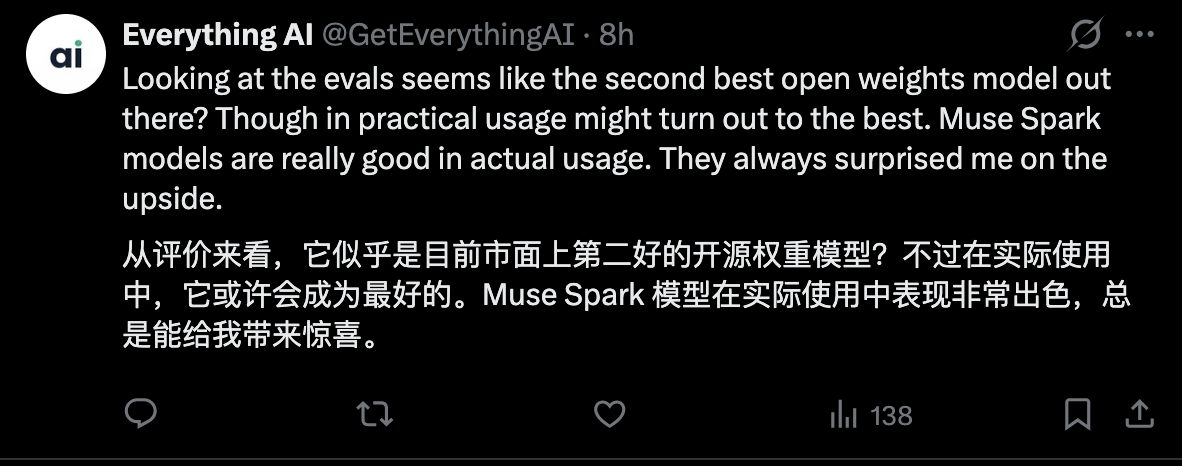
Klarzustellen ist: Muse Spark Open und seine Version 816B-A42B erscheinen derzeit nicht im Echtzeit-Modellkatalog dieser Site, und es gibt hier keinen Eintrag für das Modell; die genannte gehostete und API-Verfügbarkeit bezieht sich daher auf den Hersteller und die von ihm genannten Drittanbieter, nicht auf eine hier aufrufbare Möglichkeit. Alle im Bericht genannten Benchmarkwerte, Gewichtsgrößen, Hardwarekonfigurationen und Lizenzbedingungen stammen aus offiziellen Meta-Angaben und der InfoQ-Wiedergabe; dieses Dokument hat sie weder unabhängig reproduziert noch selbst getestet. Die Community hat Vorbehalte gegenüber der Aussagekraft von Ranglistenergebnissen, die im Bericht zitiert werden. Offene Gewichte bedeuten nicht keine kommerziellen Bedingungen; die Attributionskennzeichnung und die Umsatzschwellenklausel der Muse Model License sind im Original Punkt für Punkt zu prüfen; der Bericht stellt ausdrücklich fest, dass Ausnahmen für interne Nutzung und Forschung bestehen, was nicht zu „alle umsatzstarken Unternehmen zahlen“ verkürzt werden darf. Die im Bericht genannten Angaben zu 1,03- bis 3,95-facher Beschleunigung auf Operatorebene und rund 3 % End-to-End-Beschleunigung auf AMD MI350 betreffen zwei unterschiedliche Ebenen und dürfen nicht zu einer allgemeinen Inferenzgeschwindigkeitssteigerung verallgemeinert werden. Offizielle Demos und Personenaussagen sind Drittanbieteraussagen und kein Beleg für unbeaufsichtigte Fähigkeiten. Zudem bedeutet die Unterstützung von Video- und Audioeingabe nur Verständnisfähigkeit, nicht native Generierungsfähigkeit; lokales Deployment verringert die Notwendigkeit, Daten nach außen zu geben, liefert aber nicht automatisch Sicherheitsprüfungen und Zugriffskontrollen einer gehosteten Dienstleistung – erhält ein Agent zu weitreichende Datei- und Kommandorechte, sind Fehländerungen oder Datenverlust weiterhin möglich.
Abbildungen aus dem Originalbericht