Nemotron 3.5 Super VL auf SageMaker JumpStart: Modellkarte nennt 1 Mio. Token Kontext, Endpunkt nur bis 15.600
Ein AWS-Blogbeitrag vom 9. November kündigt NVIDIA Nemotron 3.5 Super VL in SageMaker JumpStart an, in zwei Varianten: NVFP4 und BF16. 120B Gesamtparameter, 12B aktiv, Gewichte unter OpenMDW 1.1; die Servicekonfiguration des gehosteten Endpunkts begrenzt den Kontext jedoch auf 520 bis 15.600 Token.
Was sich geändert hat
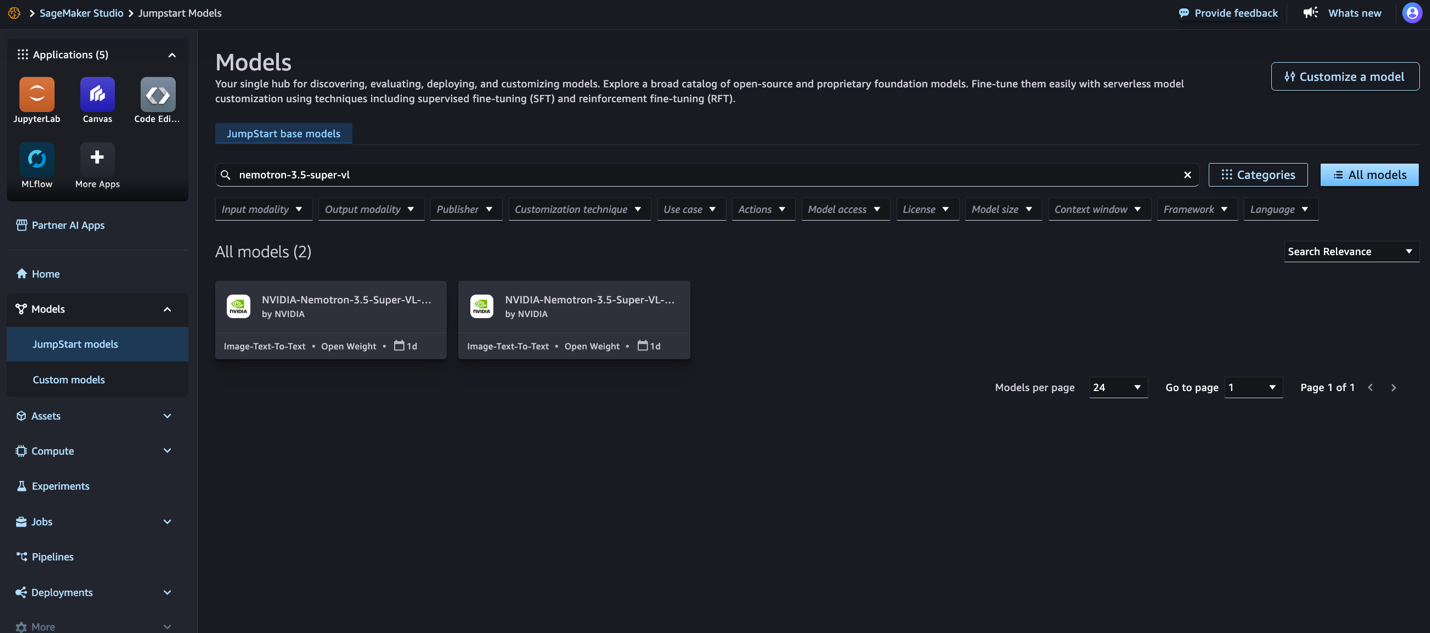
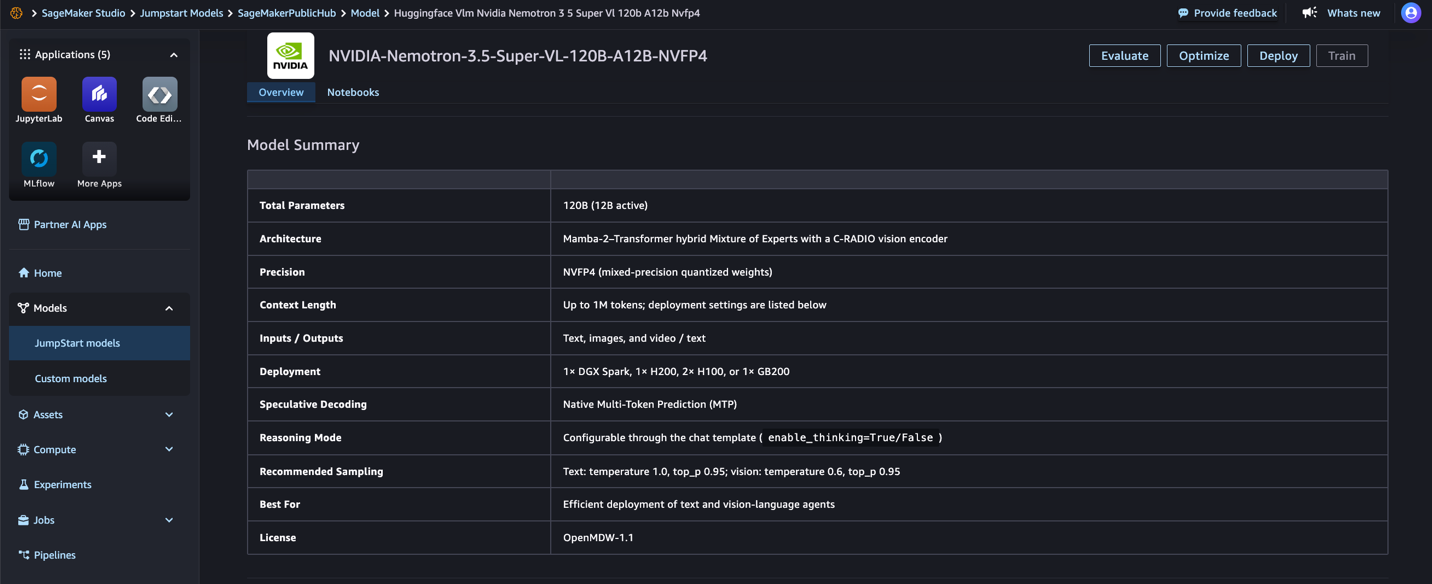
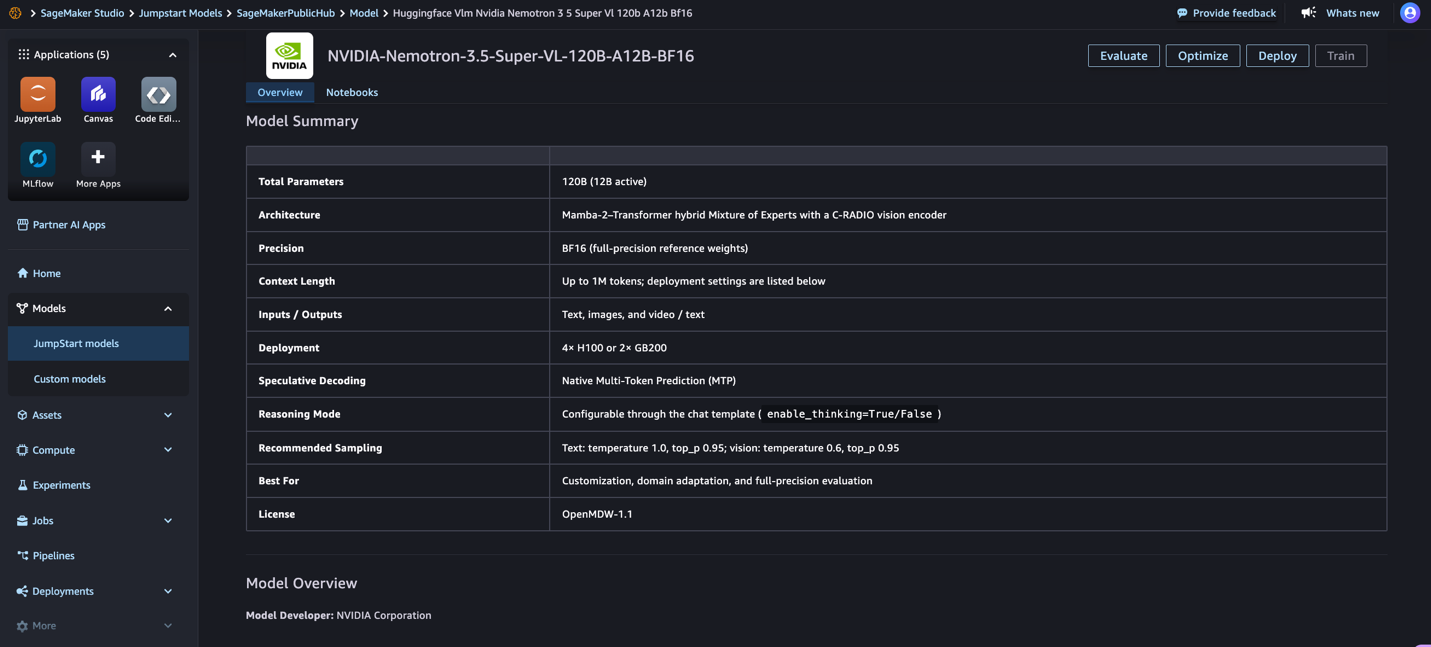
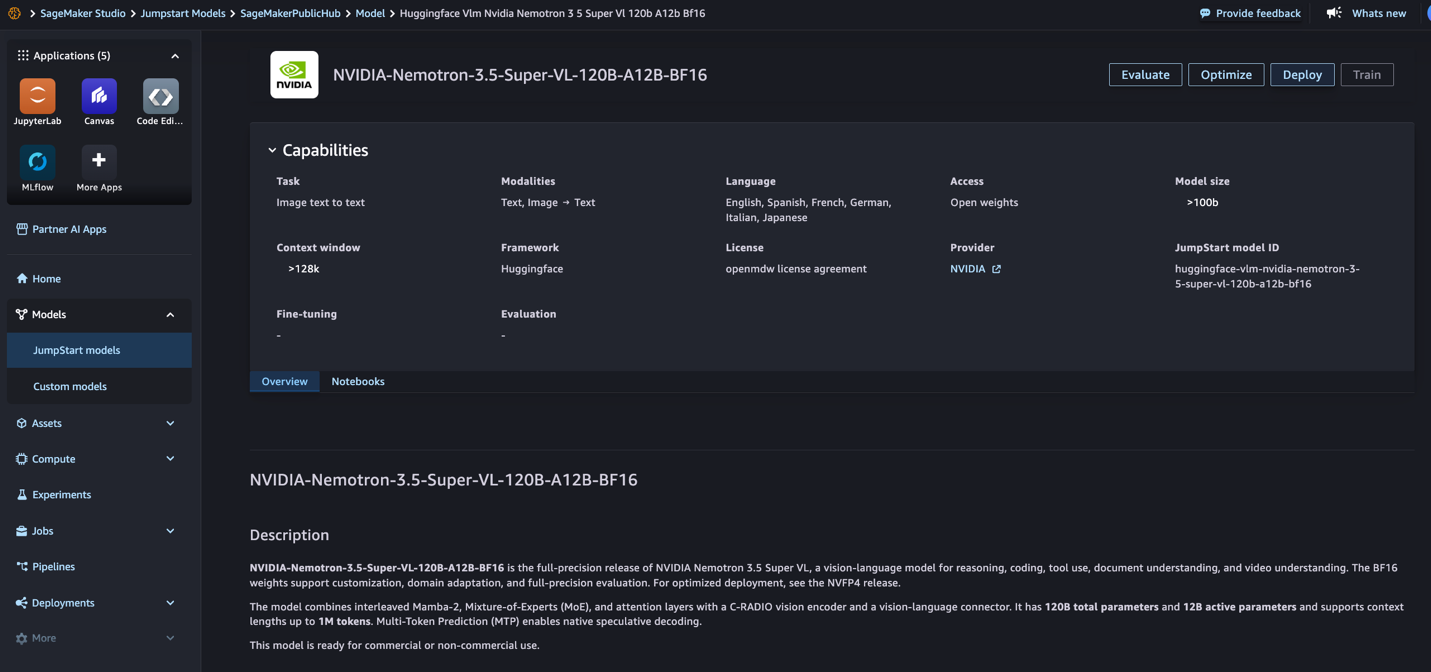
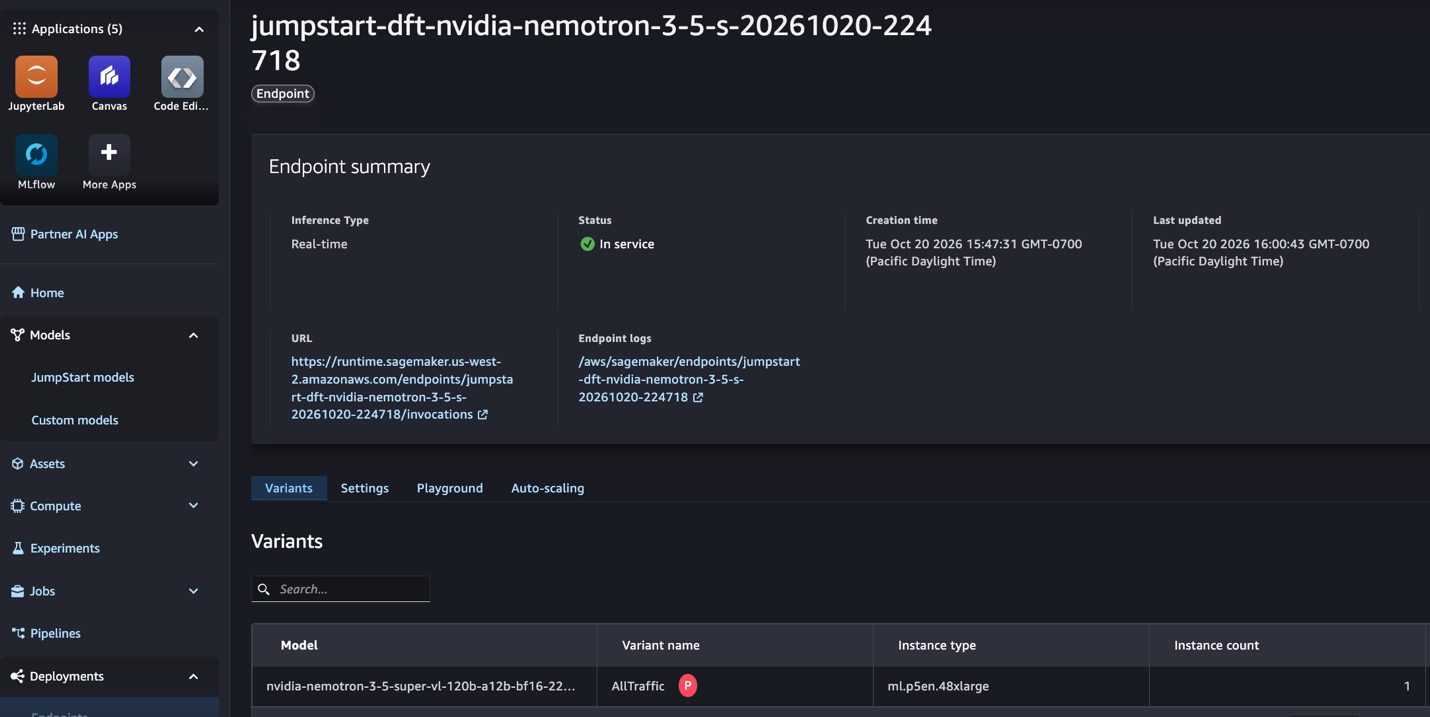
Laut einem am 9. November 2026 veröffentlichten AWS-Blogbeitrag (Autoren: Venu Kanamatareddy, Evan Kravitz, Naidile Murali) ist NVIDIA Nemotron 3.5 Super VL in Amazon SageMaker JumpStart verfügbar. Dem Beitrag zufolge ist das Modell ein Vision-Language-Modell der Nemotron-3.5-Reihe, das Bild-, Video- und Texteingaben akzeptiert und Text ausgibt; das Sprach-Backbone hat 120B Gesamtparameter und aktiviert pro Token 12B: 88 Schichten als abwechselnde Stapel aus Mamba-2 und MoE (512 geroutete Experten, 22 pro Token aktiv), dazwischen 8 Attention-Schichten; das Backbone wurde von Nemotron 3 Super Base initialisiert und von Nemotron 3 Ultra Base destilliert, auf der Bildseite kommt ein C-RADIO-Encoder zum Einsatz. JumpStart bietet zwei Varianten: NVFP4 entsteht per quantisierungsbewusster Destillation aus BF16, umfasst etwa 75 GB, läuft auf G7-Instanzen mit RTX PRO 4500 Blackwell und rechnet mit 4-Bit-Gewichten und -Aktivierungen; BF16 sind die Referenzgewichte in voller Präzision, etwa 249 GB, auf 8 H200 einer ml.p5en.48xlarge. Die Gewichte werden unter der OpenMDW-Lizenz 1.1 bereitgestellt; unterstützt werden Englisch, Französisch, Deutsch, Italienisch, Japanisch, Spanisch und Chinesisch. Der Beitrag nennt bis zu 1 Mio. Token Kontext, doch die JumpStart-Servicekonfiguration reicht nur bis 520 bis 15.600 Token; der Checkpoint bringt einen Multi-Token-Vorhersagekopf mit, die JumpStart-Servicekonfiguration aktiviert jedoch kein spekulatives Decoding, und der Endpunkt lädt auch keine LoRA-Adapter.
Auswirkungen für Entwickler
Die erste Auswirkung für Entwickler betrifft die Schnittstellenform. Laut Beitrag stellt der JumpStart-Endpunkt eine vLLM-basierte Chat-Completions-Schnittstelle bereit; Reasoning ist standardmäßig aktiv, und Denkinhalte werden im Feld reasoning der Nachricht getrennt von content zurückgegeben. Bestehende Clients, die nur ein einzelnes content-Feld auswerten, müssen also angepasst werden, sonst verlieren sie den eigentlichen Text oder halten den Reasoning-Verlauf für den Text. Medien müssen als base64-Data-URL inline gesendet werden, da der Endpunkt netzwerkisoliert ist und keine URLs abrufen kann; das erhöht den Request-Body deutlich und macht Ansätze wie „einfach einen Link schicken, das Modell lädt selbst“ unmöglich. Die zweite Auswirkung betrifft die Kapazitätsplanung. Die Modellkarte nennt bis zu 1 Mio. Token Kontext, die Servicekonfiguration des gehosteten Endpunkts erlaubt aber tatsächlich nur 520 bis 15.600 Token, und pro Anfrage wird nur ein Bild und ein Video akzeptiert. Ein Seitenbild mit 1.536×1.024 verbraucht etwa 1.536 Token; der Beitrag sagt zudem ausdrücklich, dass das Modell Bilder statt roher PDFs entgegennimmt, sodass jede Seite zuerst als Bild gerendert werden muss. Daraus folgt: Ein PDF mit mehreren Dutzend Seiten lässt sich auf diesem gehosteten Pfad nicht in einem Zug übergeben, sondern nur seitenweise anfragen oder als ein zusammengesetztes Bild innerhalb des Kontextbudgets unterbringen. Die dritte Auswirkung betrifft die Latenzerwartung. Laut Messung im Beitrag erreicht NVFP4 auf G7 in der generate-Konfiguration (250 Eingabe-Token, 1.500 Ausgabe-Token, 5 parallele Streaming-Ströme) etwa 63 Token/s pro Anfrage und etwa 0,45 s bis zum ersten Token; dieselbe g7.24xlarge braucht in der summarize-Konfiguration mit 10.000 Eingabe-Token jedoch 12,62 s bis zum ersten Token. Bild- und Videoanfragen liegen üblicherweise auf der Seite langer Prompts; wer das Modell als interaktiven GUI-Agenten einsetzen will, sollte diese Größenordnung beim ersten Token vorher messen. Zur Qualität zitiert der Beitrag fünf multimodale Benchmarks aus der NVIDIA-Modellkarte (mit aktivem Reasoning): MMLongBench-Doc 62,82 zu 62,82, OCRBench v2 Englisch 68,12 zu 68,34, CharXiv reasoning 80,82 zu 79,88, Video-MME v2 32,85 zu 32,54, OSWorld-Verified 51,14 zu 52,30; erster Wert jeweils BF16, zweiter NVFP4. Der Beitrag gibt an, die Evaluierungseinstellungen seien identisch, nur der Checkpoint unterscheide sich. Es sind Herstellerangaben ohne bekannte unabhängige Reproduktion.
Integration und Bewertung
Die folgenden drei Punkte sind bedingte Empfehlungen auf Basis der berichteten Fakten, keine verifizierten Schlussfolgerungen. Erstens: zuerst die Variante festlegen. Die berichtete Änderung ist, dass JumpStart beide Checkpoints anbietet, NVFP4 als Standard mit Einstieg auf ml.g7.24xlarge, BF16 nur auf ml.p5en.48xlarge. Die Entscheidung: Für reinen Inferenzbetrieb zunächst NVFP4; erst wenn SFT, Reinforcement Learning, Destillation, Domänenanpassung oder eigene Quantisierung geplant sind, die BF16-Referenzgewichte herunterladen und selbst betreiben. Die entscheidende Voraussetzung ist der Fine-Tuning-Bedarf: Der Beitrag sagt ausdrücklich, der Endpunkt biete nur Basisgewichte und lade keine LoRA-Adapter; hängt das Vorhaben an LoRA-Hot-Swap, ist der gehostete Pfad nicht gangbar. Ein messbares Kriterium: mit eigenen Dokument-Screenshots und Videosegmenten beide Checkpoints auf denselben Eingaben laufen lassen, die Differenz bei Aufgaben-genauigkeit und JSON-Konformität vergleichen und die akzeptable Differenz nicht über dem Fehlerniveau der bestehenden manuellen Prüfquote ansetzen. Zweitens: erst die Servicekonfiguration festlegen, dann über Kontext sprechen. Die berichtete Änderung ist, dass inference_config_name die Modelllänge bestimmt: generate 2.275, interact 520, summarize 13.650, modify 15.600 Token; die Bild-, Video- und Reasoning-Beispiele im Beitrag nutzen durchgängig modify. Die Wahl: Anfragen mit Bildern, Videos oder mehrstufigem Reasoning über modify, kurze Textextraktion über generate, und anhand von „eine Seite etwa 1.536 Token“ abschätzen, wie viele Seiten pro Anfrage hineinpassen. Voraussetzung ist, dass mehrseitige Dokumente auf mehrere Anfragen verteilt oder zu einem Bild zusammengesetzt werden. Messbares Kriterium: vor dem Start die Ablehnungsquote wegen Überschreitung der Länge und die p95-Zeit bis zum ersten Token erfassen und den Referenzwert von 12,62 s bei 10.000 Eingabe-Token als Untergrenze für das Latenzbudget heranziehen. Drittens: erst den Reasoning-Schalter festlegen. Die berichtete Änderung ist, dass Reasoning standardmäßig aktiv ist, Denkinhalte separat zurückkommen und für Videoanfragen mit Reasoning mindestens 8.192 max_tokens empfohlen werden. Die Wahl: Aufgaben mit kurzer, direkter Antwort wie Feldextraktion aus Tickets oder Bildbeschreibung mit enable_thinking=False abschalten, mehrstufige Analyse und GUI-Lokalisierung eingeschaltet lassen. Voraussetzung für die Entscheidung ist, ob die Aufgabe wirklich Zwischenschritte braucht. Messbares Kriterium: auf derselben Stichprobe Genauigkeit der Feldextraktion, Anzahl ausgegebener Token und Ende-zu-Ende-Latenz mit und ohne Reasoning vergleichen und prüfen, ob die eingesparten Token einen akzeptablen Genauigkeitsverlust erkaufen. Vor dem Deployment außerdem das ml.g7-Kontingent prüfen (bei neuen Konten anfangs null) und das SageMaker Python SDK mindestens in Version 3.25 verwenden sowie den Instanztyp explizit übergeben, da das SDK sonst auf ml.m5.large zurückfällt und der Aufbau fehlschlägt.
Grenzen und offene Fragen
Nemotron 3.5 Super VL ist derzeit nicht im Modellkatalog von KimiSeek. Die berichtete Verfügbarkeit bezieht sich auf AWS SageMaker JumpStart, also einen gehosteten Dienst des Anbieters, nicht auf ein hier bereits gelistetes Modell. Auch die übrigen Unbekannten bleiben bestehen: Die fünf genannten Benchmarks stammen aus der NVIDIA-Modellkarte und sind Herstellerangaben; der Beitrag selbst merkt an, dass die Leistungswerte für NVFP4 und BF16 auf unterschiedlichen GPU-Systemen und Konfigurationen gemessen wurden und kein isolierter Präzisionsvergleich sind, sodass aus 63 Token/s und 140,85 Token/s nicht direkt auf Quantisierungsverluste geschlossen werden kann. Der auf der Modellkarte genannte Kontext von 1 Mio. Token wird am gehosteten Endpunkt nicht exponiert; die tatsächliche Obergrenze hängt von der Servicekonfiguration ab. Die Video-Frame-Samplingrate wird beim Start des Endpunkts festgelegt, und der Endpunkt lehnt media_io_kwargs pro Anfrage ab; wer das Sampling pro Anfrage steuern will, muss selbst betreiben. Die Gewichte stehen unter der OpenMDW-Lizenz 1.1; offene Gewichte sind nicht gleich eine Open-Source-Lizenz, die Bedingungen zu kommerzieller Nutzung, Weitergabe und abgeleiteten Modellen sind im Lizenztext nachzulesen. Der Quelltext nennt keine Preise; die Kosten richten sich nach der gewählten Instanz, maßgeblich ist die AWS-SageMaker-Preisseite. Chinesisch steht zwar auf der Liste der unterstützten Sprachen, der Quelltext liefert aber keine Benchmarkdaten für chinesische Szenarien.
Abbildungen aus dem Originalbericht